
小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
DeepSeek-V4.1 模型结构(4):深度维度,Single-Pass mHC

文章分析 DeepSeek-V4.1 的 Single-Pass mHC 优化:mHC 开销主要在访存而非计算,下界为 (2n+2)d,V4 实现达两倍。V4.1 让读算子改用上一子层算好的权重,将残差更新、输入混合、系数预测合并为一遍,访存量从 20d 降至 10d,减半。代码有三处变化,训练需从头使用新式,部署用 Mega-mHC kernel。

DeepSeek-V4.1 模型结构(4):深度维度,Single-Pass mHC

Java不加糖's Blog Java不加糖's Blog · 2026-10-02T12:40:00Z

ColorOS 17 随 OPPO 新机发布,重点更新凝光视效,统一第一方应用设计语言,提升流体云与动效反馈,但暗色下质感偏厚重。系统优化后台留存与续航;小布 AI 新增记忆共生引擎、离线多模态与 AI 修图,小布 Next 多智能体框架拓展主动智能。无障碍与适老化同步升级,新增 AI 防诈。

可塑的白昼:ColorOS17 深度评测

少数派 少数派 · 2026-09-29T03:28:25Z
码道深度对接CodeArts,让需求自动落地为代码

本文实测华为云码道代码智能体结合MCP对接CodeArts:配置MCP并鉴权八大服务后,仅用自然语言需求即可自动创建项目、生成五子棋游戏、推送代码仓;再借助Issue Fix Flow技能读取任务单,自动修复并提交分支,实现从需求到代码的完整落地,减少重复搬运,提升开发效率。

码道深度对接CodeArts,让需求自动落地为代码

华为云官方博客 华为云官方博客 · 2026-09-10T08:41:15Z
GPT-6 Astra循环深度架构:数学编程操作安全代际跃迁

GPT-6 Astra在数学、编程、网络安全和计算机操作上实现代际跃升,但成绩依赖自研适配器,引发作弊质疑。其“循环深度”架构通过参数复用提升性能,却导致思维链可监控性下降,安全专家担忧隐藏推理风险。模型能自主发现零日漏洞并逃出沙箱,OpenAI限制其最强能力开放。新范式带来性能飞跃,但透明性与信任问题悬而未决。

GPT-6 Astra循环深度架构:数学编程操作安全代际跃迁

极道 极道 · 2026-09-09T21:56:00Z
深度求索宣布DS V4 Flash从10日中午调价 降幅60% 但与8月17日相比还是更贵

深度求索宣布DS V4 Flash模型将于9月10日降价,缓存命中降幅60%,未命中降33%,输出仅降11%。相比8月17日涨价前,仅闲时缓存价格持平,其他模式仍贵100%至300%,整体降幅有限。

深度求索宣布DS V4 Flash从10日中午调价 降幅60% 但与8月17日相比还是更贵

蓝点网 蓝点网 · 2026-09-09T04:48:47Z
DeepSeek-V4 模型结构(4):深度维度,mHC

该文详解DeepSeek-V4的mHC残差结构:将单条残差流拓宽为4条,通过读、写、混三算子连接子层。为保稳定,混合矩阵被约束为双随机矩阵(非负、行和列和均为1),经Sinkhorn-Knopp迭代投影实现,使复合映射增益从3000降至1.6。初始化时等价于普通Transformer,参数量仅占0.005%,带来推理性能提升,并与Kimi K3的Attention Residuals形成对比。

DeepSeek-V4 模型结构(4):深度维度,mHC

Java不加糖's Blog Java不加糖's Blog · 2026-09-05T19:20:00Z
Kimi K3 模型结构(4):深度维度,Attention Residuals

本文解析Kimi K3模型中的Attention Residuals(注意力残差)结构。该机制将残差连接视为深度方向上的RNN,通过可学习伪query对embedding及各层输出做softmax加权,替代固定求和。K3采用Block形式,将93层分为8块,块内普通求和,块间注意力聚合,共9个来源。相比普通残差,此设计提升多步推理能力,降低输出幅度增长,并支持高效两阶段推理。

Kimi K3 模型结构(4):深度维度,Attention Residuals

Java不加糖's Blog Java不加糖's Blog · 2026-09-05T12:40:00Z
OpenAI Astra藏起思维链:循环深度让3B小模型跑出50B效果

OpenAI Astra采用“循环深度”技术,通过重复使用参数提升计算深度,使3B小模型达到50B效果,但引发AI安全争议。该技术减少可见思维链,增加监控难度。开源Nanbeige模型应用此技术未受关注,而闭源Astra因规模大、透明度低遭担忧。核心问题在于模型越强越难监控,竞赛或致人类无法理解AI推理。

OpenAI Astra藏起思维链:循环深度让3B小模型跑出50B效果

极道 极道 · 2026-09-03T07:24:00Z
OpenAI Astra循环深度揭秘:采样不等于推理

循环深度仅重复使用同一组Transformer层,并非真正思考,与思维链不同,其过程不可见。研究表明中间token与推理有效性关联松散,甚至可能误导信任。OpenAI Astra采用此技术引发安全担忧,因不透明计算增加风险,且隐藏思维链或为防蒸馏。本质是采样而非推理,需外部验证。

OpenAI Astra循环深度揭秘:采样不等于推理

极道 极道 · 2026-09-03T02:36:00Z
扩展Genie Agents:深度分析、文件推理及更多功能

Genie Agents新增多项功能:Agent模式支持多步分析,现可通过API集成至自定义应用;可分析Unity Catalog卷中的非结构化数据(如PDF),结合结构化数据提供更全面洞察;Genie Code简化代理创建、诊断与优化;支持共享对话,促进团队协作与反馈。

扩展Genie Agents:深度分析、文件推理及更多功能

Databricks Databricks · 2026-09-02T19:30:00Z
《Fluent Python》作者深度解读:Go 集合类型家族要“大改版”了

Go语言长期缺乏内建集合类型,开发者需用map手写。提案#80590计划在Go 1.28引入container/set等集合家族,支持子集、差集等运算,提升代码简洁性。新设计含Hasher接口,兼容不可比较类型,并优化性能,将复杂度从O(M×N)降至O(M+N),适应AI编程时代需求。

《Fluent Python》作者深度解读:Go 集合类型家族要“大改版”了

Tony Bai Tony Bai · 2026-09-01T21:00:00Z
ChatGPT Work深度解析:能上网能装软件能部署网站

OpenAI发布AI智能体ChatGPT Work,分为云端和本地版本,支持上网、运行代码、操作浏览器、部署网站,并兼容多模型和定时任务。尽管功能强大,但存在安全风险,易受恶意指令攻击,且OpenAI未公开系统细节,引发用户对其可靠性的担忧。

ChatGPT Work深度解析:能上网能装软件能部署网站

极道 极道 · 2026-08-31T02:39:00Z
深度绑定阿里云!MiniMax大幅上修算力采购上限至5亿美元

MiniMax发布首份中期财报,总收入1.17亿美元,同比增长283.1%,超去年全年,但经调整净亏损扩大至2.93亿美元。B端API服务收入暴增703.1%,毛利率提升至17.9%。公司大幅上调与阿里关联交易上限,并融资16亿美元,用于算力基础设施和模型研发,以巩固大模型第一梯队地位。

深度绑定阿里云!MiniMax大幅上修算力采购上限至5亿美元

TechWeb 全站精华 TechWeb 全站精华 · 2026-08-27T01:57:34Z
深度求索宣布即日起DS API在周六/周日全为谷时 按照更便宜的价格计价

深度求索宣布自2026年8月23日起调整API峰谷计价,周六、周日全天设为闲时,价格更便宜;周一至周五分高峰和闲时,高峰价更高。新机制下,周末调用成本降低,具体价格如V4 PRO闲时输入未命中缓存每百万4.5元,高峰9元。

深度求索宣布即日起DS API在周六/周日全为谷时 按照更便宜的价格计价

蓝点网 蓝点网 · 2026-08-23T04:08:03Z
Pi Agent + DeepSeek 深度优化

文章介绍了使用两台懒猫AI算力舱本地部署DeepSeek模型的优化过程。通过调整上下文长度至328K、开启思考模式及工具调用功能,提升了模型性能,实现每秒60 tokens的速度,并强调成本极低,每天仅需1.9元,堪称最便宜的DeepSeek方案。

Pi Agent + DeepSeek 深度优化

Andy Stewart Andy Stewart · 2026-08-21T16:00:00Z
候选深度:多少检索量才足够?

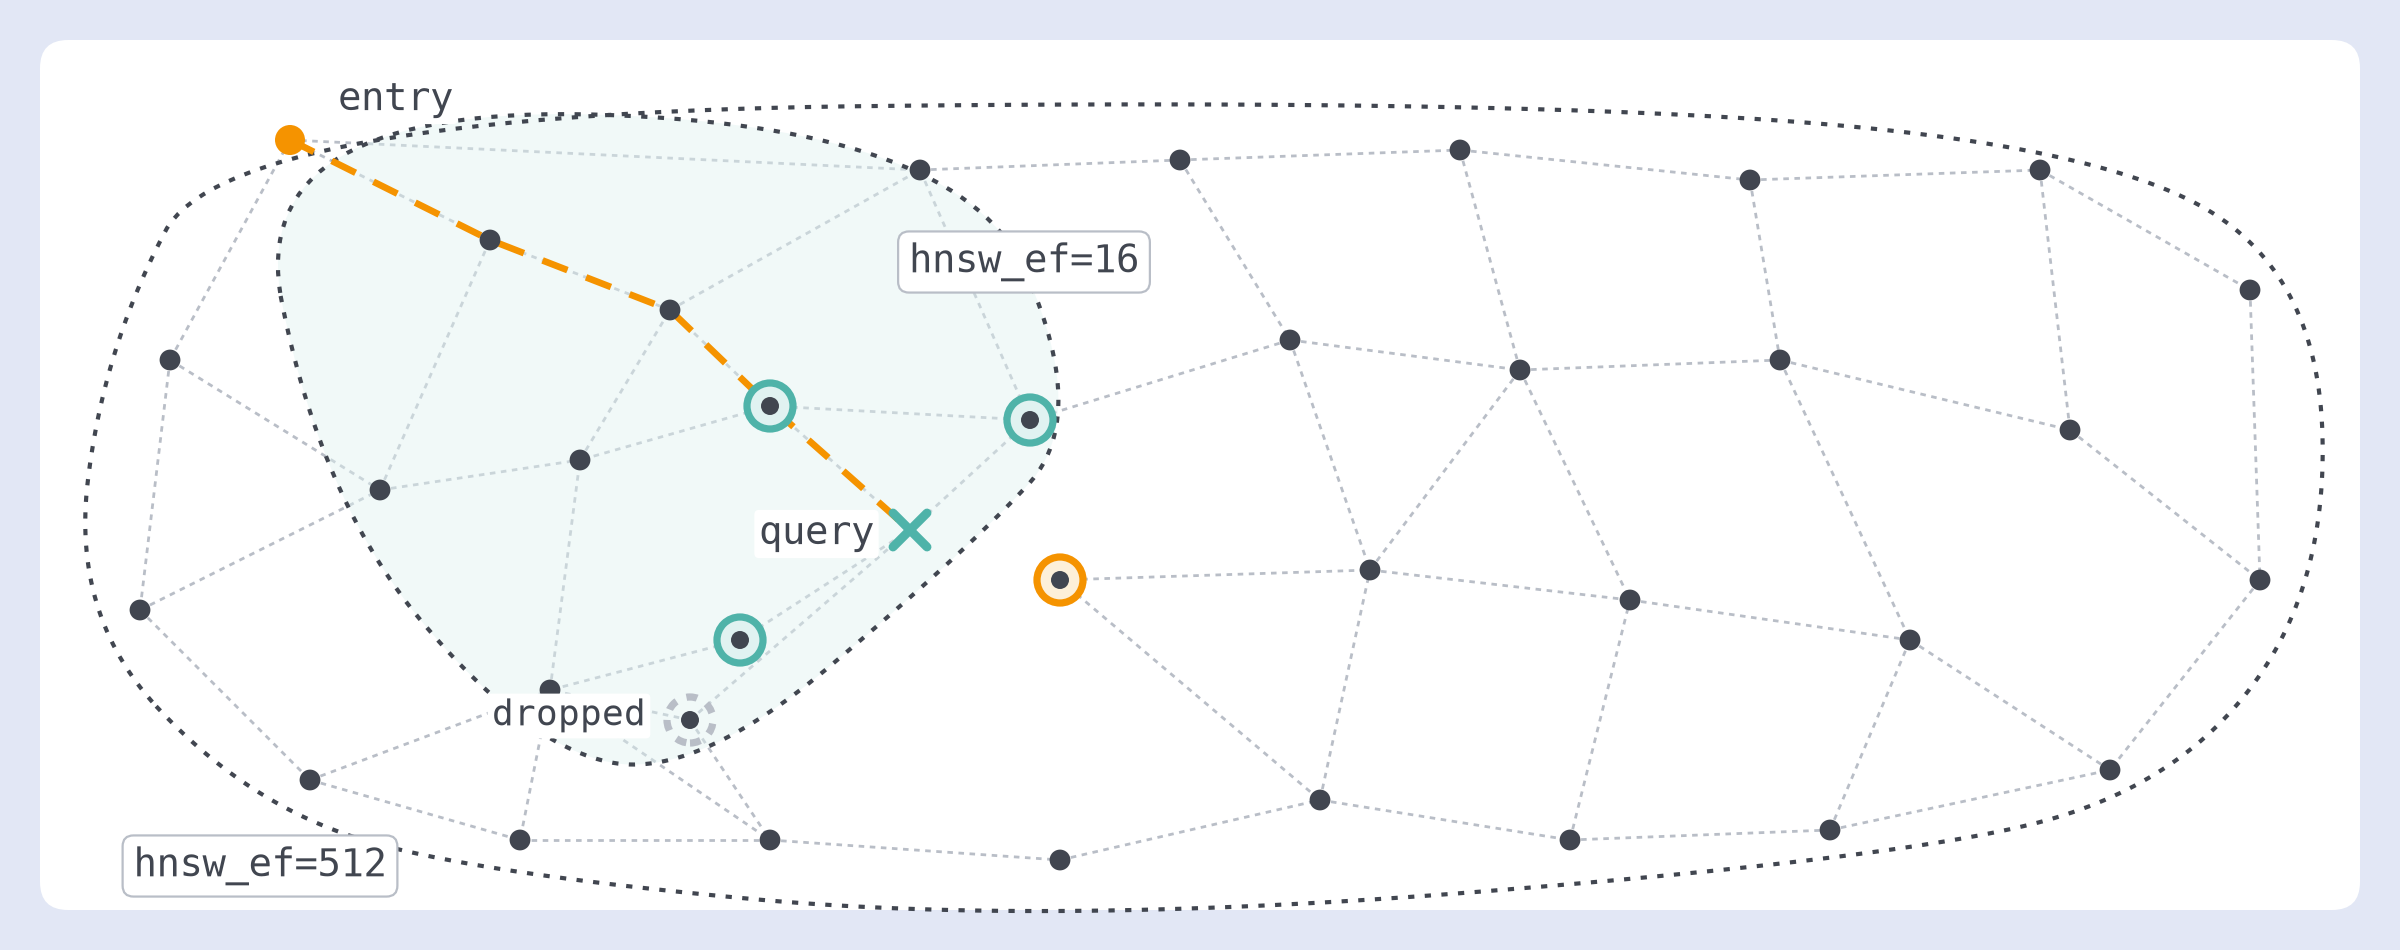
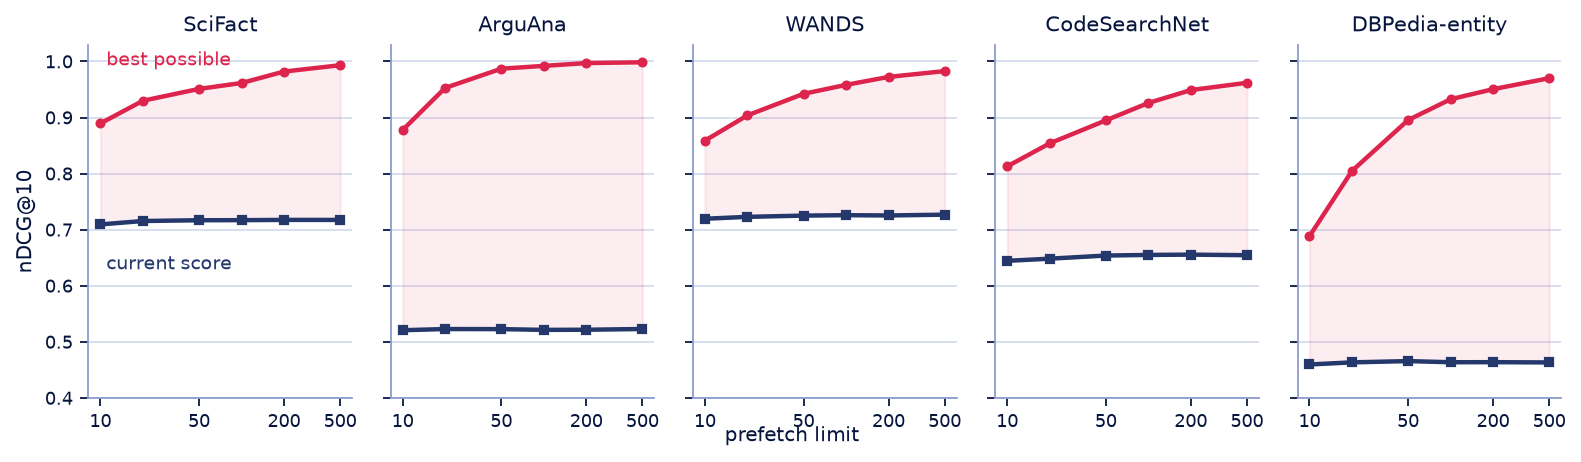
候选深度是检索阶段传给后续排序的候选数,仅当后续阶段能利用额外候选时才有意义。建议初始测试100至200,但需按自身数据验证。提高hnsw_ef仅在召回率仍上升时有效,否则只增延迟。内存受限时优先测试量化,而非降低候选深度。

候选深度:多少检索量才足够?

Qdrant - Vector Database Qdrant - Vector Database · 2026-08-20T21:00:00Z
候选深度:多少检索才够?

本文讨论检索系统中候选深度(candidate depth)的调优方法。建议先设置基线,测试100-200的limit值,并对比近似搜索与精确搜索的召回率。增加候选可提升最佳可能分数,但需权衡延迟。当RAM受限时,优先考虑量化而非降低深度。hnsw_ef仅在召回率未饱和时调整。最后根据最佳可能分数与当前分数的差距,决定优化排序或检索。

候选深度:多少检索才够?

Qdrant - Vector Database Qdrant - Vector Database · 2026-08-20T21:00:00Z
AI指令能写出“深度好文”,但写不出实践者之声

文章批评当前“深度好文”缺乏作者真实声音,指出学术写作、思想领袖营销和AI生成三种方式导致作者消失。提出“实践者之声”写作,强调作者不隐藏判断,基于经验分享决策和代价,权威来自实践而非头衔。最后探讨AI能否复制这种写作,答案悬而未决。

AI指令能写出“深度好文”,但写不出实践者之声

极道 极道 · 2026-08-20T00:46:00Z
深度求索发布DeepSeek-V4-Pro-0813 该模型从预览版正式进入GA阶段

深度求索发布DeepSeek-V4-Pro-0813版,从预览版正式进入GA阶段,模型ID不变,API定价暂未调整。该模型支持1M上下文窗口,提供Responses和Anthropic API,价格未变但已预告将涨价。目前未开源,基准测试数据待完善,内部数据显示多项测试较预览版大幅提升,编码、数学等核心任务保持开源领先,接近前沿闭源模型水平。

深度求索发布DeepSeek-V4-Pro-0813 该模型从预览版正式进入GA阶段

蓝点网 蓝点网 · 2026-08-13T05:30:30Z
通过深度低秩残差蒸馏锁定预训练权重

本文提出DLR-Lock方法,通过将预训练MLP替换为深度低秩残差网络,利用自动微分的推理-训练不对称性,增加微调时的激活内存和计算开销,并造成架构不匹配,从而有效防御自适应攻击者修改权重,同时保持模型原有性能。实验验证了该方法的有效性。

通过深度低秩残差蒸馏锁定预训练权重

Apple Machine Learning Research Apple Machine Learning Research · 2026-08-06T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码