
候选深度:多少检索量才足够?
内容提要
候选深度是检索阶段传给后续排序的候选数,仅当后续阶段能利用额外候选时才有意义。建议初始测试100至200,但需按自身数据验证。提高hnsw_ef仅在召回率仍上升时有效,否则只增延迟。内存受限时优先测试量化,而非降低候选深度。
延伸解读
候选深度并非越大越好
文章指出,提高候选深度(limit)会增加检索工作量,若后续有重排序阶段,还会增加其评分负担。在单分片测试中,将limit从10提升到500,中位延迟增加了37%至43%。但融合后的nDCG@10并不总是随深度增加而提升:在CodeSearchNet上,limit=200时达到峰值,500时反而下降;DBPedia-entity的峰值出现在50。因此,建议从100至200开始测试,并根据自身数据验证最佳值。
hnsw_ef仅在召回率未饱和时有效
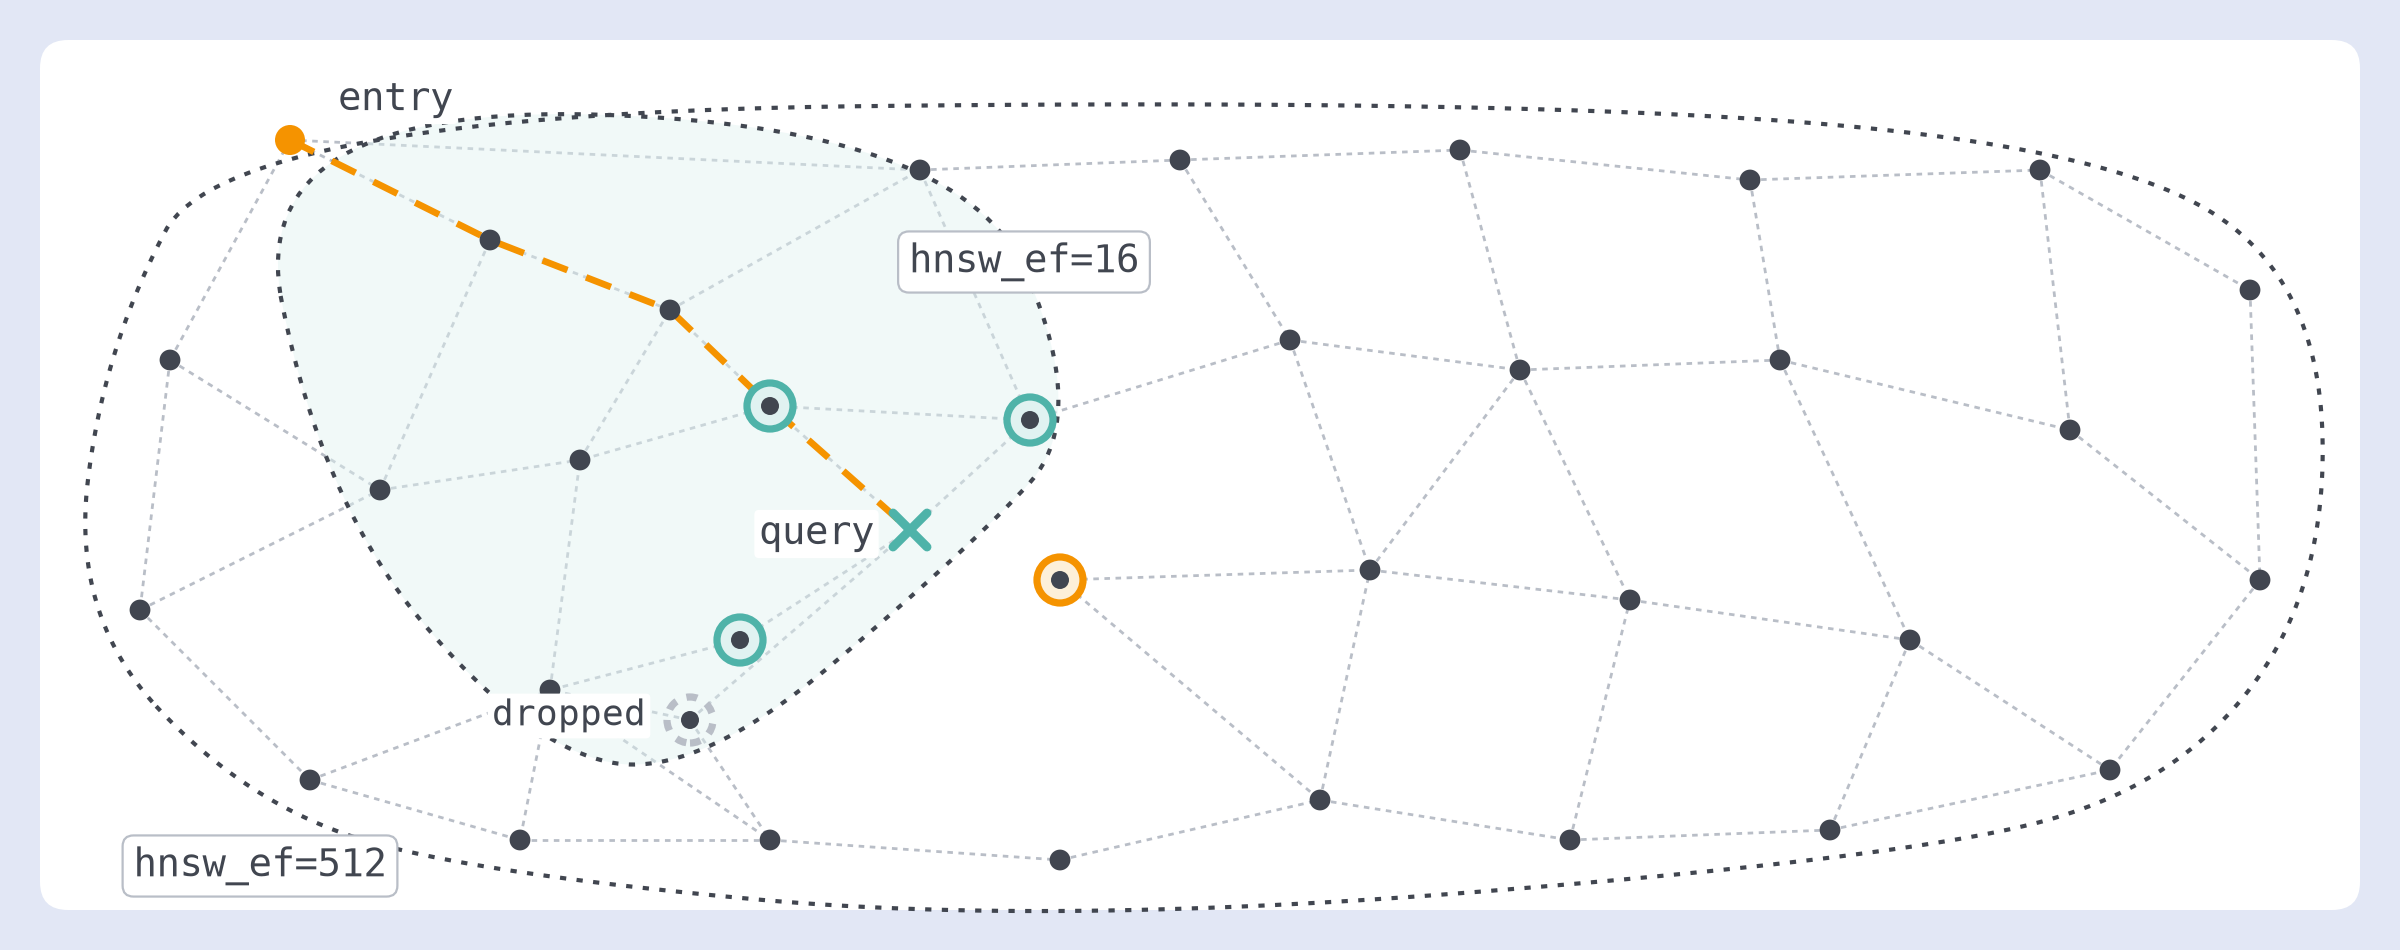
hnsw_ef控制HNSW图遍历的广度,影响近似搜索的召回率。文章通过实验表明,在SciFact数据集上,hnsw_ef=128时召回率已达0.999,之后基本持平,而查询时间从1.98ms微增至2.45ms。在五个数据集上,将hnsw_ef从16提升到512,融合nDCG@10变化最多0.0022,但中位延迟上升4%至49%。因此,应选择能达到召回目标的最低hnsw_ef值,若召回率从一开始就持平,则保持当前设置。
内存受限时优先考虑量化
降低limit只能减少查询时的计算量,不会改变集合的磁盘和内存占用。而量化(如int8标量量化)可将向量存储压缩至原来的四分之一。实验显示,在SciFact和DBPedia-entity上使用int8量化,密集前10名一致率在无重评分时为0.984,启用重评分后可达0.997至1.000,融合nDCG@10变化最多0.0001。因此,当内存是瓶颈时,应优先测试量化,而非降低候选深度。
利用最佳可能得分诊断瓶颈
通过比较当前排序得分与最佳可能得分(即对检索到的候选进行完美排序所能达到的分数),可以判断瓶颈在检索还是排序。若差距大,说明相关候选已存在但排序不佳,应调整融合或引入重排序;若差距小,则排序已接近候选集上限,需改进检索。文章建议使用标注查询集计算此差距,并以此指导后续调优方向。
Q&A
候选深度在检索中具体指什么?
候选深度是检索阶段传递给后续排序阶段的候选结果数量。它只有在后续阶段能够利用这些额外候选时才有意义。在混合搜索中,每个预取操作都有自己的限制,多阶段查询会在每一层设置深度;在纯稠密或纯稀疏搜索中,它指的是传递给重排序器或其他下游阶段的候选数量。
如何为下游排序阶段设置初始的候选深度限制?
建议从100到200开始测试,但需注意这些值只是起点,并非生产默认值。因为限制是每个分片应用的,且重排序器会对每个候选进行评分,所以应根据自身数据和标签进行验证。
提高hnsw_ef参数在什么情况下才有效?
只有当近似搜索的召回率仍在上升时,提高hnsw_ef才有效。如果召回率已经趋于平缓,增大该值只会增加延迟而不会提升召回率。应通过对比精确搜索来检查召回率是否还有提升空间。
内存受限时,应该优先降低候选深度还是测试量化?
内存受限时,应优先测试量化,而不是降低候选深度。因为降低候选深度只是减少查询时的计算量,并不会减少集合的磁盘和内存占用;而量化可以压缩向量存储,显著减少内存占用。例如,int8标量量化可将向量存储压缩至四分之一大小。
如何判断下一步应该优化排序还是检索?
通过比较最佳可能得分与当前得分之间的差距来判断。如果差距大,说明相关候选已存在但排序不够好,应优化排序(如调整融合设置或使用重排序器);如果差距小,说明排序已接近候选集允许的最佳水平,应改进检索(如增加候选深度或调整hnsw_ef)。
提高候选深度限制对延迟有什么影响?
提高候选深度限制会增加检索工作量,如果后续有重排序器,还会增加重排序器评分的候选数量。在单分片测试中,将限制从10提高到500,中位延迟增加了37%到43%。具体影响需根据自身的p95预算、并发和分片情况来测量。
