小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
英伟达将740亿参数的智能体模型压缩至24GB,使其能在你的笔记本电脑上运行

英伟达发布Nemotron 3.5系列新模型,包括120B参数的视觉语言模型Super VL,面向企业智能体,支持图像和视频输入,速度与效率突出,但部分基准测试逊于Qwen。同时推出两款小型Bolt模型,可在笔记本本地运行编码、研究等任务,其中74B-A9B已发布,E4B 4GB版稍后推出。模型已在Hugging Face开放下载,允许商用。

英伟达将740亿参数的智能体模型压缩至24GB,使其能在你的笔记本电脑上运行

The New Stack The New Stack · 2026-10-15T16:00:00Z
Show-Harness——仅凭一个VLM智能体即可操控机器人:12个语义动作单元(前进/旋转/抓取)既是模型的思考语言、又是机器人的物理指令

论文提出Show-Harness具身控制框架,使视觉语言模型通过离散语义动作单元直接操控机器人,无需微调即可零样本控制,少量微调可适配小模型;并提出GUMI界面,支持人类与智能体在统一动作空间采集示教数据,实现跨形态复用与协同采集。

Show-Harness——仅凭一个VLM智能体即可操控机器人:12个语义动作单元(前进/旋转/抓取)既是模型的思考语言、又是机器人的物理指令

结构之法 算法之道 结构之法 算法之道 · 2026-09-26T15:41:29Z
Video-to-BT——让VLM照着人类示范视频自动构建行为树:必要时人工干预,以解决动态环境下的长时程装配任务

Video-to-BT框架利用视觉语言模型将人类示教视频分解为子任务并生成行为树,结合实时场景感知与反应式控制执行机器人装配。系统通过世界状态监控和恢复机制应对动态扰动,失败时触发重新规划,并引入人在回路验证,提升长时程装配任务的泛化性与鲁棒性。

Video-to-BT——让VLM照着人类示范视频自动构建行为树:必要时人工干预,以解决动态环境下的长时程装配任务

结构之法 算法之道 结构之法 算法之道 · 2026-09-25T08:01:23Z
TimesFM 3.0 零样本预测时间序列,覆盖多场景分析需求;VLX-Seek 融合目标定位与细粒度理解,拓展具身视觉感知能力

VLX-Seek是OmAI Lab推出的细粒度视觉语言模型,面向机器人、无人机等边缘具身视觉场景,结合语言理解与区域级视觉感知,支持目标定位、指代理解、区域OCR、描述与计数,并引入目标缺失拒识机制,为具身智能连接环境感知与行动决策提供基础能力。

TimesFM 3.0 零样本预测时间序列,覆盖多场景分析需求;VLX-Seek 融合目标定位与细粒度理解,拓展具身视觉感知能力

HyperAI超神经 HyperAI超神经 · 2026-09-24T08:11:07Z
票据抽取不一定要上最大模型:先看版式是否真的变化

研究比较11种票据抽取系统,发现微调开源视觉语言模型在合成支票上F1超0.98,无需都用最大模型。选型应依据版式稳定性与错误代价:固定模板可用OCR加规则,版式多变再用VLM,样本多且字段稳定才值得微调。建议用真实文档分层测试,按字段设阈值,低置信度转人工,并保留规则基线和回归集。

票据抽取不一定要上最大模型:先看版式是否真的变化

Java for You Java for You · 2026-09-16T01:19:52Z
Witbe 推出用于视频测试自动化的 AI 模型

Witbe推出自研视觉语言模型Witbe VLMs,用于视频测试自动化,与通用模型协同工作。该模型针对机顶盒等特定场景训练,性能不逊于前沿模型,且延迟更低、成本更经济、支持数据主权。测试结果仍由确定性逻辑验证,基于真实设备KPI。CEO和COO强调模型专用性不影响通用性,客户已广泛部署。

Witbe 推出用于视频测试自动化的 AI 模型

实时互动网 实时互动网 · 2026-09-04T02:50:00Z
Cohere 发布 Parse 5:一款把企业文档转成 Markdown 的 2.3B 视觉语言模型

Cohere发布文档解析模型Parse(parse-v5.0),为2.3B参数视觉语言模型,可将PDF、PPT等转为带HTML表格和边界框的Markdown。API定价每千页1.5美元,Model Vault月费2500美元起。ParseBench得分79.2为自报子集分数,未含图表和视觉定位维度。专用容量月处理超167万页才划算。

Cohere 发布 Parse 5:一款把企业文档转成 Markdown 的 2.3B 视觉语言模型

实时互动网 实时互动网 · 2026-08-28T02:31:27Z
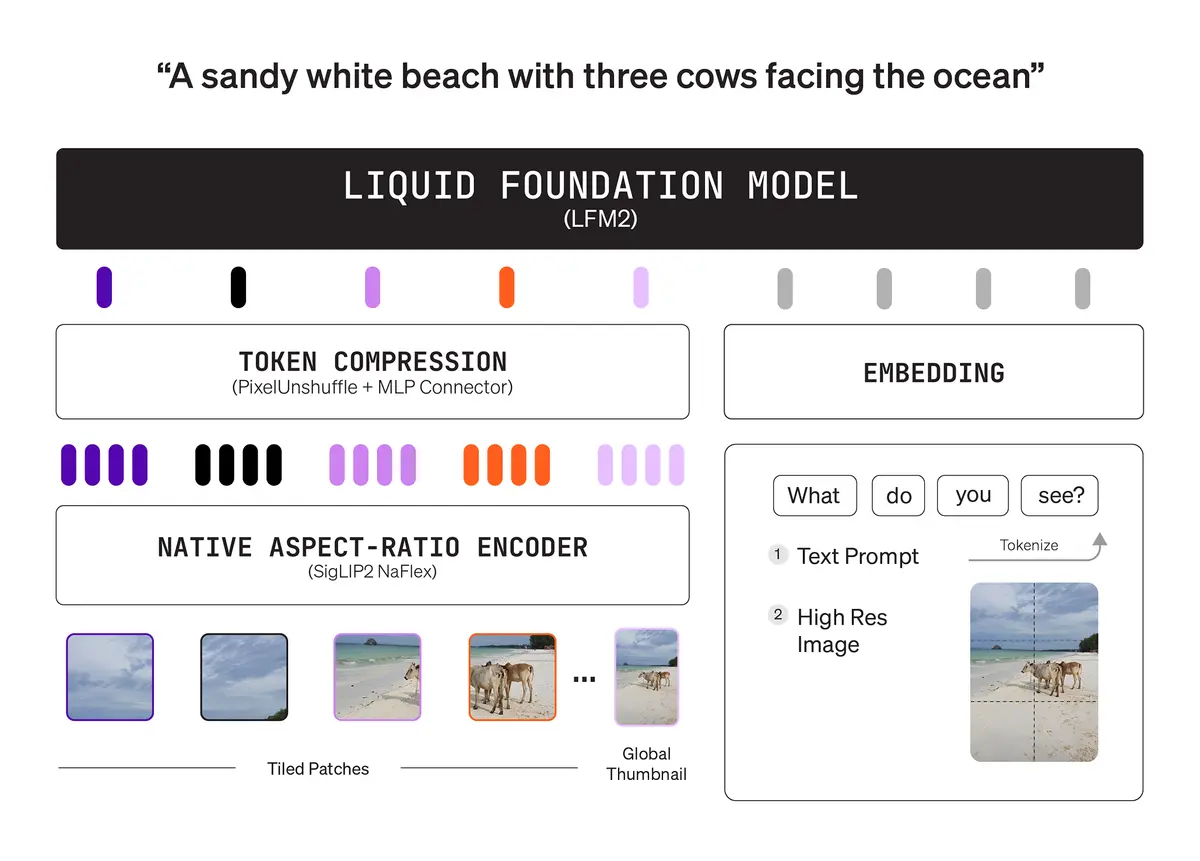
Liquid AI 发布 LFM2.5-VL-3B:一款 3B 视觉语言模型,可读取屏幕、识别物体并调用设备端工具

Liquid AI发布LFM2.5-VL-3B,31亿参数视觉语言模型,专为设备端设计,支持屏幕理解、函数调用、锚定和多图像输入。在28项基准测试中平均得分69.4,与4.7B模型相当。内存占用约3GB,解码速度228 tok/s。许可证对年收入低于1000万美元的公司免费,高收入需商业许可。

Liquid AI 发布 LFM2.5-VL-3B:一款 3B 视觉语言模型,可读取屏幕、识别物体并调用设备端工具

实时互动网 实时互动网 · 2026-08-14T02:56:23Z
紫东太初推出GMC核心集剪枝方法,少80%Token仍满血保真多模态能力

中科院团队提出GMC核心集剪枝方法,解决视觉语言模型Token冗余问题。该方法免训练,通过互补证据筛选和群体信息传输,保留关键视觉信息,减少80%以上Token,性能保持99%以上,并抑制幻觉,兼容Qwen、LLaVA等模型,提升推理速度,降低显存占用。

紫东太初推出GMC核心集剪枝方法,少80%Token仍满血保真多模态能力

量子位 量子位 · 2026-08-12T10:54:29Z

本文解析多模态模型核心技术:CLIP对比学习依赖大batch与温度参数;视觉接入语言模型有projector、cross-attention、指令微调三种方式,各有分辨率瓶颈、压缩损失和幻觉问题;SAM专注像素级分割,与聊天VLM是不同产品线;融合时机决定部署成本,统一token接口仍存争议。

【Transformer 与注意力机制】46|多模态融合:CLIP、Flamingo、LLaVA、SAM

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-08-06T00:00:00Z
GH-ESD:面向实例级视觉任务的基于假设驱动的错误切片发现

GH-ESD提出一种基于假设驱动与验证的框架,用于发现实例级视觉任务(如检测和分割)中的错误切片。它利用大语言模型生成关系性失败假设,并通过视觉语言模型和统计验证进行确认。研究还引入GESD基准数据集,实验显示该方法在检测任务上显著优于现有方法,并能提供可解释的改进建议。

GH-ESD:面向实例级视觉任务的基于假设驱动的错误切片发现

Apple Machine Learning Research Apple Machine Learning Research · 2026-07-27T00:00:00Z
给我看示例:从图像集合中推断视觉概念

本文介绍视觉概念推断任务(VICIS),要求模型从少量示例图像中提取共享概念,并应用于新查询图像生成。现有视觉语言模型在此任务上表现不佳,常忽略视觉上下文或产生偏见输出。作者提出训练框架和架构,学习从图像集合推断概念并提取查询特定嵌入。实验表明,该方法在合成数据和ImageNet/WordNet数据上生成更准确多样,且能泛化至未见概念和草图等模态。

给我看示例:从图像集合中推断视觉概念

Apple Machine Learning Research Apple Machine Learning Research · 2026-07-17T00:00:00Z

Gemma 4是谷歌DeepMind推出的文档解析工具,能够处理扫描和数字PDF,提取发票信息。它通过将PDF页面渲染为高分辨率图像,利用视觉语言模型读取内容,克服传统文本提取工具的局限性。该工具支持灵活的视觉令牌预算,以适应不同文档的复杂性,确保高效准确的提取。

使用Gemma 4进行零样本本地文档解析:将PDF视为图像

KDnuggets KDnuggets · 2026-07-07T14:00:04Z
LensVLM:用于文本压缩视觉表示的选择性上下文扩展

LensVLM是一种推理框架,旨在提升视觉语言模型(VLM)在压缩图像上的表现。该方法通过选择性扩展相关图像,保持高达4.3倍的有效压缩精度,超越传统的文本和视觉压缩基线。在多模态文档和代码理解任务中,随着压缩增加,准确性显著提升。

LensVLM:用于文本压缩视觉表示的选择性上下文扩展

Apple Machine Learning Research Apple Machine Learning Research · 2026-07-07T00:00:00Z
关于强化学习微调视觉语言模型的鲁棒性与思维连贯性

强化学习微调的视觉语言模型在视觉推理基准上有所提升,但仍受到视觉基础薄弱、幻觉和文本线索过度依赖的影响。简单的文本扰动显著降低了模型的鲁棒性和信心。开放源代码模型在连贯性方面表现不佳,而封闭模型则更为稳健。微调提高了基准准确性,但可能削弱推理的可靠性。建议采用关注忠实度的奖励机制,以改善推理的准确性和鲁棒性。

关于强化学习微调视觉语言模型的鲁棒性与思维连贯性

Apple Machine Learning Research Apple Machine Learning Research · 2026-07-02T00:00:00Z
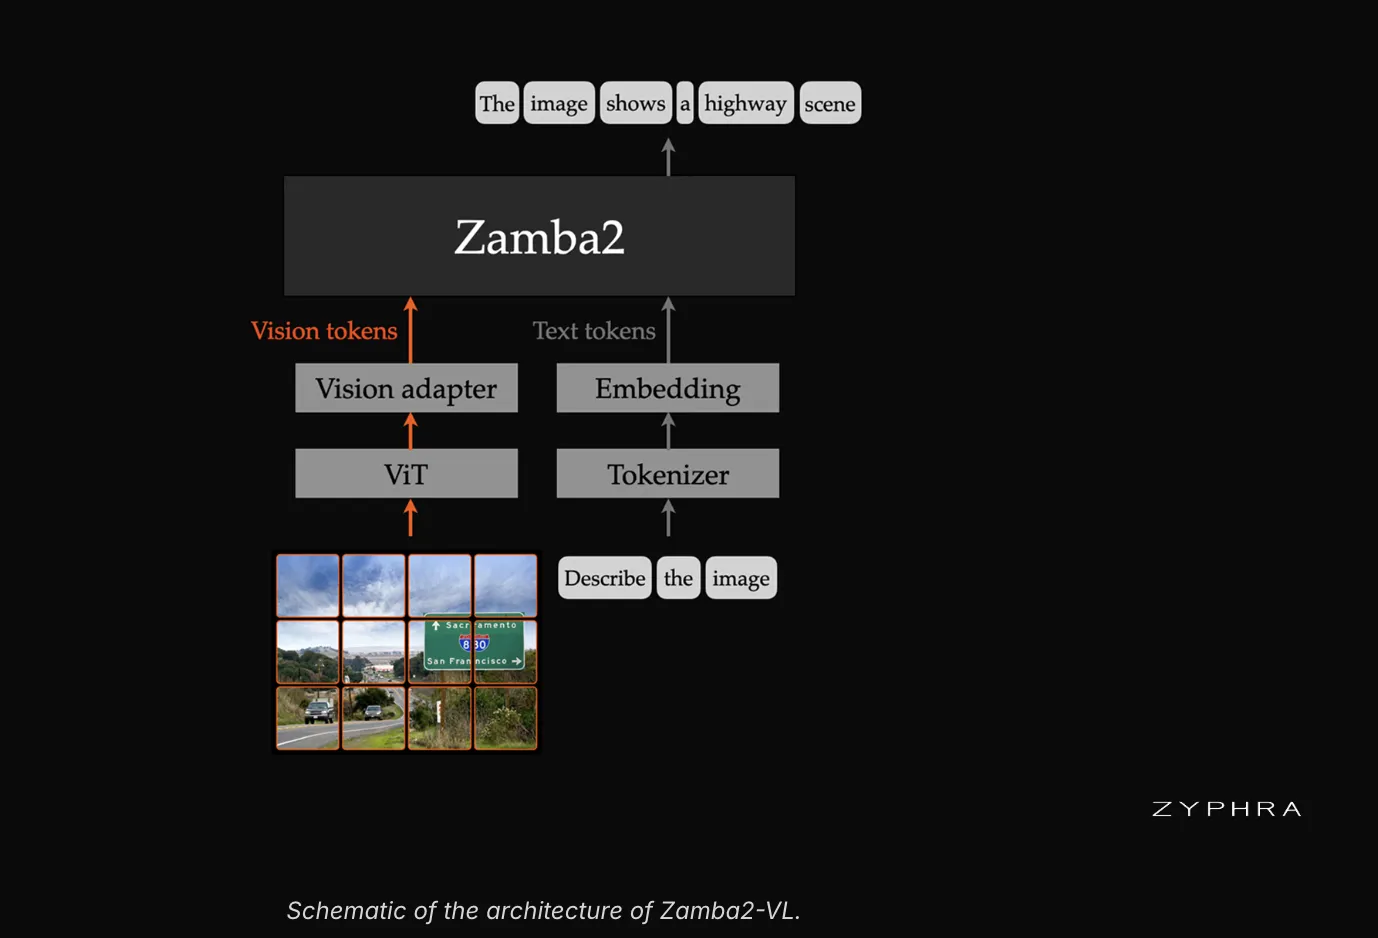
Zyphra发布Zamba2-VL:混合Mamba2-Transformer视觉语言模型

Zyphra发布了Zamba2-VL系列开放视觉语言模型,包含12亿、27亿和70亿参数。该模型采用混合SSM-Transformer架构,支持图像与文本的理解与关联,推理速度快,适用于文档提取和库存盘点等场景。尽管在知识推理方面表现不如大型模型,但在视觉计数和文档理解上具有优势。模型权重和推理代码已公开。

Zyphra发布Zamba2-VL:混合Mamba2-Transformer视觉语言模型

实时互动网 实时互动网 · 2026-06-15T02:50:06Z
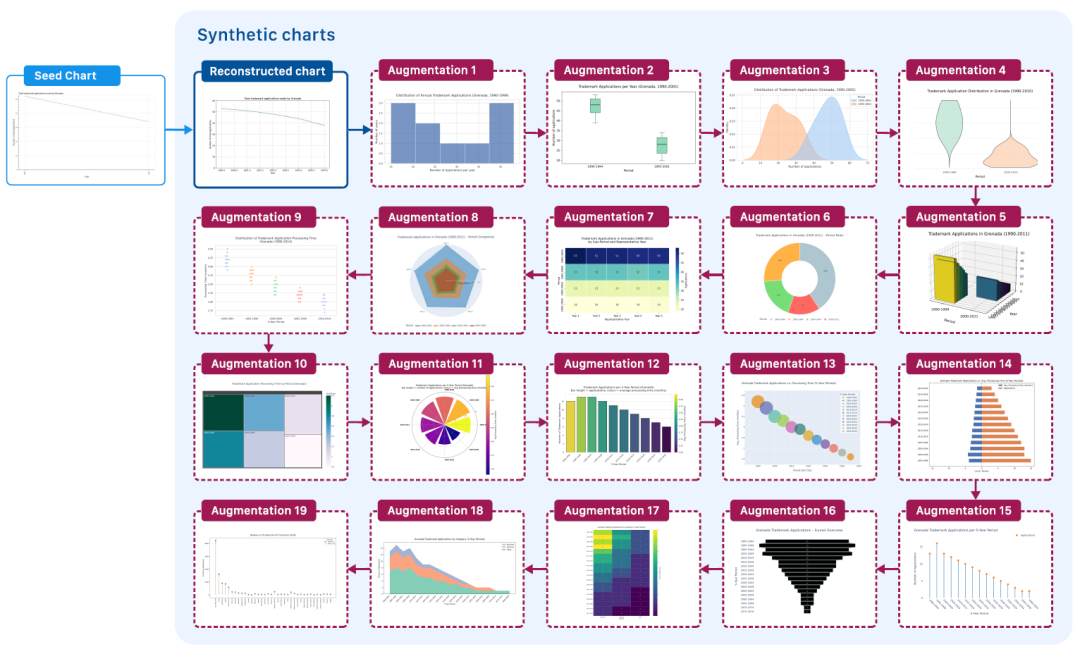
麻省理工/IBM提出迄今为止最大的合成图表数据集ChartNet,生成150万个多样化图表样本

ChartNet是由麻省理工学院等机构开发的高质量多模态数据集,包含150万个图表样本,涵盖24种图表类型,旨在提升AI对图表的理解能力。该数据集支持图表重建、数据提取和摘要生成等任务。研究表明,微调模型在ChartNet上表现优于现有大型模型,推动了视觉语言模型在图表理解领域的进步。

麻省理工/IBM提出迄今为止最大的合成图表数据集ChartNet,生成150万个多样化图表样本

HyperAI超神经 HyperAI超神经 · 2026-06-11T09:29:01Z
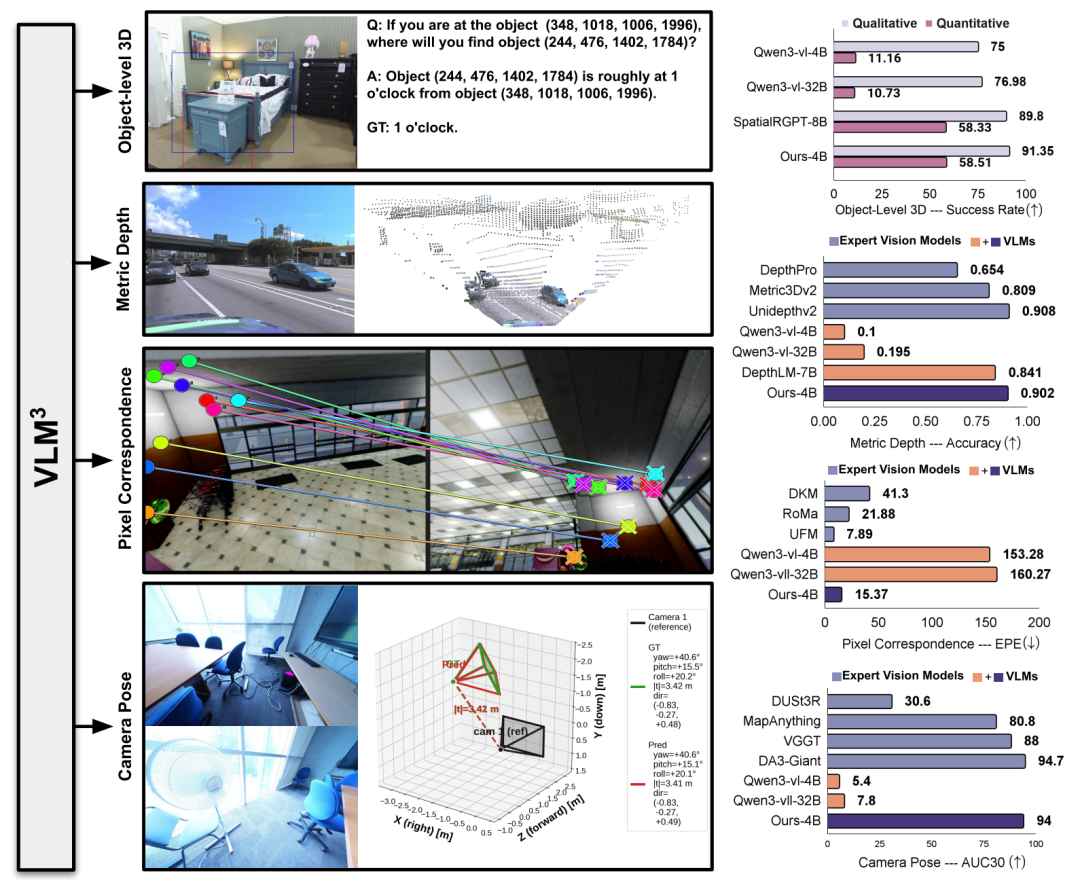
深度估计准确率冲上0.9,Meta提出VLM³,论证视觉模型天生会学3D,以Qwen3-VL-4B为基础实现多任务的统一建模

三维空间感知是自动驾驶和机器人领域的核心能力,旨在从二维图像恢复真实世界的空间结构。Meta与普林斯顿大学提出的VLM³框架,基于标准视觉语言模型,统一了物体级三维理解和公制深度估计等任务,显著提升了模型在细粒度三维感知中的表现。研究表明,通用视觉语言模型在三维表征能力上超出预期,为三维视觉领域的统一基础模型提供了新依据。

深度估计准确率冲上0.9,Meta提出VLM³,论证视觉模型天生会学3D,以Qwen3-VL-4B为基础实现多任务的统一建模

HyperAI超神经 HyperAI超神经 · 2026-06-08T08:06:39Z
Galaxea G0.5——升级“VLA自回归建模”范式:摒弃VLM上添加动作专家的模式,而是构建统一模型,用一套权重,在同一个自回归token序列中同时生成推理与动作(含VLA-0的详解)

星海图提出的G0.5模型将视觉语言模型与动作生成统一为单一自回归序列,通过共享权重实现推理与动作的耦合,提升机器人控制效率。该模型采用可学习的动作分词器和视觉记忆模块,优化动作生成过程,减少离散化负担,能够在零样本条件下分解任务,直接生成动作,增强对复杂场景的适应能力。

Galaxea G0.5——升级“VLA自回归建模”范式:摒弃VLM上添加动作专家的模式,而是构建统一模型,用一套权重,在同一个自回归token序列中同时生成推理与动作(含VLA-0的详解)

结构之法 算法之道 结构之法 算法之道 · 2026-06-04T10:18:09Z
麻省理工学院研究人员教AI模型解读图表

MIT和IBM研究人员开发了ChartNet数据集,包含超过一百万种多样化图表,旨在提升视觉语言模型对图表的理解能力。该数据集通过合成数据生成,帮助小型企业利用AI进行商业趋势分析和科学数据解读。研究表明,使用ChartNet训练的开源模型在图表提取和总结任务上优于大型商业模型。

麻省理工学院研究人员教AI模型解读图表

MIT News - Computer Science and Artificial Intelligence Laboratory (CSAIL) MIT News - Computer Science and Artificial Intelligence Laboratory (CSAIL) · 2026-06-03T04:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。
1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
友情链接: MOGE.AI 九胧科技 1tok 菜鸟教程 Remio.AI DeekSeek连连 53AI 神龙海外代理IP IPIPGO全球代理IP 东波哥的博客 匡优考试在线考试系统 开源服务指南 蓝莺IM Solo 独立开发者社区 AI酷站导航 极客Fun 我爱水煮鱼 周报生成器 He3.app 简单简历 白鲸出海 T沙龙 职友集 TechParty 蟒周刊 Best AI Music Generator 模力方舟 Gitee AI

小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码