小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
利用多模态大语言模型推进自我中心视频问答

本文评估了多模态大语言模型在Egocentric视频问答中的表现,使用QaEgo4Dv2数据集。研究发现,经过微调的Video-LLaVa-7B和Qwen2-VL-7B-Instruct在OpenQA和CloseQA中表现优异,超越了之前的基准。然而,模型在空间推理和细粒度物体识别方面仍存在困难。

利用多模态大语言模型推进自我中心视频问答

Apple Machine Learning Research Apple Machine Learning Research · 2025-06-30T00:00:00Z

本研究提出了PerceptionLM框架,解决了视觉语言模型的闭源问题,并发布了280万个人工标注的视频问答对,以促进详细视频理解。同时推出的PLM-VideoBench评估套件推动了透明研究的进展。

PerceptionLM: Open-Access Data and Models for Detailed Visual Understanding

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-17T00:00:00Z

该研究提出了一种新型时间三重变换器(T3T),有效解决视频问答中的非线性交互问题,显著提升了准确性和深度。

视频流作为时间序列:发现视频问答中的时间一致性和变异性

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-08T00:00:00Z

本研究评估了多模态大语言模型在自我中心视频问答中的表现,特别是针对长时间跨度推理和第一人称视角的挑战。引入的QaEgo4Dv2数据集显示,微调后的Video-LLaVa-7B和Qwen2-VL-7B-Instruct在问答任务中表现优异,提升了准确性,并指明了未来改进方向。

利用多模态大语言模型推动自我中心视频问答的进展

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-06T00:00:00Z

本文提出了一种新方法,通过双图和异构图在视频问答中进行信息传递,以提高静态关系识别的准确性。实验结果表明,该方法在ANetQA和Next-QA数据集上显著提升了答案推理的准确性。

利用静态关系进行视频问答中的同类型与异类型信息传递

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-03T00:00:00Z

本研究提出了一种主动关键帧搜索(AKeyS)算法,旨在提升视频问答中的视频理解能力。该算法通过现代语言代理优化经典搜索方法,有效区分关键信息与冗余内容,从而显著提高搜索效率并降低计算成本。实验结果表明,AKeyS在关键帧搜索方面优于以往方法。

Agentic Keyframe Search for Video Question Answering

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-20T00:00:00Z

中山大学与南洋理工大学等团队提出了跨模态因果对齐框架(CRA),旨在提升视频问答的时空定位准确性与可解释性。CRA通过三个模块优化因果推理,克服现有模型的统计偏差问题,已在CVPR 2025接收并开源代码。

CVPR’25跨模态因果对齐,让机器更懂视觉证据丨中大南洋理工等联合开源

量子位 量子位 · 2025-03-17T03:58:46Z

本研究提出了一种语义驱动的搜索框架,解决长视频理解中文本查询与视觉元素之间的逻辑关系。通过定义四种逻辑依赖关系,动态更新帧采样分布,实现语义关键帧识别,显著提升了关键帧选择和视频问答任务的性能。

Logic-in-Frames: Dynamic Keyframe Search for Long Video Understanding via Visual Semantic-Logical Verification

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-17T00:00:00Z

本研究提出了一种新框架VITED,旨在解决复杂视频问答中的链式证据推理问题,能够有效利用视频中的关键证据,超越现有模型。

视频时间证据提取

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-17T00:00:00Z

本研究提出了Multi-Object Multi-Actor Question Answering (MOMA-QA)数据集,以解决视频问答中的时间和空间粒度不足问题。同时,提出了一种新的视频语言模型SGVLM,结合场景图预测和大型语言模型,显著提升了视频理解的精细度。

Towards Fine-Grained Video Question Answering

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-10T00:00:00Z

本研究提出了一种基于多模态大语言模型(M-LLM)的轻量级视频帧选择方法,旨在解决长视频中重要信息丢失的问题。通过自适应选择与用户查询相关的帧,并利用空间和时间监督信号进行训练,实验证明该方法显著提升了视频问答的性能。

M-LLM Based Video Frame Selection for Enhanced Video Understanding Efficiency

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-27T00:00:00Z

本文提出了一种新的无学习令牌压缩方法,旨在降低视觉-语言模型的计算成本和推理时间。该方法在空间和时间维度上进行压缩,显著提升了模型的推理能力和效率,同时保持了性能。实验结果表明,该方法在视频问答任务中实现了显著的效率提升。

Learning-Free Token Compression for Multi-Modal Large Language Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-29T00:00:00Z

本研究提出了一种新方法ReasVQA,旨在提升视频问答模型的性能。通过多模态大型语言模型生成推理过程,实验结果表明该方法在多个基准测试中显著提高了性能,验证了推理过程的重要性。

ReasVQA:通过不完善推理过程推进视频问答

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-23T00:00:00Z

本研究提出了VidCtx框架,旨在解决大型多模态模型在视频问答中的计算和内存限制。通过整合视觉信息和上下文文本,VidCtx显著提高了问答的相关性和有效性,实验结果表明其在视频问答基准测试中表现优异,具有良好的应用潜力。

VidCtx: Context-aware Video Question Answering Based on Image Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-23T00:00:00Z

本文探讨了视频问答中的挑战,现有方法在整合问题与视频帧方面存在不足。我们提出的局部-全球问知视频嵌入(LGQAVE)通过跨注意力机制和动态图转换器,显著提升了视频问答的准确性。

Foundation Models and Adaptive Feature Selection: A Synergistic Approach to Video Question Answering

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-12T00:00:00Z
如今的智能体,已经像人一样「浏览」视频了,国内就有

NVIDIA推出的AI Blueprint旨在提升视频内容搜索效率,但试用中遇到流量限制等问题。相比之下,开源项目OmAgent提供更强大的多模态视频问答功能,支持多设备,简化智能体开发。

如今的智能体,已经像人一样「浏览」视频了,国内就有

机器之心 机器之心 · 2024-11-22T05:20:44Z

本研究提出了一种名为EVQAScore的无参考评估方法,用于视频问答和字幕数据质量评估。该方法通过关键词提取和帧采样技术,提高了评估效率和鲁棒性。在VATEX-EVAL基准上,EVQAScore表现优异,仅使用12.5%的原始数据量即可实现最佳结果。

EVQAScore: Efficient Video Question Answering Data Evaluation

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-11-11T00:00:00Z
基于跨模态对比表征学习的鲁棒视频问答 | 杨勋,曾建明,汪萌等

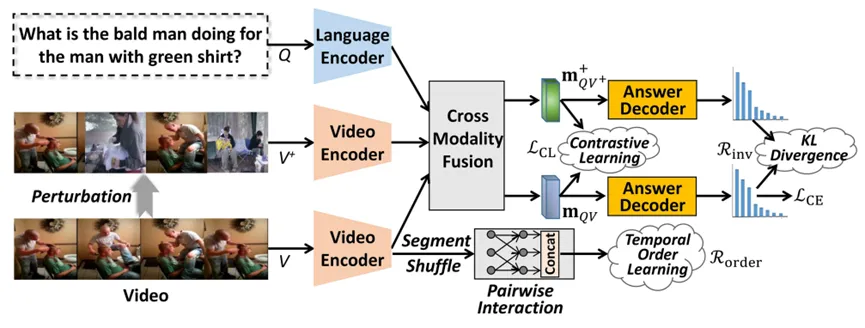
研究团队提出了一种鲁棒的视频问答框架,通过自监督对比学习和时序正则项,提升了视频内容理解能力,减少了数据偏见的影响。实验结果表明,该方法在多个数据集上显著提高了问答性能,尤其在处理不平衡数据时表现突出。

基于跨模态对比表征学习的鲁棒视频问答 | 杨勋,曾建明,汪萌等

实时互动网 实时互动网 · 2024-10-23T06:10:48Z

该研究提出了多个视频问答框架和基准测试,旨在提升视频理解能力。通过引入新的数据集和评估系统,如STAGE、OVQA和MVBench,评估视频型大型语言模型的表现,揭示其与人类理解的差距,推动视频理解领域的发展。

TVBench:重新设计视频-语言评估

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-10-10T00:00:00Z

本文介绍了一种新的视频问答(VideoQA)框架,结合异构内存和多模态融合层,通过自我更新的注意力实现多步推理,提升了在多个基准数据集上的性能。同时,提出了新的数据集和模型,以改善长视频的理解和推理能力,推动视频问答研究的发展。

自上而下的活动表征学习用于视频问答

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-09-12T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码