小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
在PyCharm中使用词袋模型

本文介绍了词袋模型(BoW)在自然语言处理中的应用,强调其通过记录词汇出现频率将文本转换为数值向量的有效性。BoW适用于文本分类和情感分析等任务。文章还展示了如何使用PyCharm构建文本分类项目,包括数据预处理、特征提取和模型训练,并强调了PyCharm在调试和可视化方面的优势。最后,讨论了BoW的局限性及其替代方法,如词嵌入和变换器模型。

在PyCharm中使用词袋模型

The JetBrains Blog The JetBrains Blog · 2026-04-29T17:42:41Z
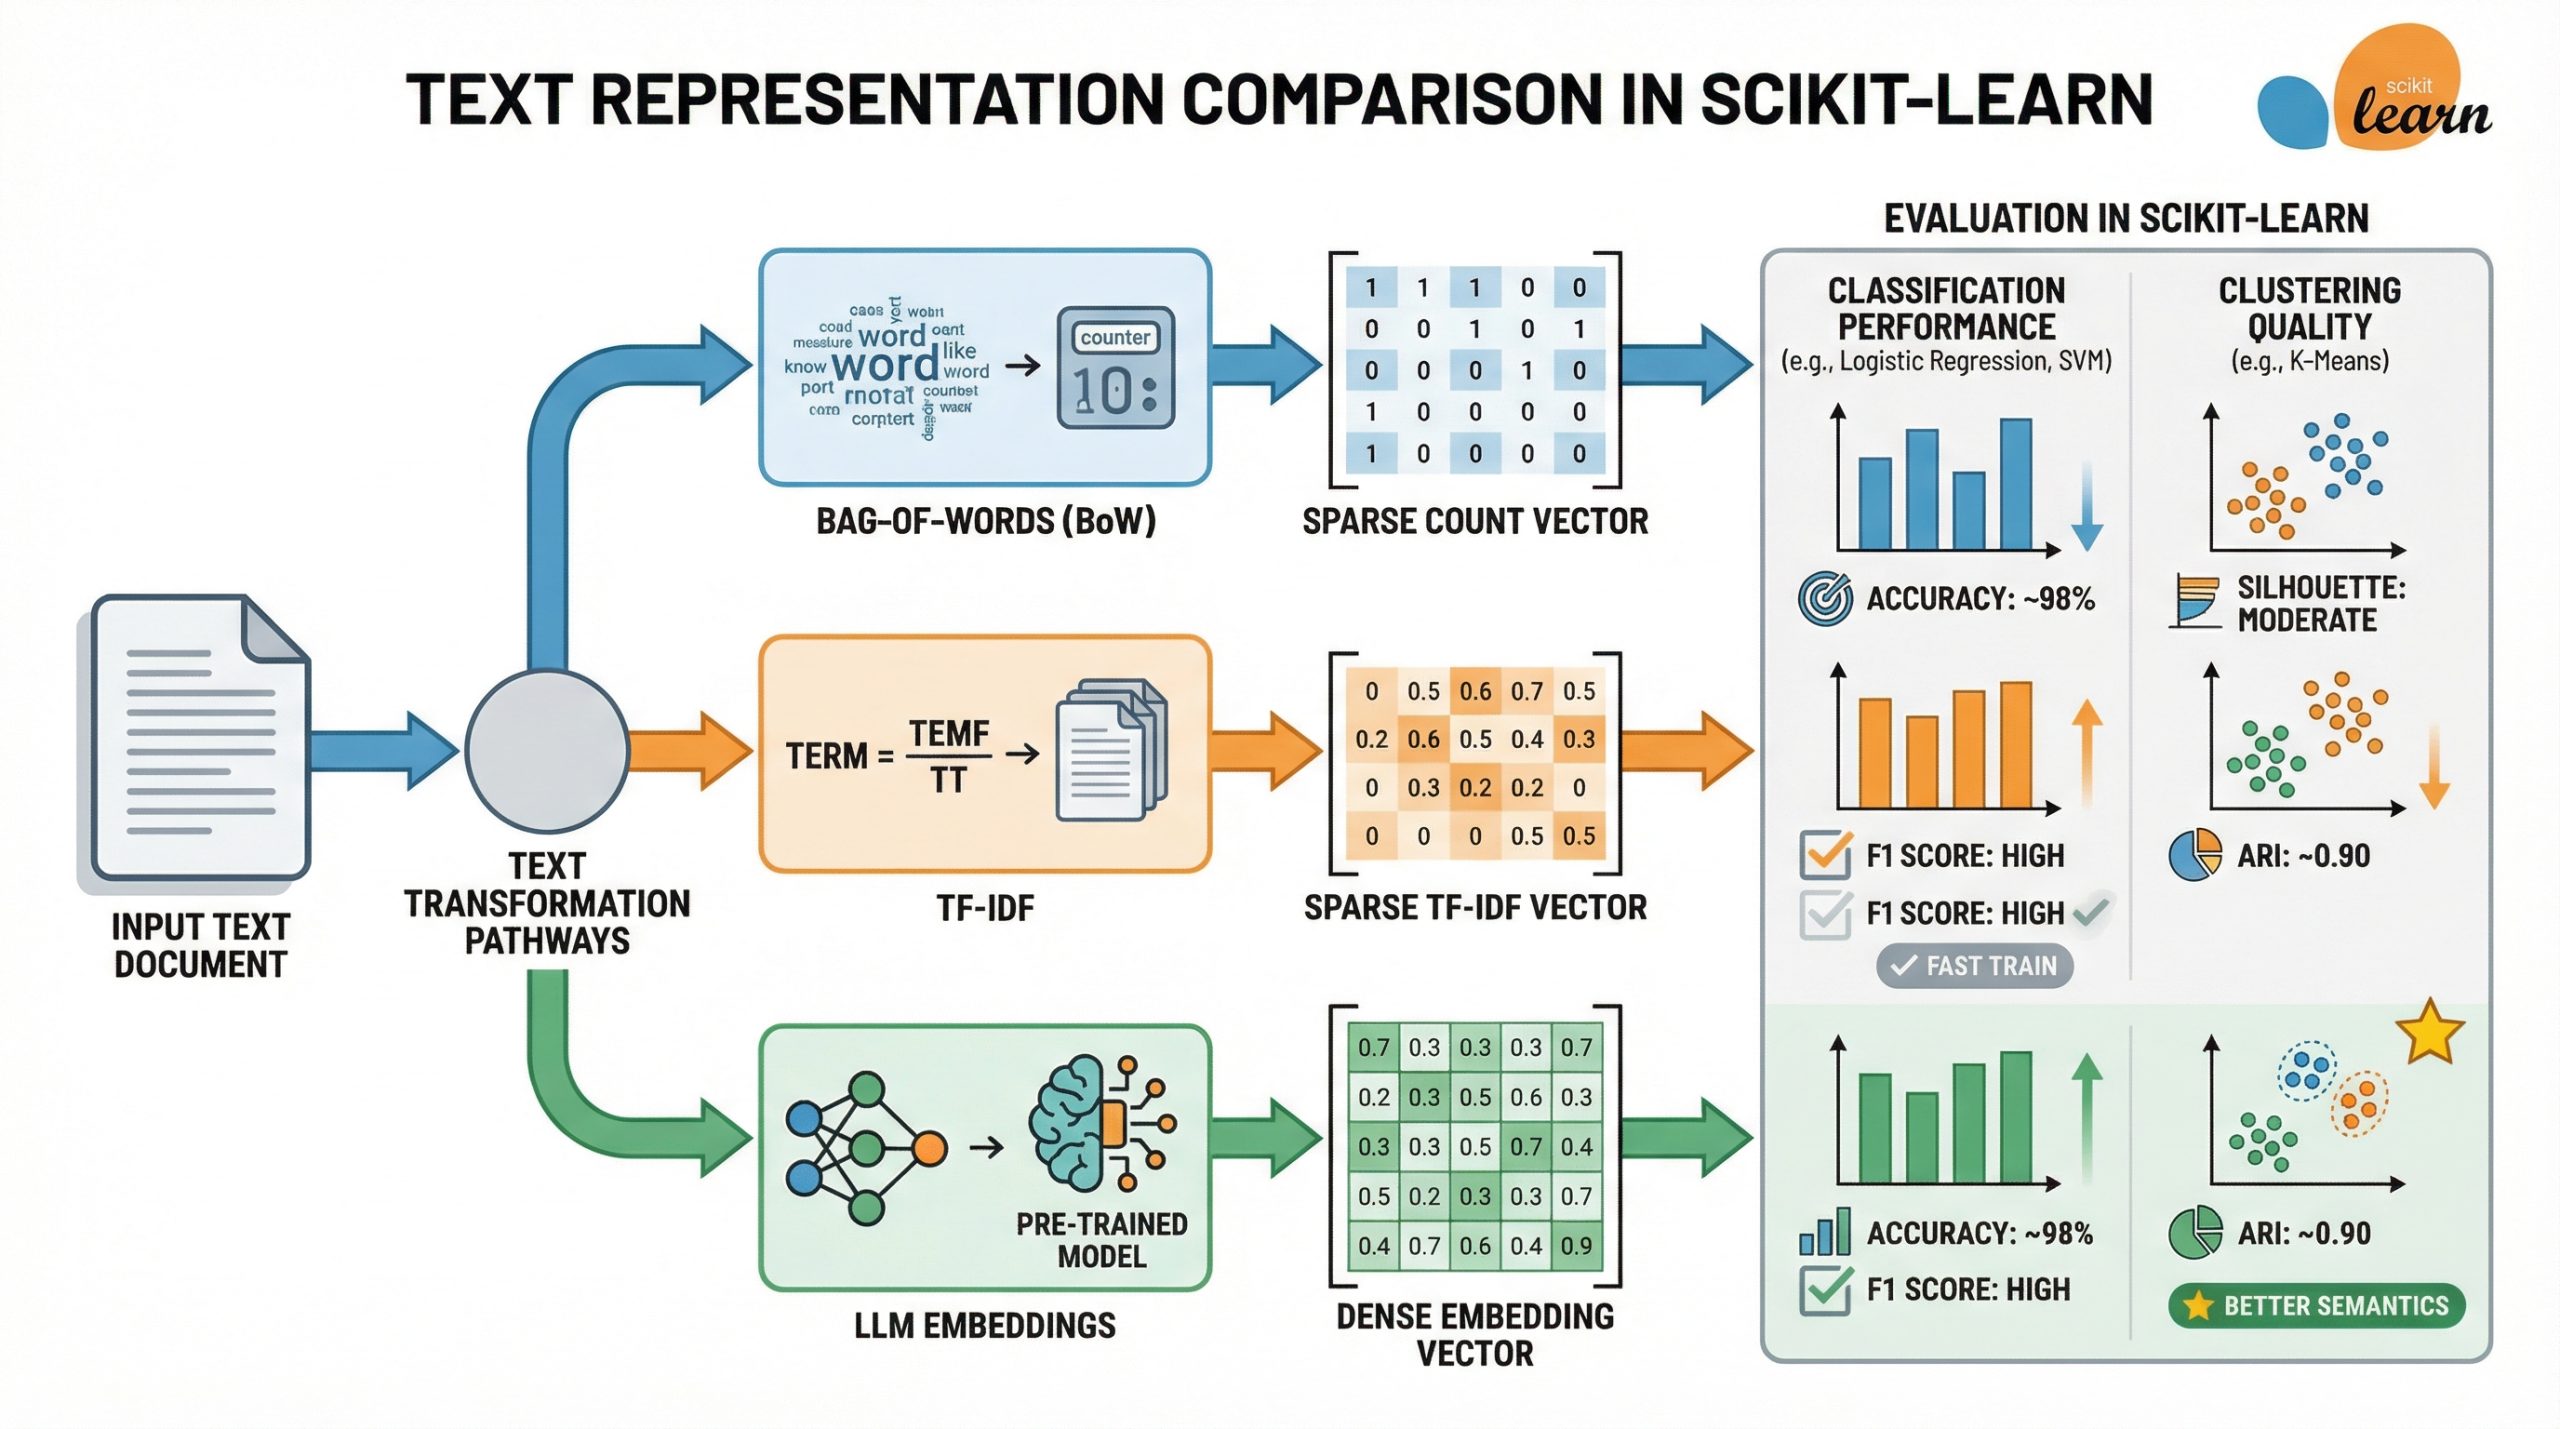
LLM嵌入与TF-IDF与词袋模型:在Scikit-learn中哪种效果更好?

本文比较了词袋模型(BoW)、TF-IDF和LLM嵌入在Scikit-learn中的效果,使用BBC新闻数据集分析它们在文本分类和聚类中的表现。结果显示,TF-IDF与支持向量机组合在分类准确率上最佳,而LLM嵌入在聚类任务中表现更佳。建议在处理简单数据集时优先考虑传统方法。

LLM嵌入与TF-IDF与词袋模型:在Scikit-learn中哪种效果更好?

MachineLearningMastery.com MachineLearningMastery.com · 2026-02-17T11:00:58Z
词袋模型的工作原理 – 语言模型的基础

现代人工智能的基础是词袋模型,它将文本转换为数字,便于计算机处理。尽管词袋模型忽略了语义和上下文,但为自然语言处理奠定了基础,并启发了更先进的模型,如TF-IDF和词嵌入。

词袋模型的工作原理 – 语言模型的基础

freeCodeCamp.org freeCodeCamp.org · 2025-08-25T13:18:00Z
词袋模型

词袋模型(BoW)是一种将文本转换为基于词频的数值向量的技术,广泛应用于文本分类、文档相似度和主题建模。其优点在于易于理解和高效处理小数据集,但缺乏上下文和语义理解。

词袋模型

DEV Community DEV Community · 2025-05-17T09:54:03Z
小本本系列:大模型中的文本向量text embeddings

本文探讨了文本向量化方法,包括词袋模型、TF-IDF、word2vec和transformer模型,这些技术提升了计算机对自然语言的理解,特别是通过嵌入表示捕捉语义。同时,文章讨论了余弦相似度和欧几里得距离等不同距离度量在向量比较中的应用。

小本本系列:大模型中的文本向量text embeddings

Shadow Walker 松烟阁 Shadow Walker 松烟阁 · 2024-12-08T11:39:43Z

本文介绍了一种可伸缩性方法,通过从视觉-语言基准中提取的多样化特征,测量它们与目标模型输出的相关性。作者确认了之前发现的CLIP表现类似于词袋模型,并在名词和动词上表现更好。

CLAIR: 使用大型语言模型评估图像标题

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2023-10-19T00:00:00Z

该论文研究了对不同代码段的评论进行分类的任务,比较了词袋模型和基于变形金刚的模型的性能,并提到了模型的局限性和改进空间。

利用词袋和基于 Transformer 的模型识别代码中的评论相关性

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2023-08-11T00:00:00Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码