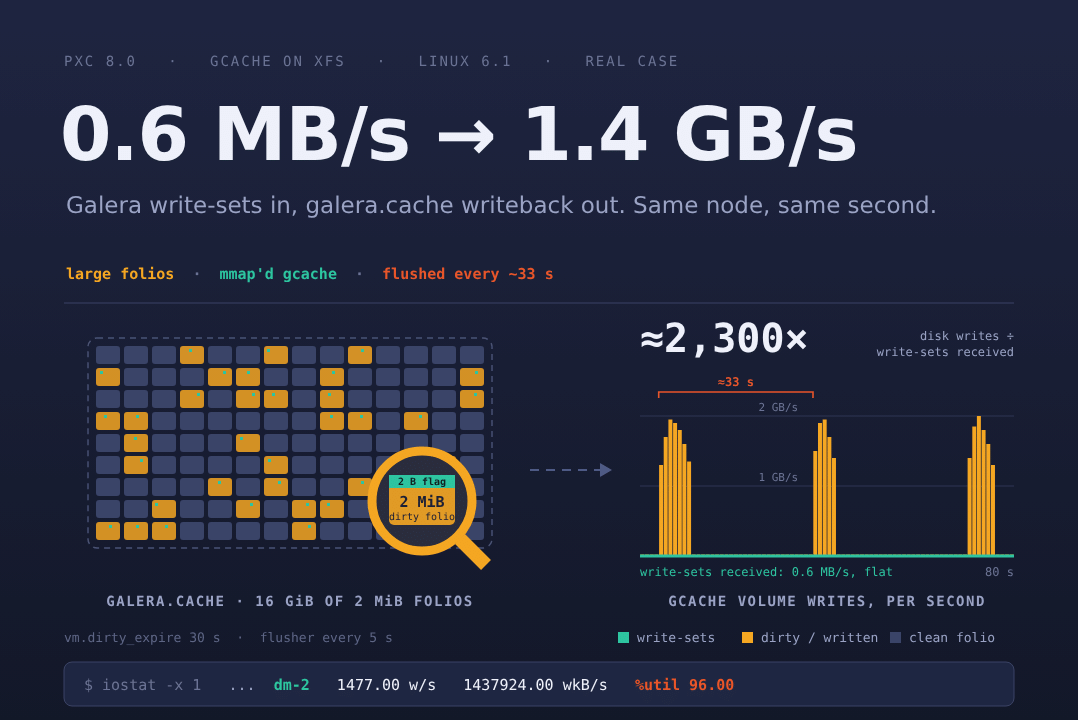
PXC从5.7升级到8.0后,Galera线程出现周期性大量磁盘写入,而InnoDB写入正常。原因是系统同时升级到Linux 6.1内核,其XFS大folio机制与Galera缓存使用mmap写入的方式冲突,导致回写放大。建议调整readahead等参数缓解。
Nirmata推出开源项目Runtime for Kyverno,基于eBPF和Linux安全模块,将策略执行从Kubernetes准入控制扩展至内核级运行时,可同步拦截exec、文件访问、网络出口和协议,默认监控模式,并复用Kyverno的CEL策略语言与OpenReports。该方案适用于行为由模型动态决定的AI代理,能限制其访问的模型端点、可执行文件和MCP服务器,弥补准入控制无法覆盖运行时行为的缺口。
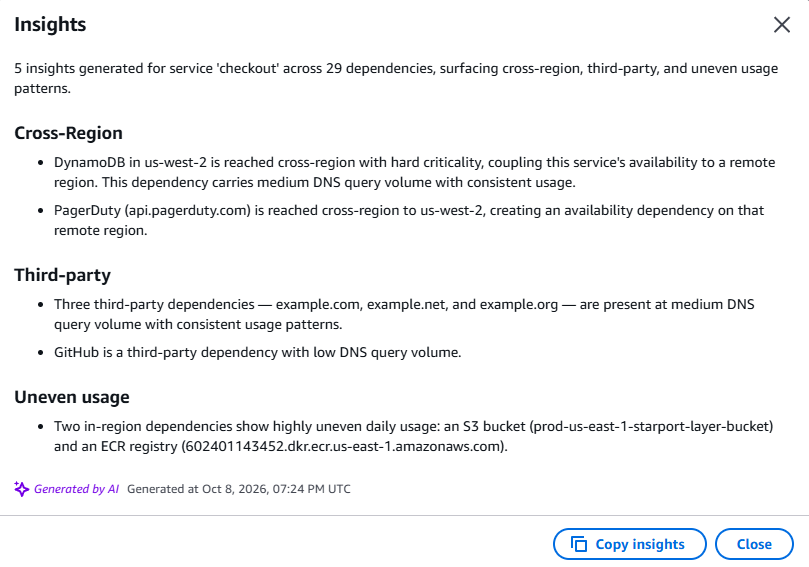
AWS Resilience Hub 新增三项功能:EKS 标签支持按标签筛选服务资源;生成式 AI 依赖洞察可分析依赖并标记跨区域、第三方等风险;通过 AWS Organizations 共享韧性策略,集中定义并供成员账户采用。示例展示为 checkout 服务划定资源边界、审查依赖并应用共享策略。
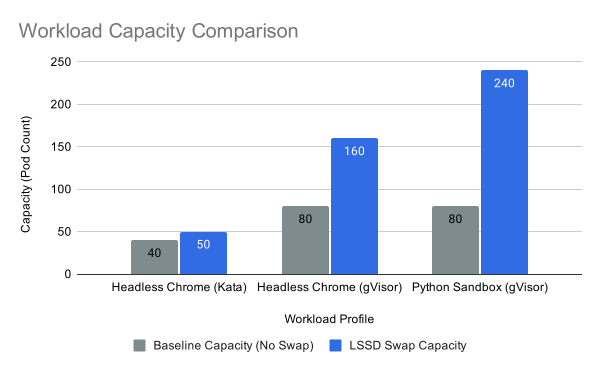
Kubernetes v1.34 起正式支持节点交换分区。使用 NVMe SSD 作为交换设备,可将闲置内存换出,显著提升 Pod 密度。测试表明:内核编译内存限制降低 50% 无性能损失;Python 沙箱并发从 80 增至 240,密度提升 3 倍,延迟主要源于 CPU 竞争而非交换 I/O。建议配置 LimitedSwap 并采用 Burstable QoS。
本期Rust社区周报:团队历时三年将延迟敏感服务迁移至Rust,负载均衡改用Pingora后耗时从600ms降至101ms,内存与CPU显著下降;rustc两个月平均编译时间降低4.57%,包含PGO、LLVM 23等优化;另有从零实现green thread运行时,以及champagne在Linux进程内加载Windows PE DLL的实践。
rivet 用 Rust 直接读取 MySQL binlog 并写入 BigQuery,试点库含 154 张表、32 亿行,每日刷新 8 次,使副本读负载降低约 99%,出站流量降低约 98%,基础设施成本降低约 50%。Git Cherry Tree 用 Iced 重写界面,代码增至 4.5 万行 Rust,二进制约 15 MB,性能提升 3–4 倍。另有 Rust 内核模块环境搭建记录,以及 cargo-crap 0.6 新增重复函数类型化分级。
2025年底起内存价格逆转,服务器DRAM在2026年初约翻倍,团队面临价格与配额双重压力。内存数据库扩容成本上升,欺诈检测、推荐系统和AI智能体受影响最大。Redis Flex将热数据保留在RAM,其余键值移至SSD,可按10%至50%选择内存比例,成本最多降低80%,无需改代码,并支持Redis Search。
双 DGX Spark 实测显示:合成基准表现亮眼,但真实智能体负载下出现卡顿。两机直连带宽约 200Gb/s,内存带宽仅 273GB/s 成为瓶颈。短提示下六并发达 172.7 tok/s,但五个子智能体扫描代码库时单流降至 15–25 tok/s,六分钟无结果。该设备仅适合单用户逐轮编程,不适合并发多智能体或长上下文任务。
谷歌开源编排器 Ax 将 Agent 视为集群一等负载,用声明式 manifest、沙箱、配额等 K8s 原语调度。Linear 博客独立印证 AI 生成代码使 CI 成为瓶颈,旧设施先排队。HN 质疑其复刻复杂度、YAML 地狱,且规模数字仅来自仓库自述,无第三方压测。
DigitalOcean 推出托管数据库高级版(MySQL 与 PostgreSQL),吞吐量提升最高 38%,p99 延迟降低 50%,故障切换平均 3 秒内完成,存储价格下降 46%。支持 VPC 安全连接、连接池读卸载及跨数据中心扩展,适合高并发、数据密集型 AI 工作负载。
DHI集团与AWS合作举办结构化黑客松,20名参与者分三队,基于Amazon Bedrock AgentCore、MCP服务器和Kiro,在三天内开发出实时雇主分析仪表盘、智能候选人匹配及统一人才市场等原型,将原本逾三个月的开发压缩至三天。赛后Kiro使用率增长84%,领导层承诺将黑客松年度化,并推进三个用例全部投入生产。
Kubernetes v1.37将Workload/PodGroup API及gang调度升级为Beta,引入CompositePodGroup API支持多层级调度和拓扑感知,并扩展抢占与DRA共享。新增控制器集成API和workloadbuilder库,Job控制器原生支持显式调度。这些改进旨在优化AI/ML等复杂批处理工作负载的调度效率。
Databricks高级产品经理Jonathan Katz指出,AI代理正打破运营与分析数据间的传统壁垒。LTAP通过统一存储层,让分析查询直接作用于实时运营数据,无需复制或迁移。它利用无状态计算与列式格式,避免HTAP的高成本,支持独立扩展。此架构简化了欺诈检测等实时工作流,减少延迟,并统一数据治理,使数据更易被代理高效利用。
Kubernetes v1.37将HPA缩容至零副本功能升级为Beta并默认启用,支持基于对象或外部指标(如队列长度)自动缩容至零,再按需扩容。此功能需配合外部指标适配器,通过ScaledToZero条件区分自动缩容与手动暂停,适用于队列消费者等场景,但HTTP工作负载需额外缓冲层。
FireDucks是一个兼容pandas API的编译器加速库,通过惰性执行和多线程优化提升大数据处理性能。基准测试显示,在1000万行数据集上,FireDucks在排序、分组、过滤等七项任务中均快于pandas,速度提升2.66倍至20.77倍,平均7.28倍。安装后仅需替换import语句即可使用,适合大规模数据处理场景。
本文介绍EKS上GPU工作负载的架构实践,涵盖计算节点、网络邻近性和高性能存储三层。重点包括:EFA多网卡配置(含p6-b300特殊拓扑)、四种定价模式、基于AWS原生拓扑标签的调度、FSx for Lustre与S3 Express One Zone存储选型,以及Terraform模块实现,旨在提升分布式训练性能。
Adobe工程师因GPU服务在流量高峰时反应式扩缩容过慢导致故障,开发了预测性Kubernetes控制器。它每60秒用Bi-LSTM模型预测未来10分钟需求,结合突发检测和渐进式扩缩(每分钟20个Pod),提前预热容量。验证显示预测准确率85%,23项检查全通过,能提前11分钟捕获高峰,且无需额外基础设施,与HPA共存。
DigitalOcean推出新一代v5 Droplets,基于第五代AMD EPYC处理器,性能较前代提升30%。用户可独立选择vCPU、内存和存储,按需付费,账单透明。支持共享和通用型配置,适用于AI、游戏服务器等负载。现有Droplet计划不变,v5已在多个地区上线。
Databricks 推出新功能,允许用户通过SSH隧道将本地VS Code、Cursor或终端连接到Databricks计算资源,实现远程运行、调试Python和SQL工作负载,并保持依赖同步。支持Serverless、AI Runtime和专用集群,兼容Cursor、Copilot等编码代理。用户可通过CLI命令或IDE扩展快速启动,提升数据工程和机器学习开发效率。
Linkerd的identity服务负责签发和轮转工作负载证书,通过CSR与Kubernetes ServiceAccount绑定实现mTLS。证书分三层:工作负载证书自动轮转,issuer和trust anchor轮转更重。与Istio SDS不同,Linkerd使用专用gRPC API,排障时先查leaf,再查issuer,最后查anchor,并注意时钟同步和跨集群信任问题。
完成下面两步后,将自动完成登录并继续当前操作。