shadcn-admin 是基于 Shadcn 和 Vite 的管理仪表板,支持亮/暗模式和响应式设计。MinerU 是开源的数据提取工具,支持多种文件格式。opentelemetry-cpp 是 C++ 的 OpenTelemetry 客户端,支持日志和追踪功能。extensions 是 Zed 编辑器的扩展集合,BricksLLM 是企业级 API 网关。
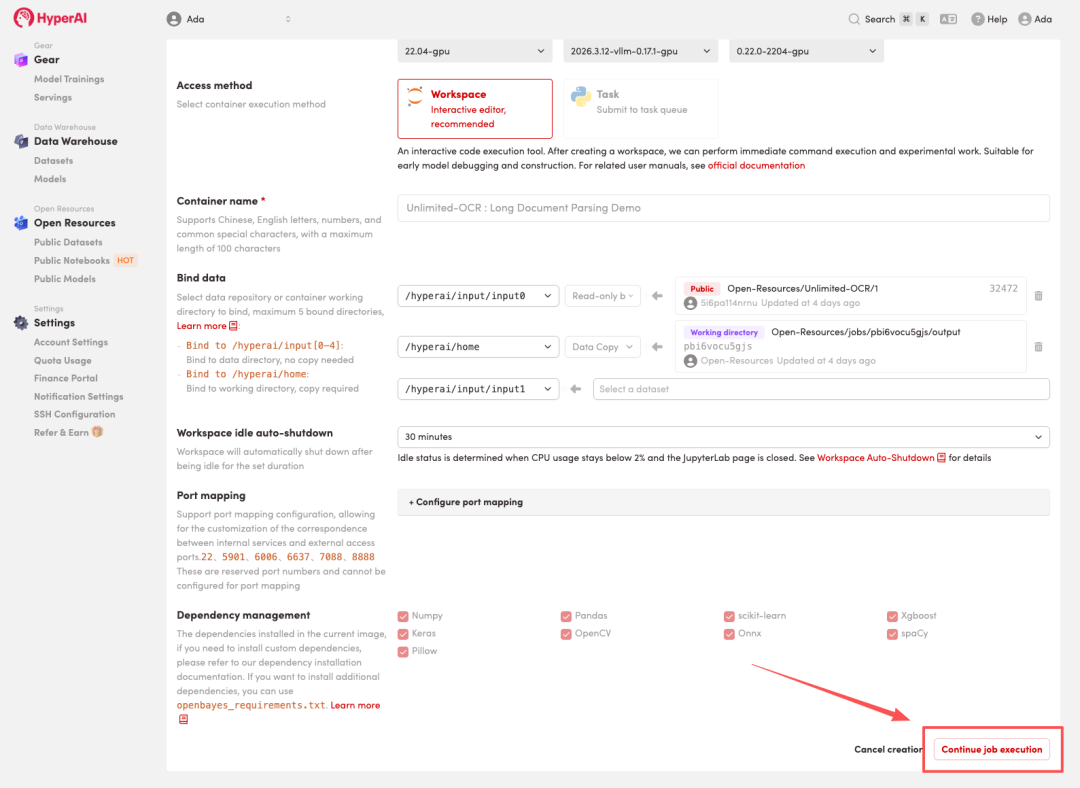
百度把OCR的桌子掀了,这一次它让模型学会像人一样“边抄边忘”! --- 摘 要:百度开源Unlimited OCR,3B参数长文档解析模型,一次前向推理吞吐几十页文档,KV Cache恒定不涨,OmniDocBench跑分93.92%,HuggingFace下载量冲到265万。本地部署零成本,直接
Snow Shot 是一款社区共同开发的开源截图工具,支持智能框选、滚动截图、OCR、AI 翻译和图片转 Markdown 等功能。该工具无会员制,截图永久免费,翻译和 AI 功能按量收费。作者回应了 OCR 采用离线 PaddleOCR、开源协议将改为双协议、未来支持自定义 API 配置等问题,并讨论了功能定位与用户反馈。
Docling 是 IBM 开源、现由 LF AI & Data 托管的文档处理工具,可将 PDF、扫描件、PPT 等格式统一转为结构化 DoclingDocument,支持导出 Markdown、JSON、HTML,并具备 OCR、表格结构识别、分块和基于 Pydantic 模式的字段提取能力,便于接入 RAG 与自动化流程。
XPhoneUse 是一款类似 Scrcpy 的手机镜像工具,并配有 Skill,可让 Codex、Claude 等 AI Agent 通过 adb 和无障碍树操作真实安卓手机。作者用 DeepSeek 模型测试,AI 成功数 App、查多邻国连胜、发微信、完成日语课,连胜从 1659 增至 1660。AI 自述称微信无障碍树为空时曾失明,遂自写 OCR 工具;它坚持看不清就停、不碰用户社交与奖励、听力题承认做不到,并修复了 shell 与坐标 bug。
Jerry Liu 开源 DocJev,将 PDF 分类与拆分分为两步:先用本地 LiteParse 免费 OCR 提取文字,再由 TypeSafe Jev 引擎按 YAML 规则决策。15 页公文包 138 毫秒完成分类,比 GPT-5.6 Luna 快约 6 倍且成本更低。40 份公文分类全部正确,8 个公文包拆分正确 7 个。支持导出独立 PDF,需 Python 3.11 及 API 密钥。
文章以发票报销工具的三次演进为例,分析AI Agent调用外部系统时的分布式系统问题:第一阶段LLM仅作OCR纯函数,分类靠人工;第二阶段引入Agent自动分类并保留人工确认;第三阶段通过Skill与MCP让Agent直接调用API,随之出现超时、状态污染、重复创建等问题,需用幂等键、状态持久化和先查后做等工程手段约束。
研究比较11种票据抽取系统,发现微调开源视觉语言模型在合成支票上F1超0.98,无需都用最大模型。选型应依据版式稳定性与错误代价:固定模板可用OCR加规则,版式多变再用VLM,样本多且字段稳定才值得微调。建议用真实文档分层测试,按字段设阈值,低置信度转人工,并保留规则基线和回归集。
Y Combinator孵化的Firecrawl团队发布开源OCR工具OCR It,可在20毫秒内将PDF文字转为Markdown,速度比Docling快300倍,支持离线使用。作为浏览器插件,用户可框选区域后手动或自动识别整份文档。但复杂版式(如表格、公式)处理能力有限,仍有提升空间。
DeepSeek推出多模态模型DeepSeek-V4-Flash-Vision-Exp,图片最多占384个Token,通过三级压缩技术大幅降低成本。模型侧重OCR和图像描述,非人脸识别,故认错人属设计初衷问题。API成本可预测,推理快,多模态能力接近Opus-4.8,体现低价高效理念。
作者开发了Inkive应用,解决纸书划线笔记数字化难题。通过本地图像分割模型识别划线(准确率0.94),结合PPOCR读取文字,并优化“可接纳率”至95%,最终将书摘导出为Markdown,无缝连接Obsidian。应用坚持本地处理,保护隐私,已上架App Store。
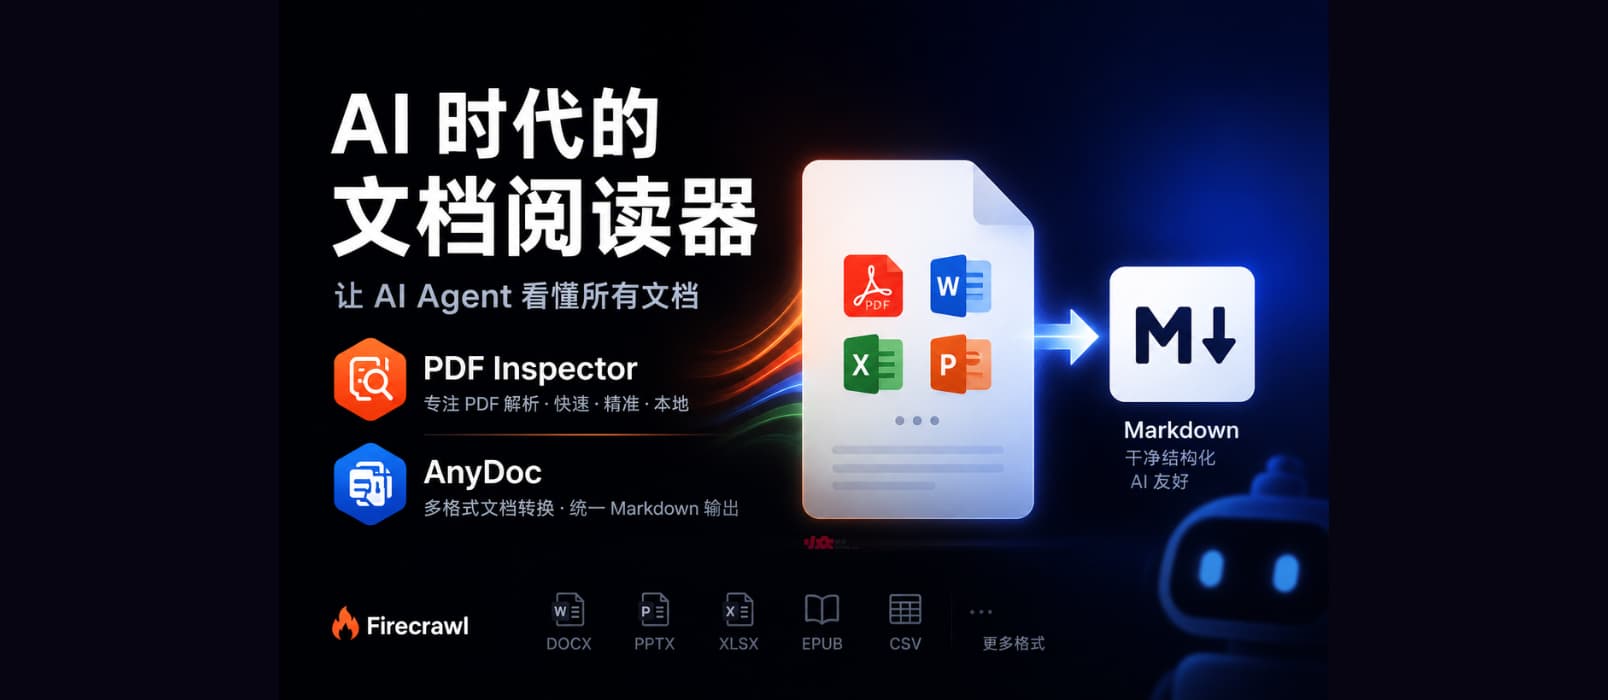
Firecrawl 开源了 PDF Inspector 和 AnyDoc 两个项目,用于将 PDF、Word、Excel 等文档高效转换为 AI 可读的 Markdown。PDF Inspector 用 Rust 编写,智能分析 PDF 结构,区分文本和图片,仅对扫描页使用本地 OCR(PP-OCRv6),降低成本。AnyDoc 支持多种格式,统一表格、标题等输出结构,并支持 AI 操作,纯本地运行,无需 API,提升 AI 处理文档的效率和准确性。
中国AI开源模型引发全球关注。月之暗面发布Kimi K3登顶Hugging Face趋势榜,百度Unlimited OCR五天内GitHub Star破万,获图灵奖得主转发,一个月后重回榜首。其创新R-SWA机制解决长文档解析痛点,控制KV Cache规模,提升效率。中国AI开源从“发布即关注”迈向“持续被采用”,展现全球影响力。
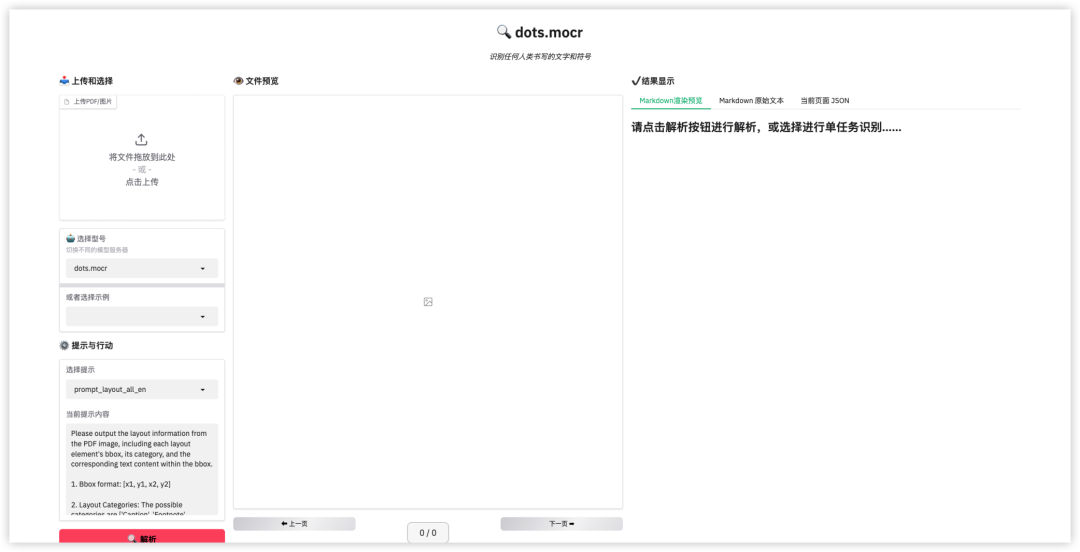
随着大模型的发展,OCR技术成为连接视觉数据与智能应用的重要工具。新一代多模态模型整合了文字识别和信息抽取等功能,推动了OCR在科研、金融和医疗等领域的应用。本文介绍了五款开源OCR模型,包括Unlimited-OCR、Chandra-ocr-2、dots.mocr、Qianfan-OCR和FireRed-OCR,适用于文档解析和手写文字处理等场景,帮助开发者选择合适的解决方案。
本文介绍了如何使用JavaScript构建基于浏览器的PDF OCR文本转换器。该工具允许用户上传PDF文件,预览页面,配置OCR设置,提取文本并导出结果。OCR技术能够识别扫描图像中的文本并将其转换为可编辑的数字文本,确保用户隐私和安全。通过优化图像质量和选择合适的OCR语言,可以提高识别准确性。
Godcoder 是一个本地优先的 Rust 编码助手,强调自我迭代和优化,支持代码修改和 GUI 自动化。franken_ocr 是一个纯 Rust 的 OCR 引擎,专注于无依赖的文档解析。QCue 是一个知识管理工具,将碎片化信息转化为可检索的 Markdown Wiki。ipatool-rs 重写了 IPA 下载工具,适应 Apple 新认证流,提供完整的下载链路。
近年来,OCR 技术已从简单的文字识别发展为完整的文档理解。新一代 DeepSeek OCR 模型通过引入大语言模型,提升了识别准确率和复杂版面解析能力。百度的 Unlimited OCR 解决了传统 OCR 的效率低和上下文割裂问题,采用 R-SWA 机制,降低计算成本,支持长文档的高效处理,并可扩展至其他任务。
百度推出的Unlimited OCR模型在长文档处理上刷新了SOTA,采用参考滑动窗口注意力机制,模拟人类阅读方式,解决了传统OCR的显存膨胀问题。该模型在OmniDocBench上表现优异,推理效率提升35%,并计划扩展到语音识别和机器翻译等任务。
PDF仍是商业中常用的文档格式,但数据提取困难且易出错。Python成为自动化PDF数据提取的有效工具,开发者可以利用其库提取文本和表格,并处理扫描文档。文章探讨了如何使用Python进行PDF数据提取,包括环境设置、文本和表格提取、OCR处理等,强调了自动化在提高效率和减少错误方面的重要性。
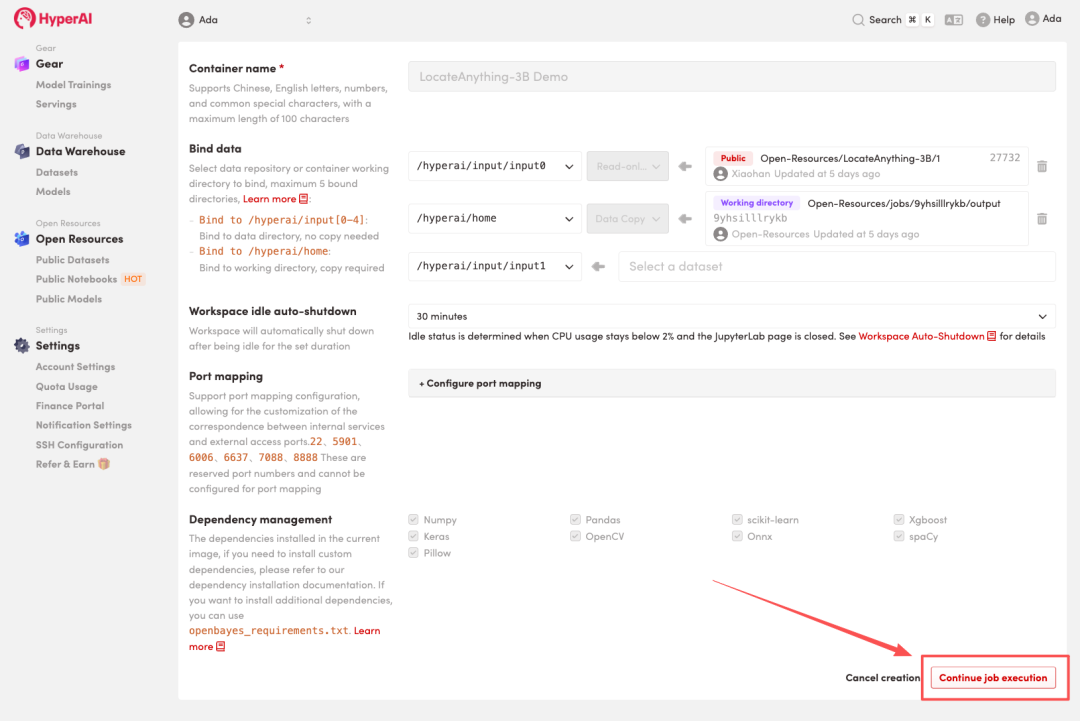
NVIDIA 最近推出了视觉语言定位模型LocateAnything-3B,拥有30亿参数,支持多种视觉定位任务。其核心创新为并行框解码(PBD),显著提升了定位精度和解码速度,尤其在复杂场景下表现优异,推动了视觉定位技术的发展。
完成下面两步后,将自动完成登录并继续当前操作。