Databricks宣布Genie Ontology正式可用。该“智能体本体”由AI智能体自动从仪表盘、SQL、笔记本及Power BI等来源学习业务上下文,关键定义由人员通过Unity Catalog治理,OntoRank按权威性排序为智能体提供可信上下文。与Turing合作的基准显示,Genie正确率达91%,远超前沿智能体的45%和58%,且更省token、更快。新功能包括Genie Search、组织目录、域管理和Ontology Manager。
Databricks与Turing合作开发企业数据智能体基准,在真实Databricks工作区对比Genie与两个前沿智能体。Genie借助Genie Ontology理解企业业务知识,正确率达91%,另两者仅45%和58%;速度分别快4倍和3倍,token用量不到一半。该基准包含笔记本、仪表板、SQL查询等企业知识资产,更贴近真实场景,表明上下文对企业数据智能体至关重要。
柯基数据为医药行业提供可信知识服务,其GraphRAG智能体基于Strands Agents开发,托管于Amazon Bedrock AgentCore Runtime,使用AgentCore Memory管理对话记忆,接入Amazon Nova模型,并通过Bedrock Guardrails进行合规过滤。迁移仅由1名工程师约两周完成,检索推理逻辑基本未重写。上线前使用AWS Continuum对公网入口进行渗透测试,共发现21项问题,无高危或严重问题,14项中危问题已全部修复。随着AgentCore在中国区域上线,柯基正推进中国区域部署。
Prasanna Vijayanathan, Renzo Sanchez-SilvaWhen Jake Paul and Mike Tyson stepped into the ring in November 2024, we delivered the fight to roughly 65 million concurrent streams. On an ordinary day...
Prasanna Vijayanathan and Renzo Sanchez-Silva share how Netflix tackles observability across 38M events/sec. They discuss replacing reactive monitoring with an AI-driven operational ontology and...
Databricks推出Genie Ontology,为Genie提供企业业务上下文,整合Unity Catalog治理指标、仪表盘、文档等来源并按权威性排序。产品团队借此每周自动生成采用率报告、调查趋势、预测并创建智能体,提升分析效率与治理合规性。
Palantir的AI FDE于2026年3月进入通用可用阶段,可在Foundry平台内自主完成数据工程、本体编辑与治理审计。文章指出,Ontology并非语义层,而是数据、逻辑、行动与安全的四重整合,是企业AI的核心基础设施。AI FDE不替代人类FDE,而是改变其工作方式:AI负责从0到80分的工程执行,人类负责业务判断与信任建立。FDE模式成本高昂、难以规模化,中国企业无法直接使用,但可借鉴其从具体痛点倒推的思维方式,找到自己的最小闭环。
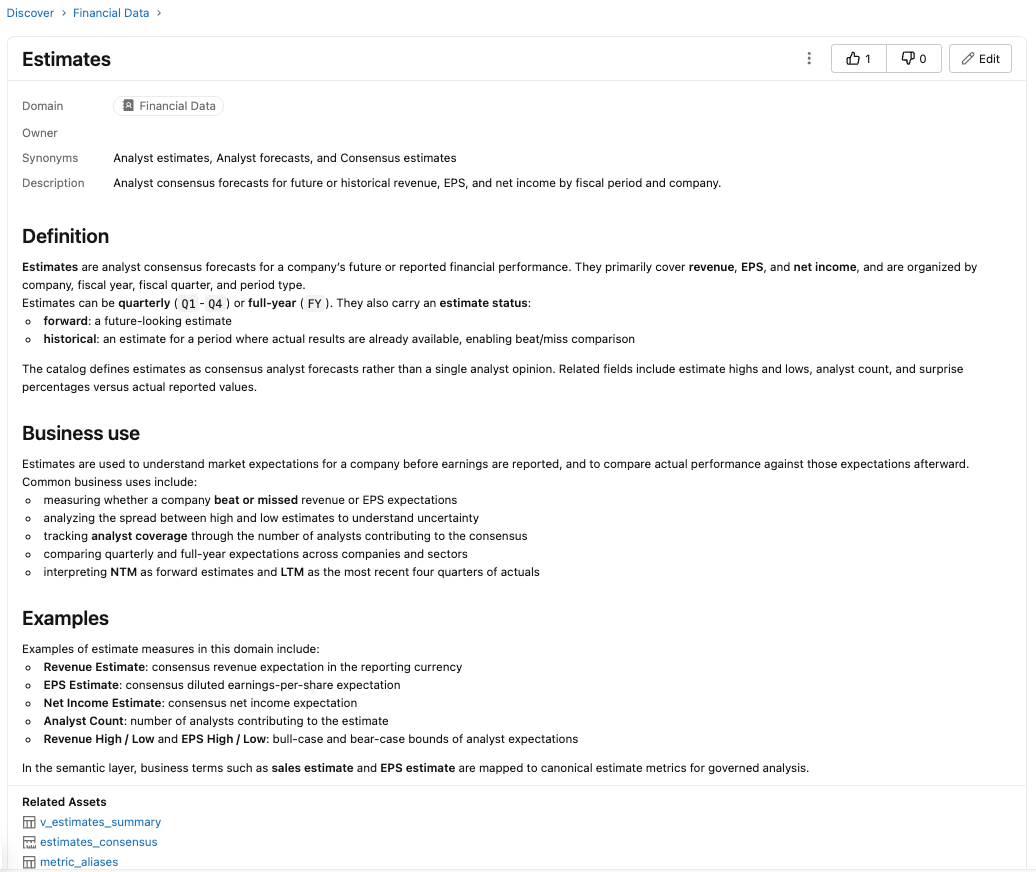
Databricks推出Unity Catalog Pages,作为Genie Ontology的人工策展层,允许数据管理员定义企业术语的权威含义供AI代理使用。Pages结合结构化字段与丰富内容,可关联数据资产,并支持Genie Code从Confluence等来源批量导入生成,确保AI基于可信业务上下文回答。目前处于Beta阶段。
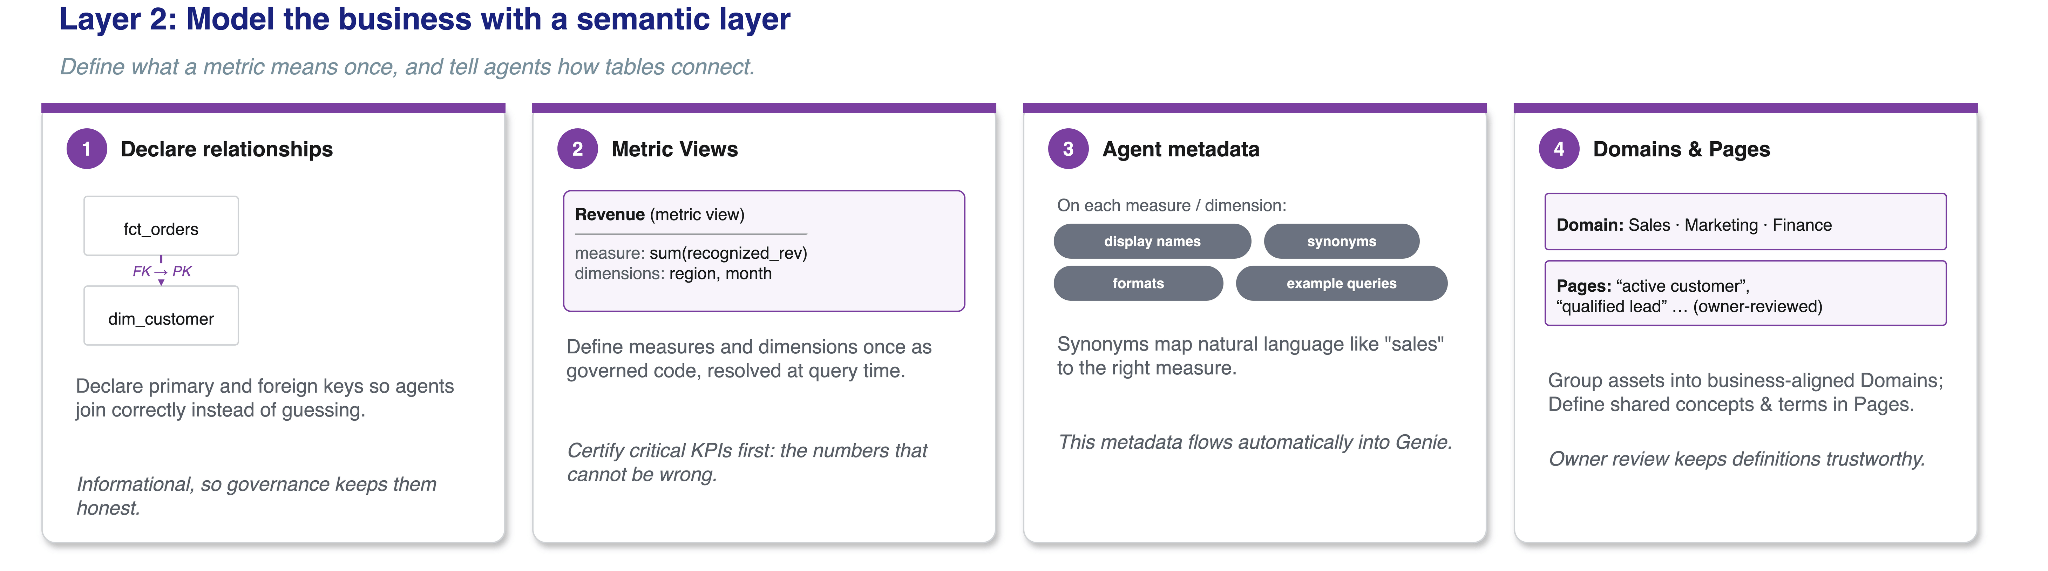
本文介绍Databricks Genie Ontology的实践指南,强调通过六层渐进式实践(数据基础、语义建模、上下文、治理、评估等)提升企业AI回答质量。核心是结合语义模型与推断上下文,从单一高价值领域起步,逐步扩展,确保数据可信、治理安全,并通过持续评估优化,建立用户信任。
本文探讨了DDD在数字员工时代的局限性。DDD主要解决人与代码间的语义一致性问题,但无法应对机器执行时的语义歧义,导致数字员工对“新增有效客户”等概念理解错误。文章提出在DDD之上增加Ontology语义层,作为机器可读的运行手册,以解决跨边界语义统一和精确表达问题。
Genie One是一款数据智能AI助手,旨在帮助企业用户从洞察转向行动。它集成于Slack和Microsoft Teams,用户可通过自然语言提问快速获得准确答案。此外,Genie还推出了移动应用,方便用户随时访问数据。Genie Agents是特定领域的AI代理,帮助团队利用数据做出更好的决策。Genie Ontology自动提取和组织知识,提高数据分析的准确性和效率。
Prasanna Vijayanathan and Renzo Sanchez-Silva, both Engineers at Netflix, presented “Ontology‐Driven Observability: Building the E2E Knowledge Graph at Netflix Scale” at QCon London 2026, where...
三元组和本体在智能体应用中各有优势。三元组基于RDF标准,适合开放数据网络,灵活性高;而本体则更适合企业决策,具备行动能力。选择取决于具体目标,二者并不竞争。
微软的Azure Digital Twins(ADT)与Palantir Ontology在技术和商业模式上截然不同。ADT侧重于开放建模和云服务,而Palantir则是封闭平台,专注于实时运营。两者无关联,适用场景各异,选择时需二选一。
本研究探讨大型语言模型在特定领域本体生成中的应用,评估DeepSeek和o1-preview模型的表现,发现它们在本体构建方面具有良好的泛化能力,为自动推理和知识表示技术的改进提供了基础。
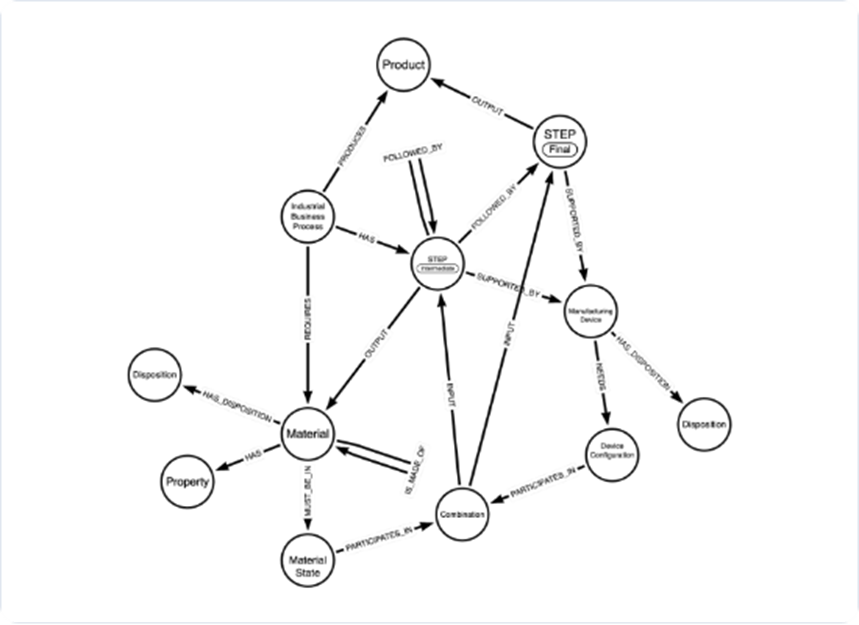
本研究提出了过程知识本体(PKO),旨在解决工业公司中过程知识未被有效利用的问题,以支持过程管理并促进人工智能和数据驱动工具的应用。
本研究提出循环建筑产品本体(CCPO),旨在改善建筑行业的生命结束产品管理。通过标准化词汇和数据整合,CCPO 支持生命周期评估,提升 EoL 决策效果,推动循环经济发展。
本研究提出了一种新方法,将大型语言模型应用于知识图谱匹配,通过匹配实例子图的相似环境生成对应关系,显著提升模型性能,F-measure提高了45%。
本研究提出了一种名为本体指导的逆向思维(ORT)的新框架,旨在解决大型语言模型在知识图谱问答中的多跳推理问题。ORT通过反向构建推理路径,显著提升了LLMs在KGQA任务中的表现。
本研究提出了一种名为OntoSCPrompt的两阶段架构,旨在提升知识图谱问答(KGQA)在新知识图谱上的泛化能力。该方法通过分离语义解析与知识图谱特定交互,并采用本体指导的混合提示学习策略,实验结果表明其在资源有效的情况下与先进方法性能相当,且能够有效泛化至未见领域的知识图谱。
完成下面两步后,将自动完成登录并继续当前操作。