


重排序提升搜索效果
内容提要
本文介绍在Qdrant向量数据库中结合重排序提升RAG检索精度:先通过向量检索获取高召回候选,再用Cohere Rerank或ColBERT等模型按相关性重新排序以提高精确率。文中以Cohere为例演示创建集合、生成嵌入、检索与重排的完整流程,并指出重排可显著改善约72%查询的顶部结果。
延伸解读
重排序如何平衡精度与召回
在搜索系统中,精度和召回是两个关键指标。稀疏向量搜索通常精度高,但召回可能不足;稠密向量搜索召回好,但精度可能较低。重排序通过先以稠密向量检索获取高召回候选,再对顶部结果重新排序,从而在不牺牲召回的情况下提升精度。文章指出,重排序可改善约72%查询的顶部结果,有效平衡了搜索质量。
重排序模型的类型与选择
重排序模型主要有三种类型:交叉编码器模型,通过分类系统评估查询-文档对,输出相似度分数,但需要同时处理查询和文档;多向量重排序器(如ColBERT),分别编码查询和文档,减少计算负载,支持预计算;以及使用大语言模型作为重排序器,利用其语言理解能力进行更智能的排序。选择时需权衡精度、速度和资源消耗。
实现重排序的实践要点
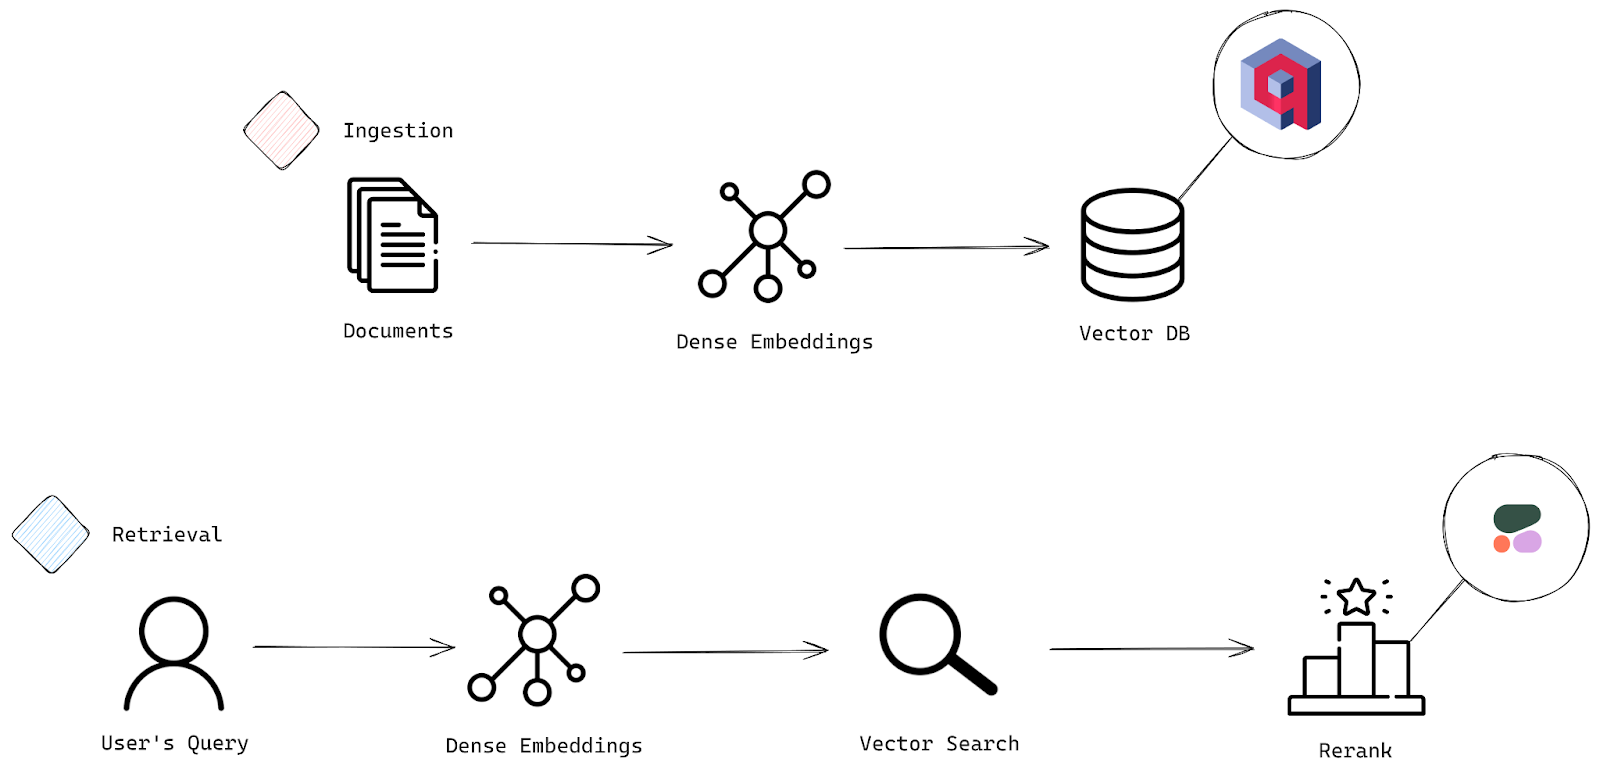
文章以Cohere为例演示了在Qdrant中实现重排序的流程:创建集合、生成嵌入、向量检索和重排序。关键步骤包括使用Cohere的embed-english-v3.0生成1024维嵌入,通过Qdrant进行向量搜索获取前10个结果,再用rerank-english-v3.0模型重新排序并返回前5个。注意,重排序会增加延迟,但能显著提升顶部结果的相关性。
Q&A
重排序在RAG系统中有什么作用?
重排序可以提升搜索结果的精确率,确保语言模型获得最相关、上下文丰富的文档,从而改善生成输出的准确性。
重排序如何平衡精确率和召回率?
重排序先通过向量检索获取高召回候选,再对顶部候选按相关性重新排序,从而在不损失召回率的情况下提高精确率。
重排序模型有哪些类型?
重排序模型主要分为三类:交叉编码器模型、多向量重排序器(如ColBERT)以及使用大语言模型作为重排序器。
使用重排序能带来哪些好处?
重排序能增强搜索准确性(约72%的查询顶部结果得到改善)、减少信息过载,并平衡速度与相关性。
如何在Qdrant中实现基于Cohere的重排序?
首先创建集合、生成文档嵌入并上传,然后对查询生成嵌入并进行向量搜索获取候选,最后使用Cohere的rerank模型对候选文档重新排序。
重排序有什么局限性?
重排序可能较慢,处理数百万文档可能需要数小时,因此它专注于精炼结果而非搜索整个文档集合。
