

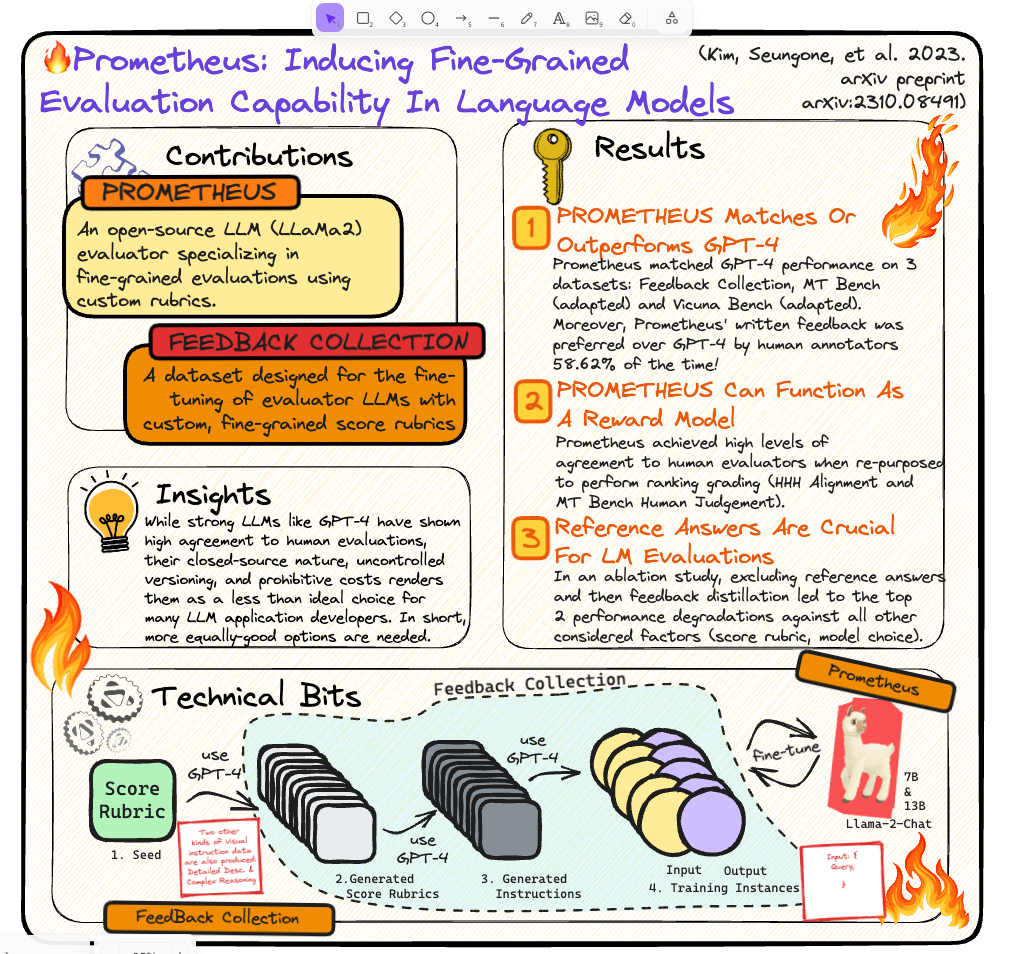

LlamaIndex:RAG评估对决——GPT-4与开源Prometheus模型
内容提要
本文探讨了如何利用开源的Prometheus模型评估检索增强生成(RAG)管道,重点在于通过正确性、忠实性和相关性三个标准来评估生成的答案。与GPT-4相比,Prometheus提供了更详细的反馈,但有时评估不够准确。总体而言,Prometheus在反馈的严格性上优于GPT-4,但可能导致更多错误解释。
延伸解读
评估成本与部署考量
文章指出,Prometheus模型的评估成本约为1.5美元,而GPT-4约为15美元,成本优势明显。但Prometheus需要自行托管在Hugging Face推理端点,使用Nvidia A100 GPU(80GB内存),每小时成本约6.5美元。因此,实际总成本取决于使用频率和规模,高频评估时Prometheus可能更经济,但需考虑基础设施维护。
评分严格性与准确性权衡
在正确性评估中,Prometheus对缺失信息的惩罚更严格,例如当生成答案遗漏参考中的关键点时,它给出3.0分,而GPT-4给出4.5分。这种严格性有助于发现细微缺陷,但也可能导致评分偏低。同时,Prometheus在忠实性和相关性评估中出现了更多错误解释,如误判上下文中存在的参数范围。因此,选择评估模型时需在严格性和准确性之间权衡。
模型一致性分析
通过汉明距离比较,Prometheus与GPT-4在忠实性评估中有约42%的评分一致,在相关性评估中约59%一致。这表明两者在相关性判断上一致性更高,但整体一致性仅为中等水平。读者在切换评估模型时,应注意评分标准差异可能对结果产生的影响,尤其是在需要跨模型比较的长期项目中。
使用建议与注意事项
文章建议谨慎使用Prometheus,因其反馈虽详细但偶尔不准确。对于需要高准确性的场景,GPT-4仍是更可靠的选择;而对于成本敏感或需要严格评分的场景,Prometheus可作为补充。此外,量化版本的Prometheus可能产生更多幻觉,建议使用原版模型。评估时应结合具体指标和业务需求选择合适的模型。
Q&A
Prometheus模型与GPT-4在评估反馈上有什么主要区别?
Prometheus模型提供了更详细的反馈,但有时评估不够准确,尤其在缺失信息时更严格,而GPT-4在忠实性和相关性评分上表现更好,反馈更准确。
评估检索增强生成(RAG)管道时使用的标准是什么?
评估标准包括正确性、忠实性和相关性,分别检查生成答案与参考答案的一致性、答案对检索上下文的忠实程度以及答案与查询的相关性。
Prometheus模型的评估成本是多少?
Prometheus模型的评估成本约为1.5美元,而GPT-4的成本约为15美元。
在正确性评估中,Prometheus模型和GPT-4的评分分布有什么不同?
Prometheus模型的评分分布中,3.0分占56%,而GPT-4的评分分布中,4.5分占57.99%。
为什么Prometheus模型在反馈中可能导致更多错误解释?
Prometheus模型在反馈的严格性上优于GPT-4,但其严格的评分标准可能导致对生成答案的更高惩罚,从而增加错误解释的可能性。
如何使用Prometheus模型进行评估?
使用Prometheus模型进行评估时,需要定义评估管道、下载数据集、设置模型并定义评估模板,然后运行正确性、忠实性和相关性评估。
