


语义化边输入边搜索
内容提要
本教程介绍用 Qdrant 构建语义化“边输入边搜索”服务,包含三项优化:前缀缓存预计算短前缀向量,使短查询无需嵌入模型;批量查询按标题文本、正文文本、标题语义、任意语义排序;缓存与嵌入路径并发执行,缓存未命中也不增加往返。示例使用 Python、FastEmbed 和 MiniLM 模型,涵盖建集合、索引、缓存、查询与性能说明。
延伸解读
前缀缓存如何避免嵌入计算
文章指出,短前缀查询可直接从缓存获取向量,无需运行嵌入模型。具体做法是将常见短前缀的向量预计算并存入独立集合,查询时通过 recommend 查询和 lookup_from 从缓存集合读取向量,再在站点集合中搜索。这省去了嵌入步骤,是降低延迟的关键。
批量查询的优先级排序策略
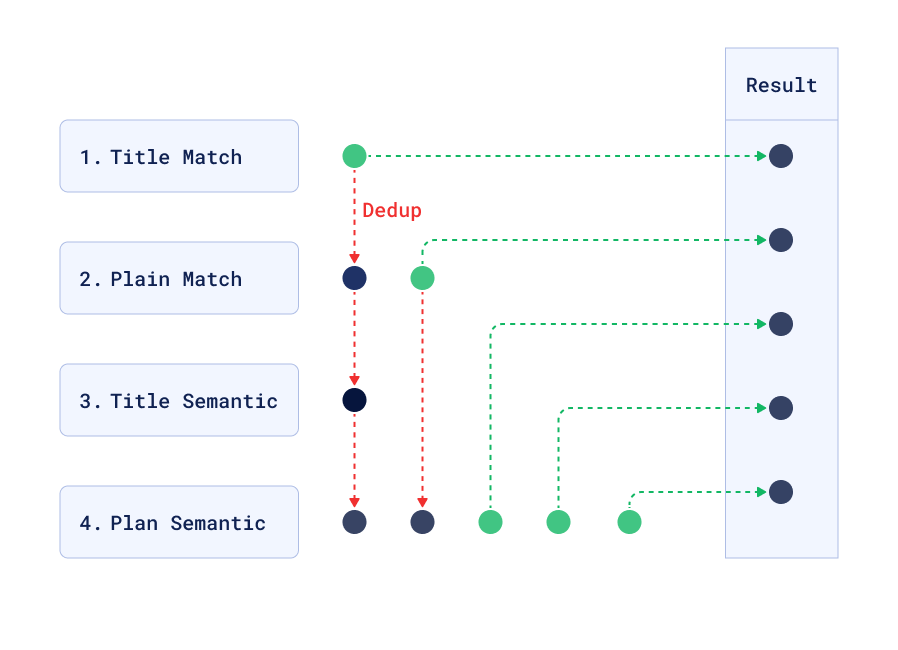
为提升结果相关性,服务将四个查询合并为一个批量请求,按顺序返回:标题文本匹配、正文文本匹配、标题语义匹配、任意语义匹配。合并时按优先级去重,保留前五个结果。这样既无额外网络开销,又能让精确匹配和标题优先展示。
并发回退机制与缓存未命中处理
当短前缀不在缓存中时,若先查缓存再嵌入会产生两次往返。文章采用并发策略:同时启动缓存路径和嵌入路径,取第一个非空结果。缓存未命中时,嵌入路径仍能返回结果,且不会增加额外延迟。这以少量额外负载换取了更稳定的响应速度。
性能数据与适用场景提醒
文章引用 2023 年基准测试:在本地 AMD Ryzen 9 5900HX 上,Rust 服务缓存命中约 1.5 毫秒,长查询约 5 毫秒;Python 服务两者均约 16 毫秒。这些数据来自不同服务,并非 Qdrant 基准。边输入边搜索的负载是普通搜索的 3 到 5 倍,网络延迟通常占主导,但毫秒级优化仍影响输入体验。
Q&A
如何用 Qdrant 实现语义化的边输入边搜索?
使用 Qdrant 构建语义化边输入边搜索服务,核心是三项优化:前缀缓存预计算短前缀向量,使短查询无需嵌入模型;批量查询按标题文本、正文文本、标题语义、任意语义排序;缓存与嵌入路径并发执行,缓存未命中也不增加往返。示例使用 Python、FastEmbed 和 MiniLM 模型。
前缀缓存如何加速短查询?
前缀缓存预先计算并存储常见短前缀的嵌入向量。当用户输入短前缀时,直接通过 recommend 查询和 lookup_from 从缓存中读取向量,无需调用嵌入模型,从而跳过嵌入步骤,显著降低延迟。
批量查询如何对搜索结果进行优先级排序?
在一个批量请求中发送四个查询,按顺序合并结果:1. 标题中的文本匹配;2. 正文中的文本匹配;3. 标题中的语义匹配;4. 任意语义匹配。合并时去重并保留前五个结果,确保精确匹配和标题优先。
缓存未命中时如何避免额外的网络往返?
同时启动缓存路径和嵌入路径,并采用第一个非空结果。即使缓存未命中,嵌入路径也会并行执行,因此不会增加额外的往返时间。
构建前缀缓存时,点 ID 是如何生成的?
点 ID 由前缀的 UTF-8 字节直接转换为无符号 64 位整数。因为短前缀不超过 8 字节,可以容纳在 64 位整数中,从而支持通过 ID 直接查找嵌入向量,无需搜索或索引。
边输入边搜索的性能表现如何?
根据 2023 年的基准测试,在本地 AMD Ryzen 9 5900HX 上,Rust 服务处理缓存命中的短查询平均耗时 1.5 毫秒,长查询 5 毫秒;Python 服务均为 16 毫秒。缓存命中因跳过嵌入步骤而更快。边输入边搜索的负载是普通搜索的 3 到 5 倍。
