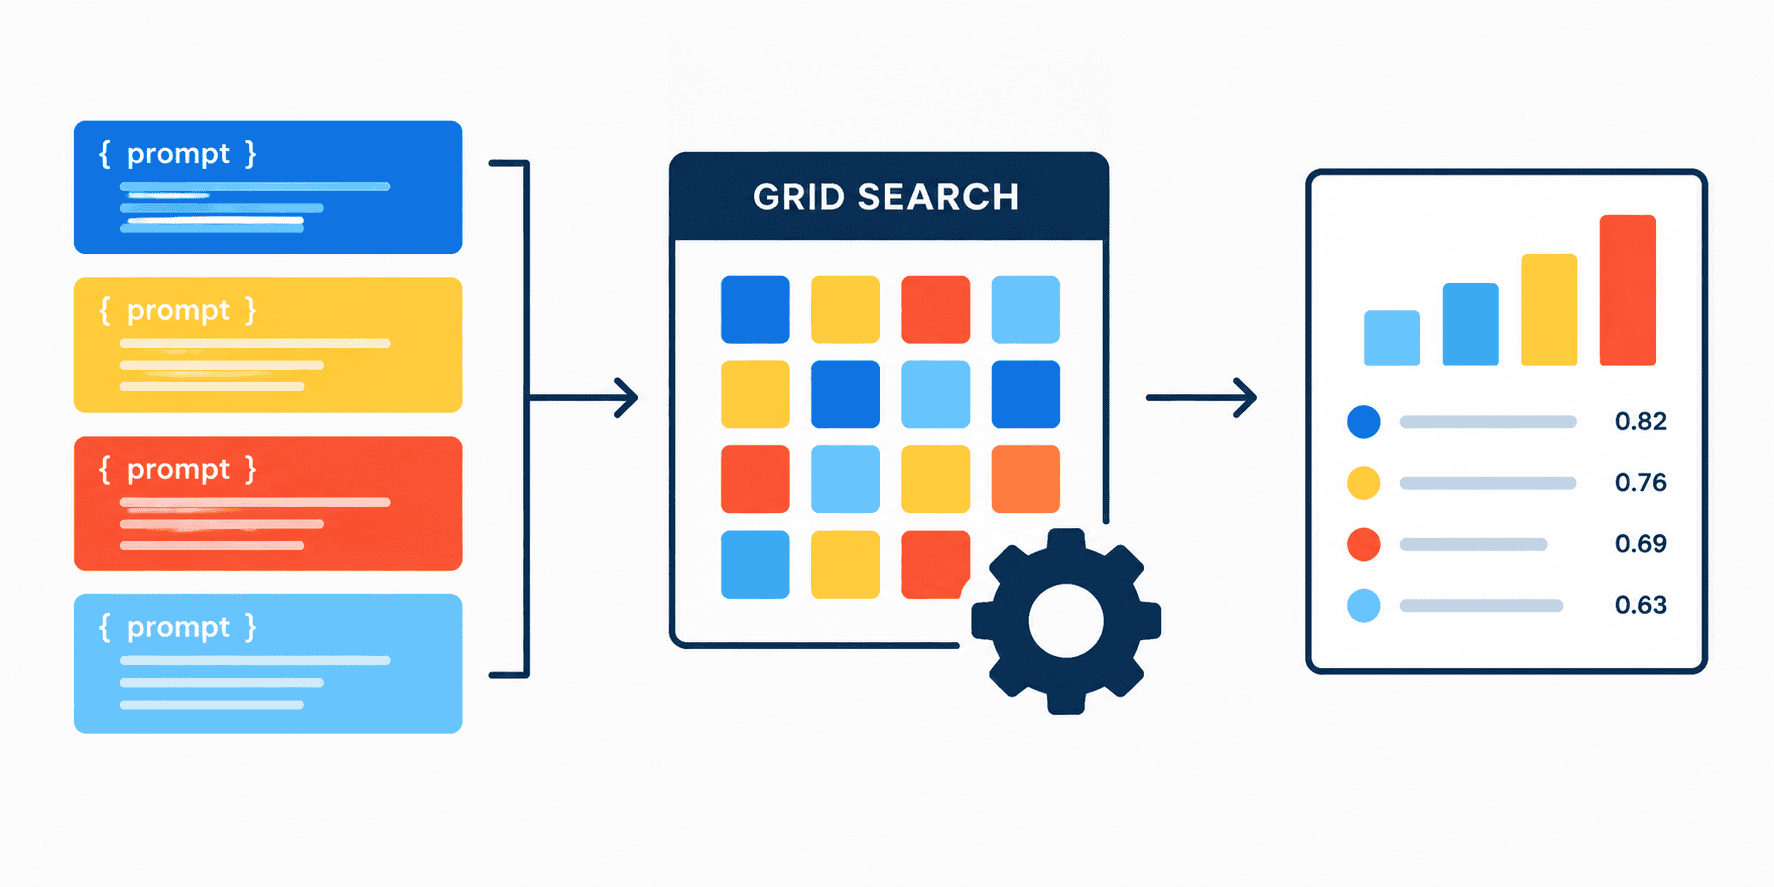

在Scikit-LLM GridSearchCV中将提示模板视为超参数
内容提要
本文介绍将提示模板作为可调超参数,通过scikit-learn的GridSearchCV为语言模型寻找最佳提示。作者把模型封装成兼容scikit-learn的零样本分类器,定义候选提示网格,在小型情感数据集上交叉验证网格搜索,选出准确率最高的提示模板。
延伸解读
将提示模板纳入超参数搜索的实用价值
文章展示了如何把提示模板当作超参数,用GridSearchCV系统化地寻找最佳提示。这种方法让提示工程从手动试错转向可复现的自动化流程,尤其适合零样本分类任务。通过交叉验证评估不同提示的准确率,能减少主观选择带来的偏差,为后续更大规模实验提供可借鉴的框架。
实现中的关键工程细节
作者将语言模型封装成scikit-learn兼容的分类器,并强调两个优化点:模型只加载一次以避免重复开销,以及将提示格式化为聊天消息以引导模型遵循指令。这些细节对实际运行效率有直接影响,也提示读者在自定义封装时需注意模型加载位置和交互格式,否则可能影响结果或执行速度。
小数据集实验的局限与解读
文章使用仅含四个样本的玩具数据集,交叉验证仅两折,最佳提示的准确率为75%。作者明确提醒,数据集和候选提示越多,结果越可靠。因此,读者应将该示例视为方法演示,而非性能结论。在实际应用中,需扩大数据规模并增加提示多样性,才能得到有统计意义的比较。
Q&A
如何把提示模板当作超参数,用 Scikit-LLM 的 GridSearchCV 来搜索最佳提示?
需要将语言模型封装成兼容 scikit-learn 的零样本分类器,把提示模板作为可调超参数,定义候选提示网格,然后用 GridSearchCV 进行交叉验证网格搜索,选出准确率最高的提示模板。
在 Scikit-LLM 中,如何让语言模型兼容 scikit-learn 的 GridSearchCV?
通过继承 scikit-learn 的 BaseEstimator 和 ClassifierMixin 创建自定义分类器类,在 __init__ 中接收生成器和提示模板,实现 fit 和 predict 方法,使模型能像普通 scikit-learn 分类器一样被 GridSearchCV 使用。
用 GridSearchCV 搜索最佳提示模板时,如何定义候选提示网格?
在 param_grid 字典中,以 'prompt_template' 为键,值为一个包含多个候选提示模板字符串的列表,每个模板使用 {text} 占位符表示待分类文本。
在小型情感数据集上,用 GridSearchCV 搜索提示模板的结果如何解读?
运行后可以获取最佳提示模板和最佳交叉验证准确率。例如在示例中,最佳模板是 'Analyze this review. Output 'positive' or 'negative': {text}',最佳交叉验证准确率为 75.0%。
将提示模板视为超参数进行网格搜索时,有哪些注意事项?
数据集和候选提示模板越多,实验结果越可靠;示例中使用小数据集仅为便于快速运行。此外,可以预先加载模型以避免重复加载,并将提示格式化为聊天消息以引导模型遵循指令。
这种方法与传统的超参数优化有何异同?
相同点是都使用网格搜索等搜索算法寻找最优配置;不同点在于传统方法调整模型参数,而这里调整的是自然语言提示模板,属于系统化提示工程。
