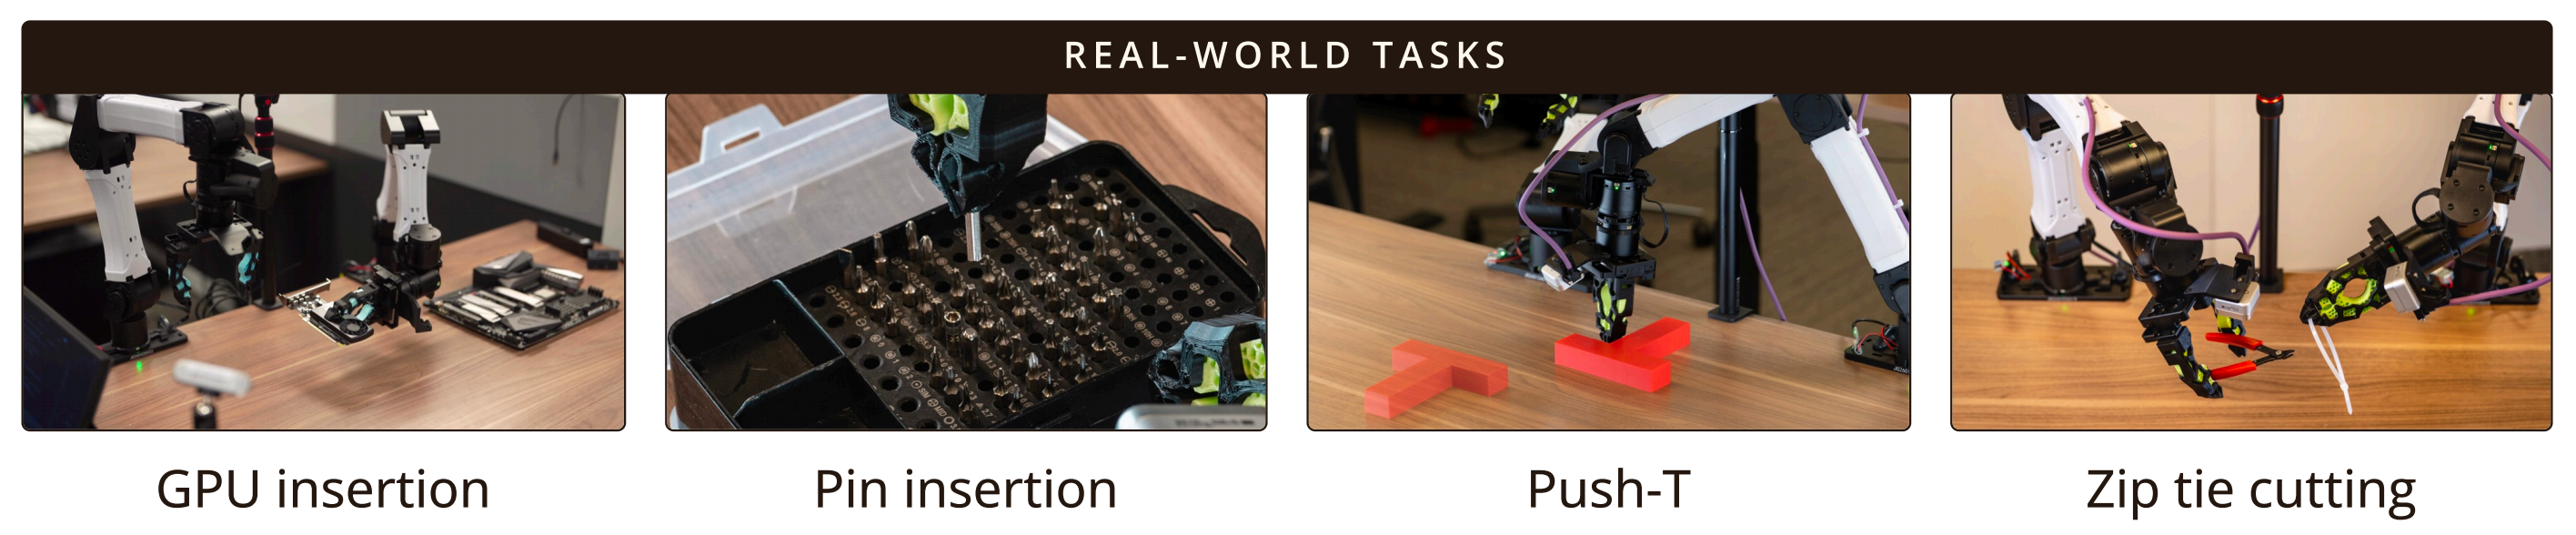
ENPIRE——现实世界中具身智能体机器人策略的自我改进(具身RSI的代表之一):
内容提要
ENPIRE是面向真实机器人策略自改进的智能体框架,分两阶段:先由编码智能体根据少量人类示范自动构建安全约束、自动验证与自动复位环境;再让智能体在真实反馈下自主改进训练算法,并支持多机器人并行加速。该框架将搭建自动化设施本身也自动化,减少人工干预,适用于可程序验证与复位的任务。
延伸解读
与π*0.6和R3L的关键区别
ENPIRE与π*0.6的RECAP框架不同:RECAP需要人工打标成败来提供反馈,而ENPIRE通过编码智能体自动合成二值奖励函数,实现自动验证。与R3L相比,R3L的自动奖励、复位和安全约束均为人工为每个任务搭建,且不涉及训练算法改进;ENPIRE则将搭建自动化设施本身也自动化,并增加Evolution模块迭代训练算法,减少人工干预。
两阶段自动化研究流程
ENPIRE分两阶段:第一阶段(EN)由编码智能体根据少量人类示范,通过工具调用构建安全约束、自动验证和自动复位环境,形成不可变API;第二阶段(PIRE)中,智能体在真实反馈下自主改进训练算法,并支持多机器人并行加速。该框架将环境搭建与策略改进均自动化,人类仅需一次性投入几分钟示范和指标要求。
适用边界与当前局限
ENPIRE将可程序验证与可程序复位视为进入自动闭环的分水岭。能通过验证和复位的任务可走智能体自动环,而柔性体、液体、长程任务等难以程序化验证或复位的场景,目前仍依赖RECAP式人工兜底。因此,ENPIRE并非通用方案,其优势集中在可程序化验证与复位的任务上。
资源利用与扩展性指标
ENPIRE通过多机器人并行加速,随着智能体-机器人对数量增加,达到相同性能的实际时间减少。为衡量效率,作者提出平均机器人利用率(MRU)、GPU利用率和平均token利用率(MTU)等指标。但实证显示,前沿编码智能体的MRU和GPU利用率均未达到饱和值1,表明资源利用仍有提升空间。
Q&A
ENPIRE是什么?它和π*0.6的RECAP方法有什么本质区别?
ENPIRE是一个面向真实机器人策略自改进的智能体框架,通过四个核心模块实现物理反馈闭环:Environment模块自动重置与验证结果,Policy Improvement模块启动策略改进,Rollout模块在真实机器人上评估策略,Evolution模块让编码智能体分析日志、查阅文献并改进训练算法。与π*0.6的RECAP相比,ENPIRE的本质区别在于:RECAP需要人工打标(标注成功/失败)来提供反馈,而ENPIRE能自动合成奖励函数和复位程序,连搭建自动化设施本身也自动化了,人工只需提供几分钟示范和指标要求。
ENPIRE的两个阶段分别是什么?各自如何工作?
ENPIRE分为两个阶段:第一阶段(EN in ENPIRE)是基于人类反馈的环境构建,编码智能体根据少量人类示范,通过过程化工具调用自动构建安全约束、自动验证和自动复位机制,形成环境API,这些API在后续阶段作为不可变接口复用。第二阶段(PIRE in ENPIRE)是基于真实世界反馈的自动策略改进,编码智能体在环境自动验证信号的指引下,自主探索和优化训练算法(如行为克隆或强化学习),无需人工干预,最大化真实世界任务成功率。
ENPIRE如何实现自动奖励反馈和自动复位?
ENPIRE通过编码智能体合成二值奖励函数来实现自动验证:在仅给定几分钟成功与失败示范的情况下,智能体利用视频和本体感知记录,合成能区分任务结果的奖励函数,例如为插销任务发现基于视觉对齐、末端执行器高度和力估计的鲁棒奖励函数。自动复位方面,智能体执行一系列工具调用将环境恢复到初始状态,对于高接触任务,借鉴CaP-X思路,使用模块化操作技能将环境直接重置到任务中最具挑战性的阶段起点,从而将学习注意力集中在精度要求高的瓶颈环节。
ENPIRE如何通过多机器人并行加速策略改进?
ENPIRE通过启动并行的、多智能体的去中心化协作协议来加速物理层面的自动化研究。该协议在N台实体机器人上部署N个智能体,以异步方式测试N个假设。每个智能体从同一套基线策略训练代码库分支出来,通过Git自主协作,扩展进化模块(E in ENPIRE)。智能体会自发地从其他智能体中“挑拣”、复制或合并成功的训练配方,以优化代码搜索。实证表明,随着并行的“智能体-机器人”对数量增加,发现高成功率策略配方的实际耗时大幅缩短。
ENPIRE适用于哪些任务?有哪些局限性?
ENPIRE适用于可程序验证与可程序复位的任务,例如Push-T和Pin Insertion等任务。文章指出,具身RSI的天然优势是物理执行反馈可以自动拿到,因此ENPIRE类工作把可程序验证+可程序复位当作能否进入自动闭环的分水岭。能通过验证和复位的任务可以走智能体闭环,而过不去的任务(如柔性体、液体、长程任务)目前还是RECAP式人工兜底最通用。
ENPIRE与R3L有什么区别?
R3L(2020)的目标和ENPIRE几乎一模一样:让机器人在真实世界无需手工设计复位、只靠机载感知、无需手工奖励函数地持续学习,最终三指灵巧手完全无人干预学会多种视觉技能。区别在于:R3L的自动奖励、复位机制、安全约束全是人手工为每个任务搭建的系统工程,而且只解决“怎么无人跑起来”,不涉及自动改进训练算法。而ENPIRE的质变在于连“搭建自动化设施”这件事本身也自动化了(编码智能体按任务合成验证器/复位程序/安全约束,人工只给几分钟示范+指标要求),并且多了Evolution模块去迭代训练算法本身。
ENPIRE提出了哪些指标来衡量自动化研究效率?
ENPIRE提出了两种补充任务级结果的利用率指标:平均机器人利用率(MRU)指在研究的实际墙钟时间中,机器人实际执行实验的时间所占比例;GPU利用率指在研究的实际墙钟时间中,GPU实际处于使用状态的时间所占比例。此外,为了衡量智能体团队将tokens转化为成功机器人策略的效率,定义了平均token利用率(MTU),即整个机群在自动化研究过程中消耗的平均token数,并计算token-成功比以体现任务学习的token使用效率。
