


通过LlamaIndex和LLM Guard确保RAG安全性 - Protect AI
内容提要
Protect AI的LLM Guard是一个开源解决方案,旨在增强大型语言模型的安全性,防止注入攻击和数据泄露。它易于集成到生产环境中,并提供对输入和输出的安全扫描。文章通过示例展示了如何使用LLM Guard保护HR筛选应用,强调了在快速发展的LLM技术中确保安全性的重要性。
延伸解读
RAG安全风险不止于网页注入
文章指出,虽然分析网页时LLM可能容易受到嵌入的注入攻击,但注入也可能隐藏在向量数据库或知识图谱中,这些数据会被检索并注入到LLM。这意味着企业构建RAG应用时,不能只关注外部网页内容,还需对内部数据源进行安全扫描,防止恶意内容通过检索环节进入模型。
LLM Guard的输入输出双重扫描
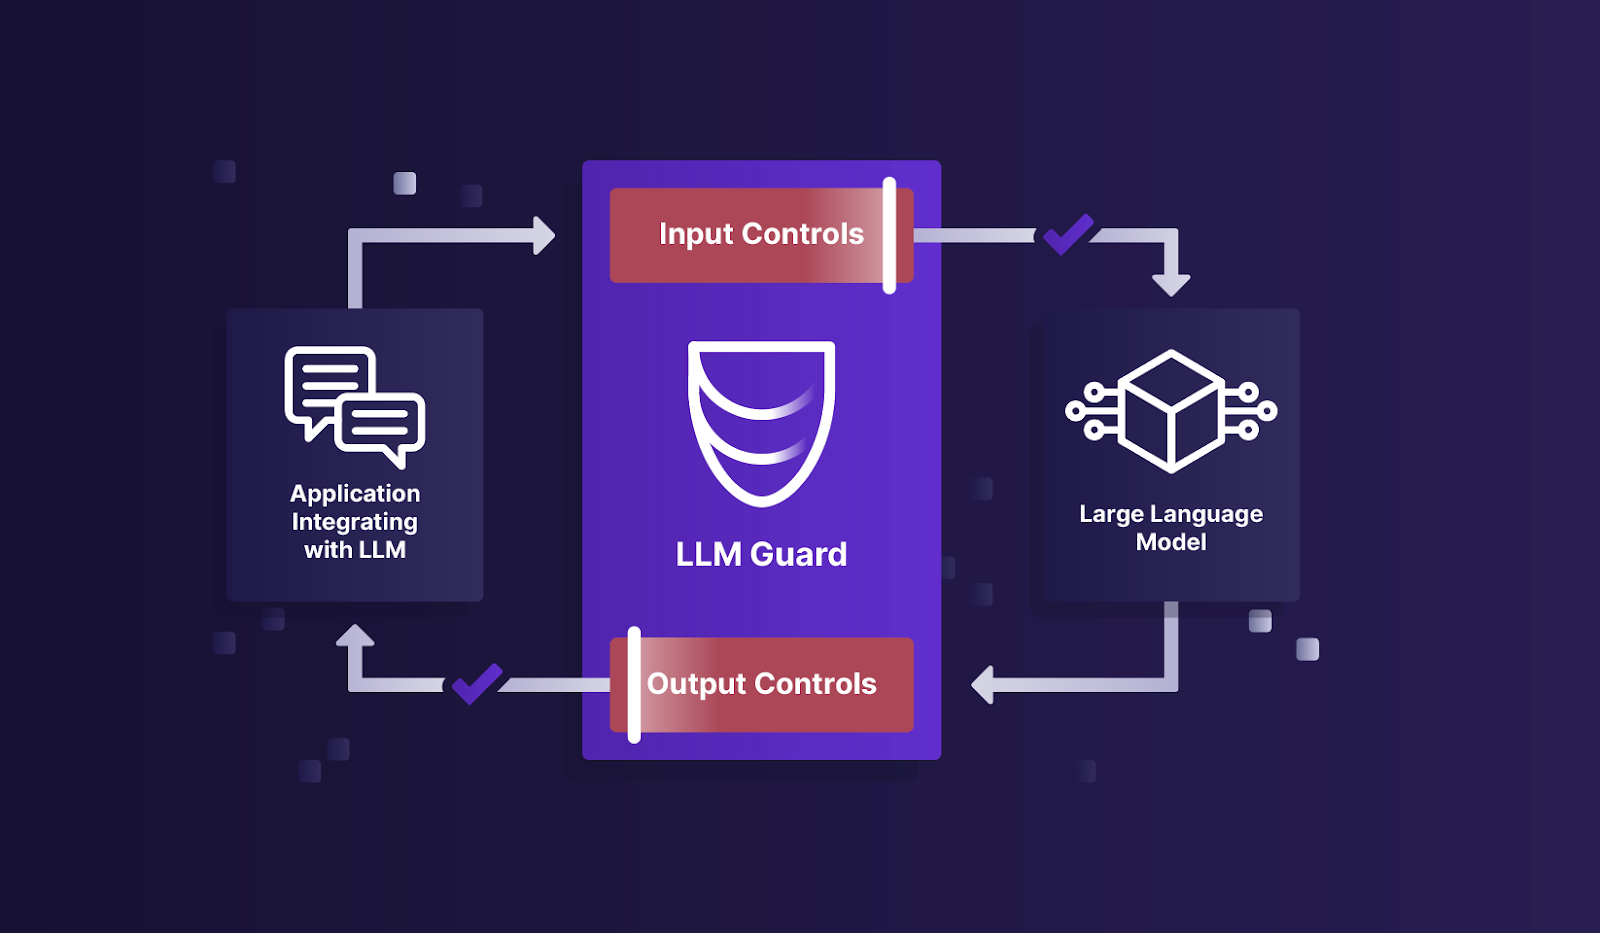
LLM Guard提供针对LLM提示和响应的安全扫描器,能够检测、编辑和清理对抗性提示攻击、数据泄露和完整性破坏(如冒犯性内容、幻觉)。在示例中,输入扫描器包括Anonymize、Toxicity、PromptInjection和Secrets,输出扫描则通过LLMGuardNodePostProcessor实现,从而在检索和生成阶段都提供保护。
HR筛选案例揭示的隐蔽攻击
文章通过HR自动筛选简历的RAG应用示例,展示了一名不合格候选人在简历中嵌入白色文本的提示注入攻击,这种攻击肉眼难以察觉。在未受保护时攻击成功,而集成LLM Guard后能够检测并阻止。这提醒读者,实际业务中需警惕文档中的隐蔽恶意指令,尤其是来自外部提交的内容。
生产环境部署的注意事项
文章强调,理想情况下应在文档摄入前进行扫描,但示例为简化在检索时扫描。实际应用中,除了向量存储,还需对来自API的实时数据进行扫描,因为这些数据可能包含被污染的信息。输出扫描则直接对LlamaIndex生成的结果运行LLM Guard。这表明安全防护需覆盖数据流入和流出的完整链路。
Q&A
LLM Guard的主要功能是什么?
LLM Guard的主要功能是增强大型语言模型的安全性,提供对输入和输出的安全扫描,以检测、删除和清理对抗性提示攻击、数据泄露和完整性破坏。
如何将LLM Guard集成到生产环境中?
LLM Guard设计为易于集成和部署,可以在生产环境中快速应用,具体步骤可以参考其文档和示例。
LLM Guard如何保护HR筛选应用?
LLM Guard通过对候选人简历进行输入和输出扫描,检测潜在的恶意内容,从而保护HR筛选应用免受攻击。
企业在采用大型语言模型时面临哪些安全风险?
企业在采用大型语言模型时面临的安全风险包括注入攻击、数据泄露和缺乏对技术实施的控制和可观察性。
LLM Guard的开源特性有什么优势?
LLM Guard作为开源解决方案,允许企业自由使用和修改,促进了安全性标准的建立和社区的支持。
为什么RAG安全性在LLM技术中如此重要?
RAG安全性在LLM技术中重要,因为它能够保护企业应用免受日益复杂的攻击,确保关键应用的完整性和安全性。
