


使用 Qdrant 和 Neo4j 的 GraphRAG
内容提要
本文介绍用 Neo4j 与 Qdrant 构建 GraphRAG 智能体的方法。传统 RAG 难以处理复杂信息关联,GraphRAG 通过知识图谱增强上下文,但纯 LLM 方案成本高、可扩展性差。该架构分两阶段:摄入阶段用 LLM 抽取实体关系存入 Neo4j,文本向量存入 Qdrant,通过共享 ID 关联;检索生成阶段先进行向量语义搜索,再据 ID 获取图谱上下文,交由 LLM 生成答案。二者结合可提升召回率、精度与复杂查询能力。
延伸解读
GraphRAG 的挑战与混合架构的应对
文章指出,纯 LLM 驱动的 GraphRAG 存在知识图谱构建不一致、查询翻译不准确、可扩展性差和成本高等问题。Neo4j 与 Qdrant 的混合架构通过向量搜索处理语义相似性,图数据库提供关系上下文,减少对 LLM 的依赖,从而提升效率与准确性。
两阶段流程:摄入与检索生成
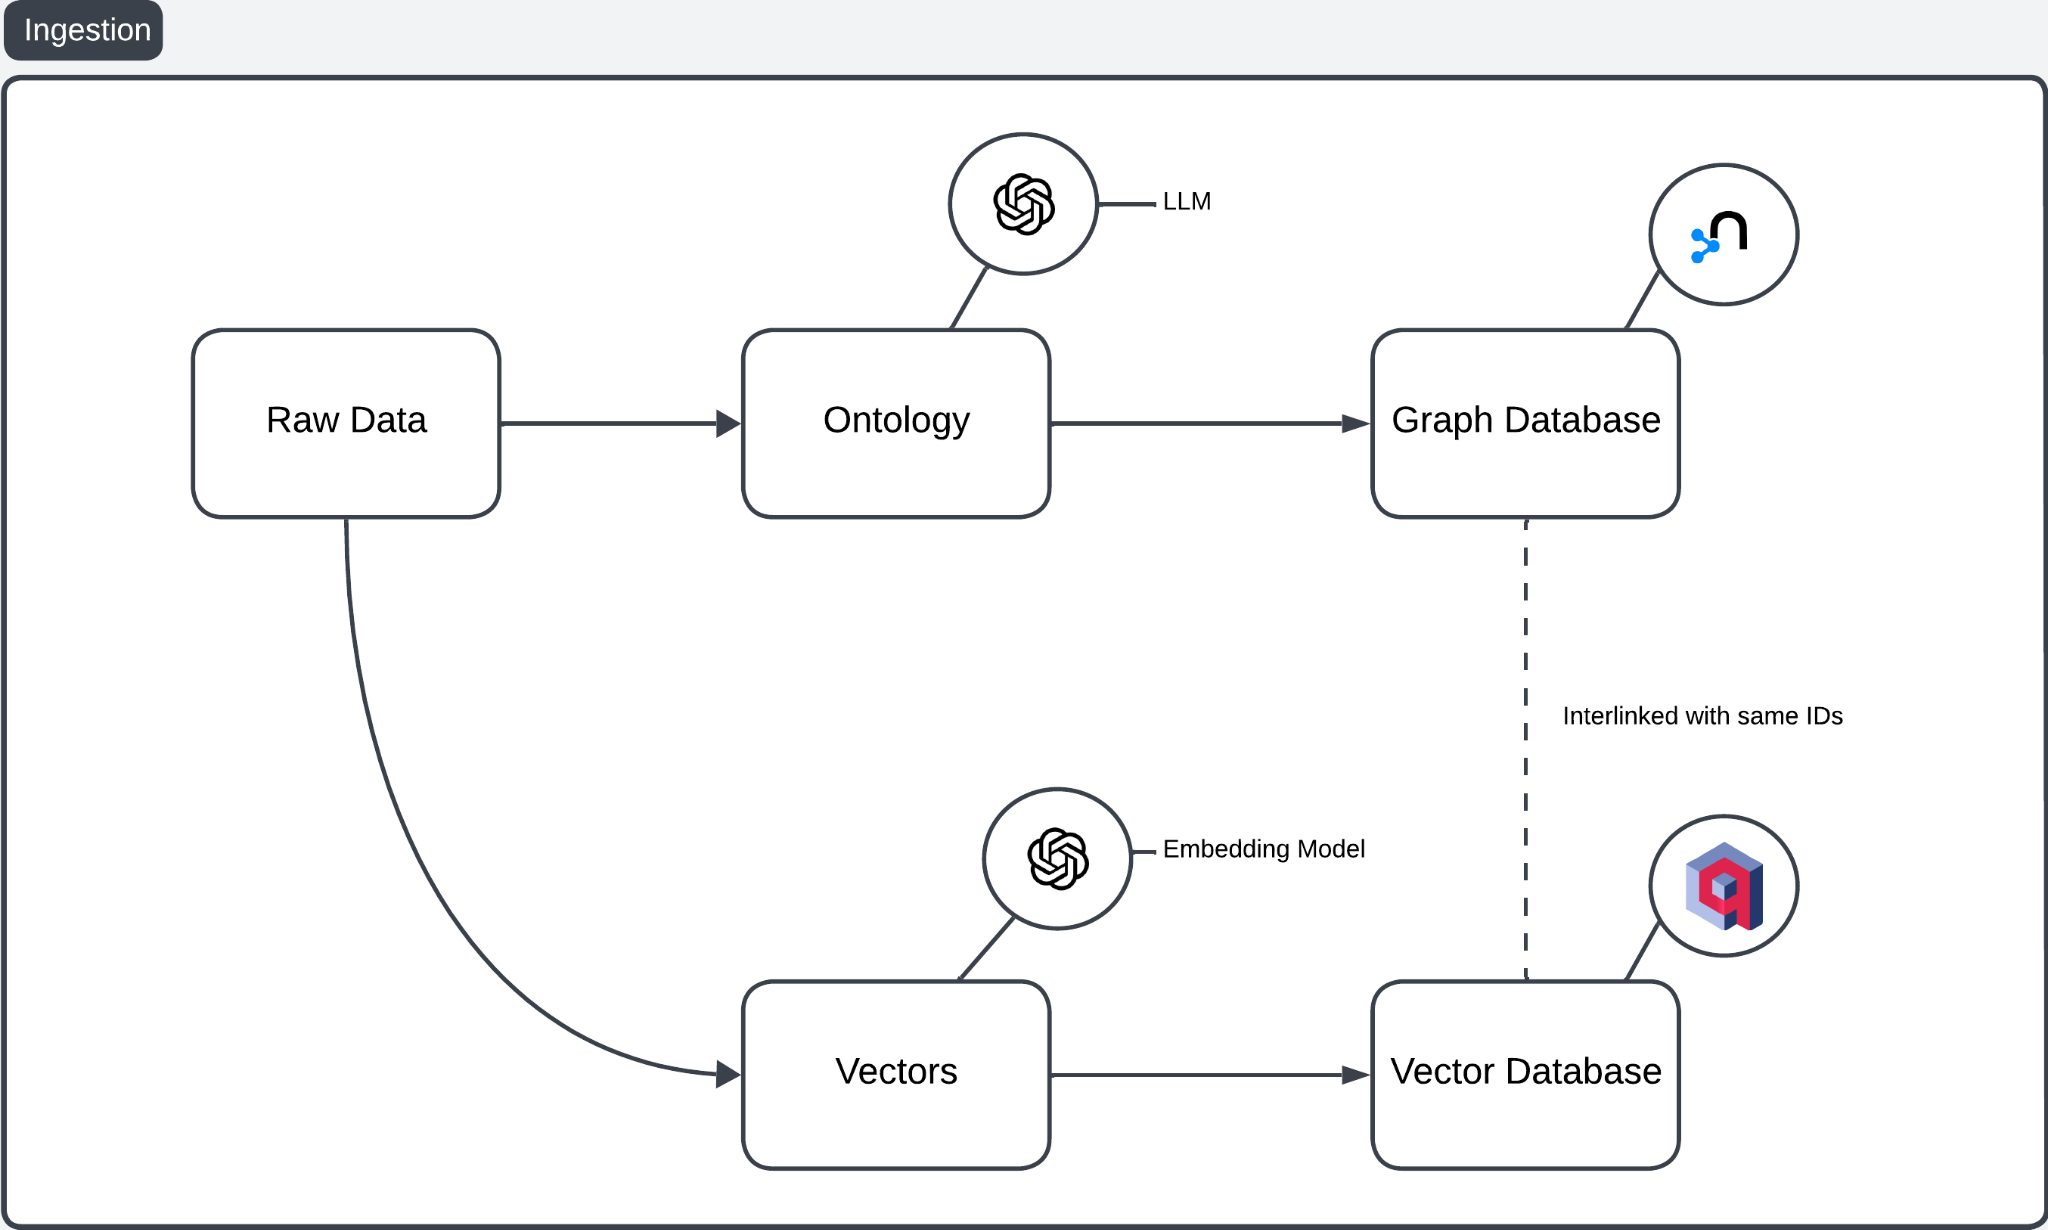
摄入阶段,LLM 从原始数据抽取实体关系存入 Neo4j,同时嵌入模型生成向量存入 Qdrant,两者通过共享 ID 关联。检索阶段,用户查询先经向量语义搜索,再根据 ID 从图数据库获取关系上下文,最后交由 LLM 生成答案。这种设计兼顾语义召回与结构化推理。
实际实现中的关键步骤
教程使用 OpenAI 的 gpt-4o 进行关系抽取,text-embedding-3-small 生成嵌入,并利用 neo4j_graphrag 包的 QdrantNeo4jRetriever 简化检索。代码示例展示了从环境配置、数据摄入到端到端查询的完整流程,为开发者提供了可复用的模板。
优势与适用场景
该架构在召回率与精度、上下文理解、复杂查询适应性和成本可扩展性方面具有优势。尤其适合需要多跳推理和关系挖掘的场景,如文档分析、知识管理。文章也提到,对于特定数据集,使用 NER 替代 LLM 可进一步降低成本。
Q&A
GraphRAG 和传统 RAG 有什么区别?
传统 RAG 主要依赖文档检索,难以处理复杂的信息关联和整体概念理解。GraphRAG 则构建知识图谱来捕捉实体及其关系,能够跟随关系链回答复杂查询,提供更深层的上下文理解,从而生成更准确、相关的回答。
用 Neo4j 和 Qdrant 构建 GraphRAG 的架构是怎样的?
架构分为两个阶段:摄入阶段,用 LLM 从原始数据中抽取实体和关系存入 Neo4j,同时将文本向量存入 Qdrant,两者通过共享的唯一 ID 关联;检索与生成阶段,先将用户查询向量化,在 Qdrant 中进行语义搜索,提取相关 ID 后查询 Neo4j 获取图谱上下文,最后将上下文交给 LLM 生成答案。
GraphRAG 中如何将 Neo4j 和 Qdrant 关联起来?
通过共享唯一 ID 进行关联。在摄入阶段,为每个实体节点分配唯一 ID,存入 Neo4j 时使用该 ID 作为节点属性;同时将文本向量存入 Qdrant 时,在 payload 中存储对应的节点 ID。检索时,从 Qdrant 搜索结果中提取这些 ID,再用它们查询 Neo4j 获取图谱上下文。
GraphRAG 的摄入阶段具体包含哪些步骤?
摄入阶段包括:1) 原始数据准备;2) 用 LLM 抽取本体(实体、关系、层次结构);3) 将本体存入图数据库(如 Neo4j);4) 用嵌入模型将原始数据转换为向量;5) 将向量存入向量数据库(如 Qdrant);6) 通过共享唯一 ID 将图数据库和向量数据库互连。
GraphRAG 的检索与生成阶段是如何工作的?
检索与生成阶段包括:1) 将用户查询向量化;2) 在向量数据库中进行语义相似性搜索,检索相关文档;3) 从搜索结果中提取实体 ID;4) 用这些 ID 查询图数据库,获取相关实体和关系的上下文;5) 将图谱上下文传递给 LLM 生成最终回答;6) 返回回答给用户。
使用 Neo4j 和 Qdrant 的 GraphRAG 有哪些优势?
优势包括:1) 提高召回率和精度,结合向量搜索和关系检索;2) 增强上下文理解,通过图结构建模实体关系;3) 适应复杂查询,支持多跳推理;4) 更好的成本与可扩展性,用向量搜索替代 LLM 进行局部搜索,减少对 LLM 的依赖。
GraphRAG 面临哪些挑战?
挑战包括:1) 用 LLM 构建知识图谱可能引入不一致、偏见或错误,且缺乏本体控制;2) 用 LLM 查询知识图谱时,将自然语言转为 Cypher 查询可能不准确;3) 可扩展性和成本问题,因为每次数据添加、查询或生成都需要调用 LLM。
如何用代码实现 GraphRAG 的端到端流程?
实现步骤:1) 设置 Neo4j 和 Qdrant 实例并初始化客户端;2) 定义数据模型和 LLM 解析函数,从原始数据抽取图组件;3) 将节点和关系摄入 Neo4j;4) 创建 Qdrant 集合,生成嵌入并摄入向量;5) 构建检索器,结合向量搜索和图查询;6) 获取相关子图并格式化上下文;7) 将上下文和用户查询组合成提示,调用 LLM 生成答案。
