
vLLM 新增支持 NVIDIA GPU 硬件视频解码,多 GPU 视频描述吞吐最高提升一倍以上
内容提要
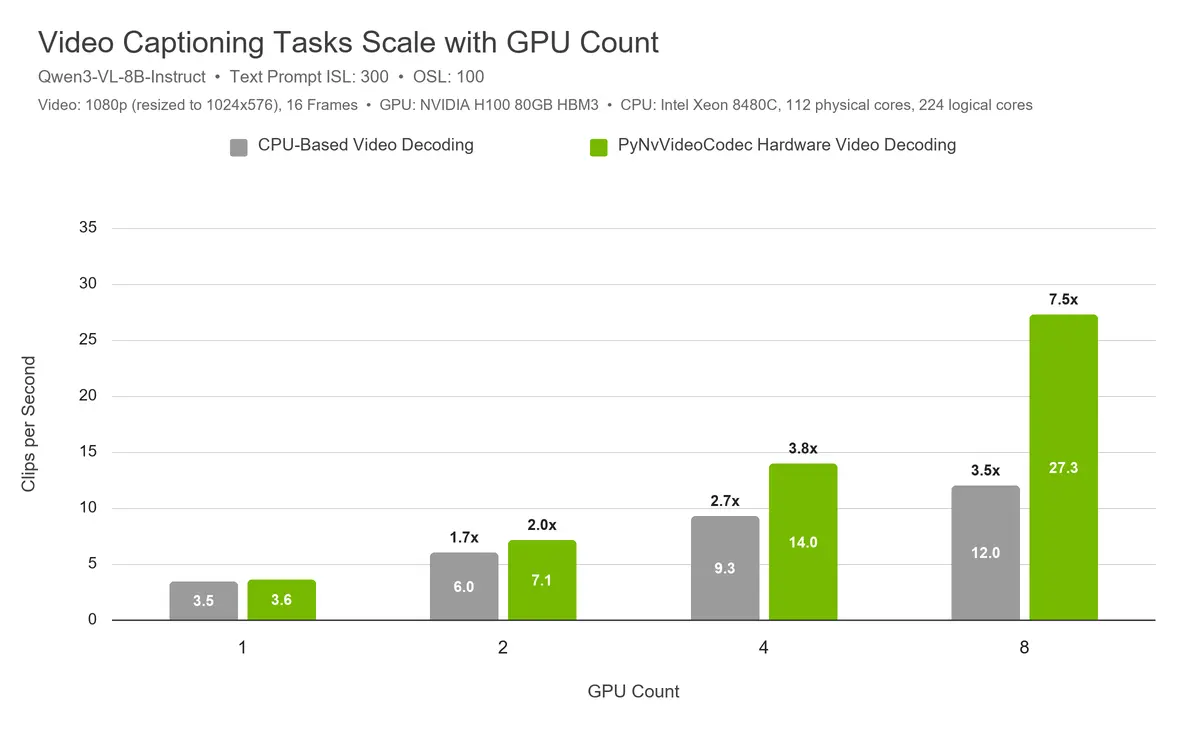
vLLM 通过集成 PyNvVideoCodec 正式支持 NVIDIA GPU 硬件视频解码(NVDEC),将视频解码从 CPU 迁移至 GPU,解决视频描述任务的 CPU 瓶颈。在 8 块 H100 配置下,吞吐量达 CPU 解码两倍以上;此前不足 4 卡即受制于 CPU,现瓶颈消除。该功能随标准 CUDA 版 vLLM 提供,需安装 PyNvVideoCodec==2.0.4,并建议先启动 CUDA MPS 守护进程。
延伸解读
视频描述任务的解码瓶颈与硬件解码价值
视频描述任务中,模型输出通常仅100至200个token,解码耗时占比高。此前CPU解码在2至4块GPU时即成为瓶颈,限制多GPU扩展。vLLM集成NVDEC后,将解码负载迁移至GPU,消除CPU瓶颈,使8卡配置下吞吐达CPU解码两倍以上。这提示读者:对于输出短、输入视频量大的多模态负载,解码效率是扩展关键,硬件解码能显著提升整体吞吐。
部署配置要点与显存权衡
启用该功能需安装PyNvVideoCodec==2.0.4,并建议先启动CUDA MPS守护进程以支持多进程高并发。启动参数中可通过--mm-ipc-gpu-memory-gb为视频解码预留显存,官方建议测试不同取值,仅预留不影响吞吐的最小显存量。需注意,若显存已全部分配给KV cache,预留解码显存可能影响性能,但实际测试未出现性能下降。多GPU扩展时,推荐每个vLLM副本单容器单GPU,并用反向代理分发请求。
实际业务验证与适用场景
NVIDIA自动驾驶团队已使用该系统为数十万小时视频生成描述,累计数亿次请求,验证了其大规模处理能力。此类任务通常使用轻量模型如Qwen/Qwen3-VL-8B-Instruct,输出100至200 token,正是对解码效率最敏感的负载。这表明该功能适合视频描述、打标等需要处理海量视频且模型输出较短的场景,能有效利用多GPU节点提升吞吐。
Q&A
vLLM 新增的 NVIDIA GPU 硬件视频解码支持是什么?
vLLM 通过集成 PyNvVideoCodec,正式支持 NVIDIA GPU 内置的硬件视频解码能力(NVDEC),将视频解码从 CPU 迁移到 GPU,从而消除视频描述任务中的 CPU 瓶颈。
为什么视频描述任务之前会受限于 CPU?
因为视频只能通过基于 CPU 的 OpenCV+FFMPEG 后端解码,而 VLM 推理需要等待解码完成。视频描述任务输出通常只有 100 到 200 个 token,解码时间占比大,导致即使只运行 2 到 4 块 GPU,CPU 核心也会很快被跑满,成为瓶颈。
启用 GPU 硬件解码后,多 GPU 吞吐提升效果如何?
在 8 块 H100、8 个 vLLM 副本的配置下,基于 GPU 的视频解码吞吐量达到基于 CPU 解码器的两倍以上;以往不到 4 块 GPU 就会受制于 CPU,现在该瓶颈已被消除。
如何在 vLLM 中启用 PyNvVideoCodec 视频解码?
需要安装 PyNvVideoCodec==2.0.4,并在启动 vLLM 前先启动 CUDA MPS 守护进程(nvidia-cuda-mps-control -d)。然后在 vllm serve 命令中通过 --media-io-kwargs 指定视频后端为 pynvvideocodec,并设置相关参数如 min_frames、max_frames、hw_decoders 等。
使用 GPU 硬件解码时有哪些注意事项?
视频解码需要预留部分显存,可通过 --mm-ipc-gpu-memory-gb 设置,建议测试不同取值以找到不影响吞吐的最小显存量。如果用例已将全部显存用于 KV cache,可能会看到一定影响,但实际测试中尚未出现性能下降。
这个功能在真实业务场景中有哪些应用?
NVIDIA 自动驾驶相关团队使用该系统为数十万小时量级的视频片段生成描述,累计涉及数亿次视频描述请求,通常使用轻量模型如 Qwen/Qwen3-VL-8B-Instruct,输出 100 到 200 个 token。
