


ATOM 遇上 Mooncake:面向 AMD Instinct GPU 上智能体服务的共享 KV 池
内容提要
ATOM与Mooncake在AMD Instinct GPU上构建共享KV池,以解决智能体会话历史庞大、高度复用但预填充与解码分离导致主机内存割裂的问题。Mooncake Store将两侧内存合并为1.5 TiB KV池,结合分阶段恢复与批量RDMA传输,单台8卡MI355X服务器可支持约百个并发会话,每GPU约44K tokens/s,提示词复用率超95%;四台MI350X服务器共享池的吞吐约为独立池的两倍。
延伸解读
共享池的关键不在容量,而在“跨节点可达”
文章反复强调一个容易被忽视的点:内存容量本身不是瓶颈,瓶颈是内存被 NUMA 节点和服务器边界割裂。单机上 decode 侧近半 DRAM 闲置,四机部署中若各服务器独立建池,会话下一轮常落到不持有其历史的服务器上,复用率从 95% 以上跌到 51–55%。共享池把“谁能读到这份 KV”从单机扩展到全集群,才让高复用真正兑现。
分阶段恢复与批量 RDMA 是两个隐性成本项
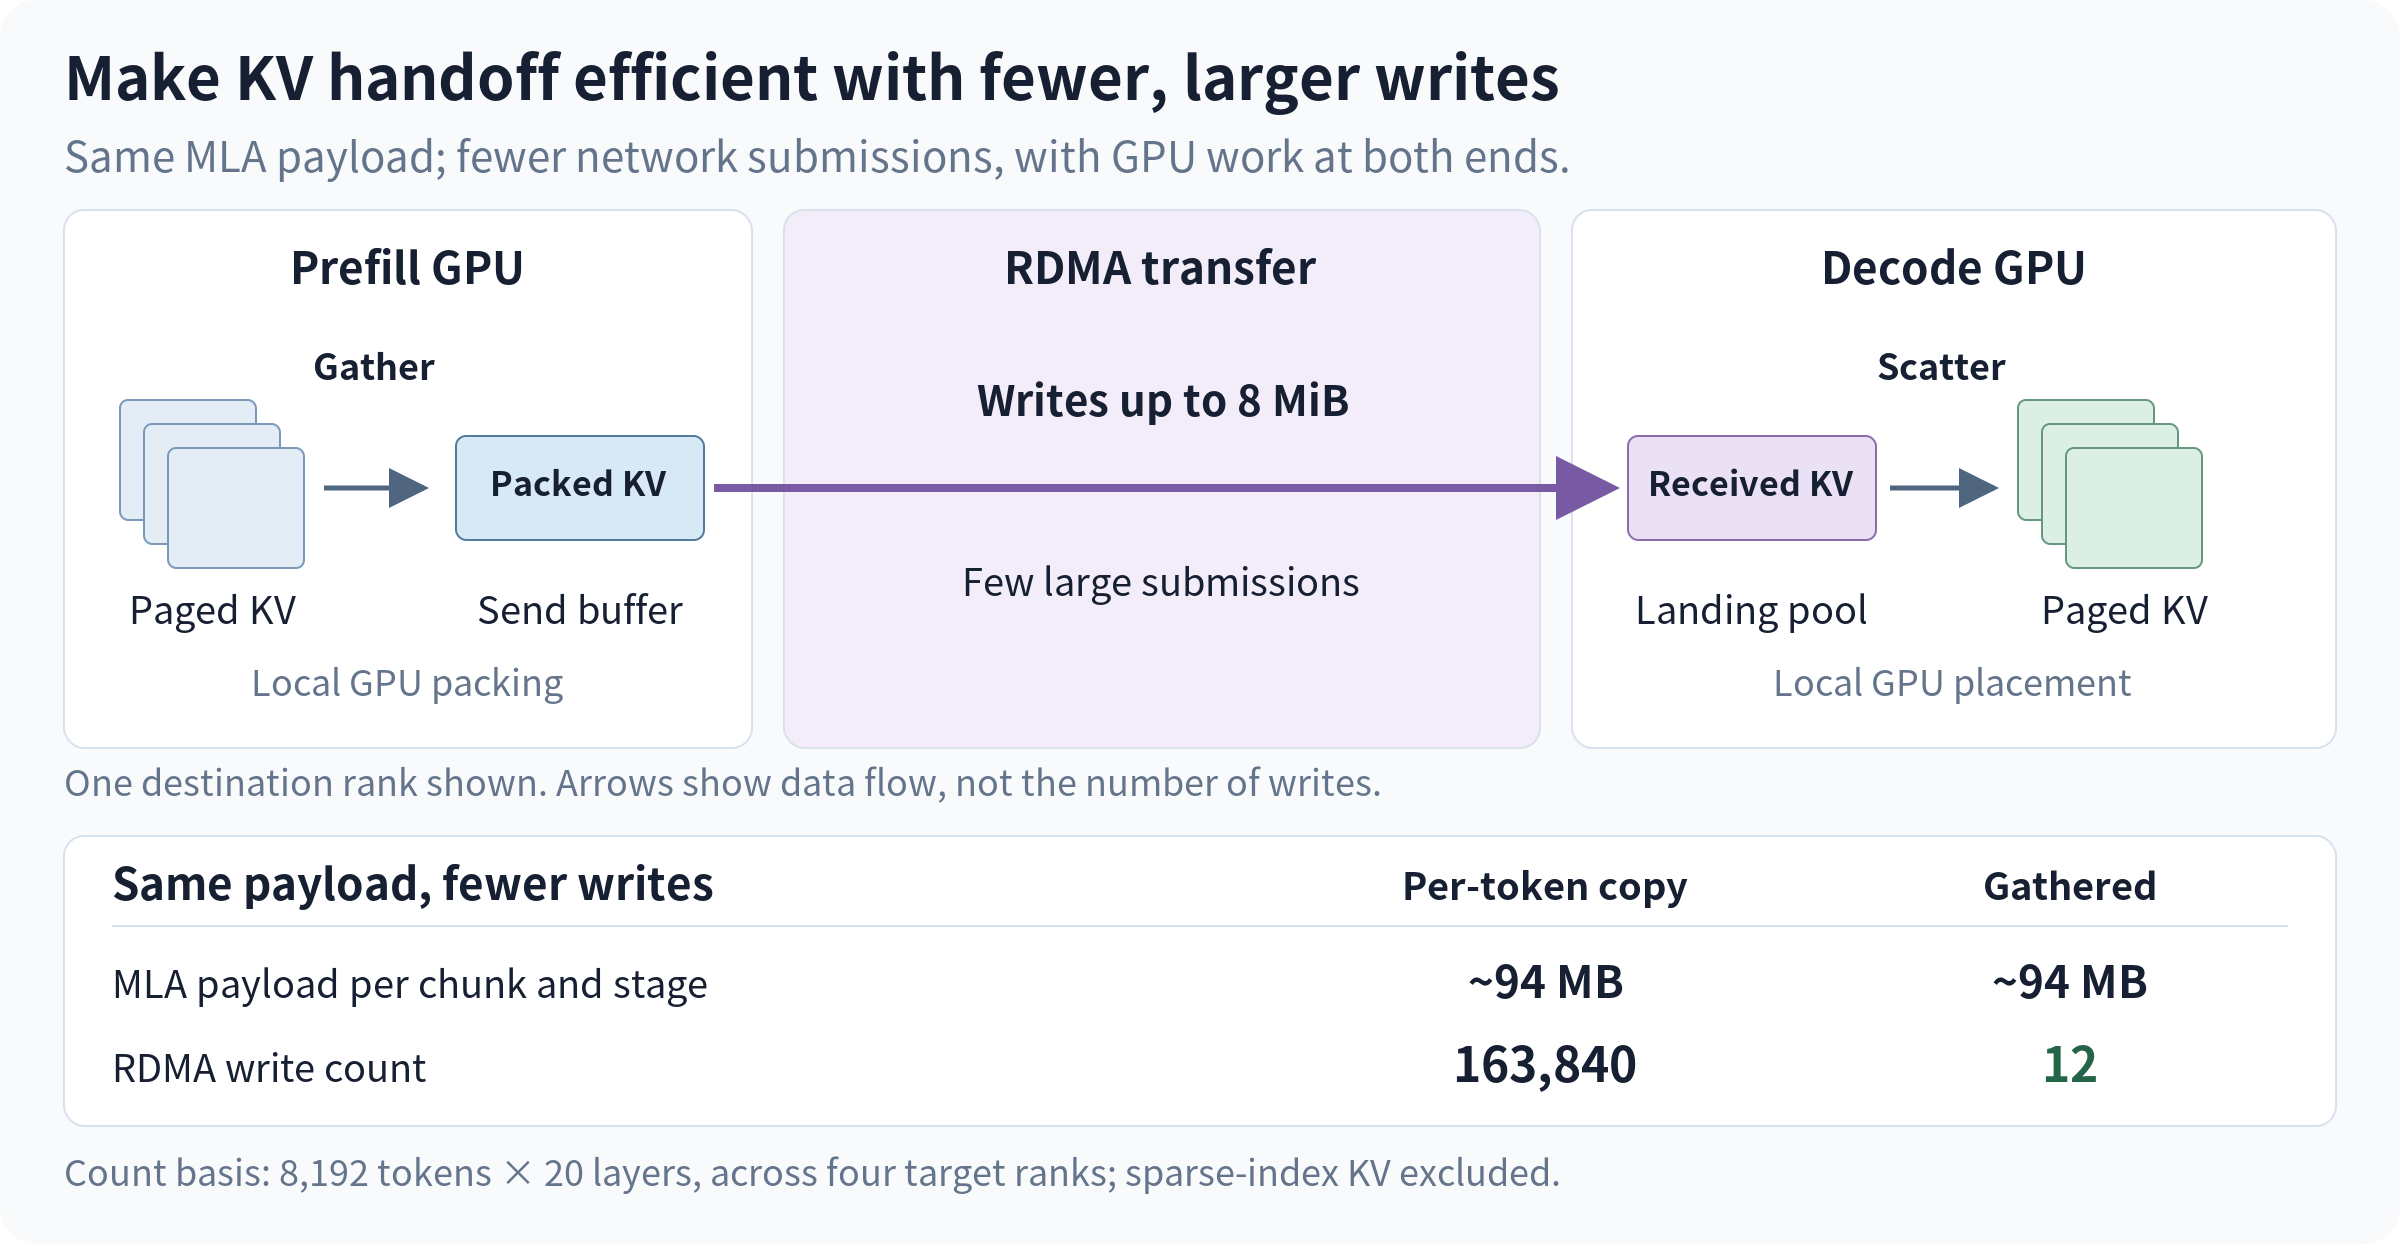
池命中并不等于预填充命中。文章指出,历史必须按 prefill 的流水线分层布局恢复到四张 GPU 上,且只有所有阶段都就绪,前缀才算命中;典型恢复 110K–130K tokens,单卡中位 150–220 ms,但请求平均要等 0.4–1.2 秒。另一侧,prefill 到 decode 的布局差异若直接拷贝会产生海量小写,改用聚合后的大块 RDMA 写,才把 8,192-token 块的写操作从 16 万次降到 12 次。
高并发下的真实天花板在 decode 显存
单台 8 卡 MI355X 在 96 会话以内表现稳定,中位首 token 时间不超过 2.5 秒;到 112 会话吞吐仍维持约 44K tokens/s,但 decode 的 KV 显存中位占用已达 91%,请求开始在 prefill 前排队,首 token 时间升至约 7 秒。这说明共享池解决的是历史存放与复用问题,并不能替代 decode 侧显存扩容;文章也把“给 decode 更多 GPU 或更多 KV 空间”列为后续方向。
跨机共享的代价:故障域与网络拥塞
四机共享池在高并发下吞吐约为独立池的两倍,但文章明确提示代价:池越宽,跨服务器流量越大,故障域也越大,超过四台的权衡尚待测量。此外,多对一和一对多的 RDMA 流量需要有效的拥塞控制,而当前测试环境未启用 PFC、ECN 计数为零,NeuroSpark 正在修复其四机网络后重跑。读者应把共享池视为有明确运维前提的方案,而非无代价扩容。
Q&A
ATOM 和 Mooncake 在 AMD Instinct GPU 上为什么要构建共享 KV 池?
因为智能体会话历史庞大且高度复用,但预填充和解码分离导致主机内存被 NUMA 节点割裂:预填充侧 GPU 内存不足以容纳所有活跃会话的 KV,而解码侧主机 DRAM 却几乎空闲。共享 KV 池将两侧内存合并,让预填充能从池中保存和恢复历史,避免重复计算。
共享 KV 池的容量有多大?是如何构建的?
在单台 8 卡 MI355X 服务器上,每个 NUMA 节点运行一个 Mooncake Store 服务,各贡献 768 GiB DRAM,合计 1.5 TiB KV 池,接近预填充 GPU KV 空间的四倍。池由 Mooncake Master 跟踪对象位置,在 90% 满时按 LRU 淘汰。
Mooncake Store 如何把池命中转化为预填充命中?
ATOM 按预填充的流水线阶段存储 KV:每个阶段将自身层的每 256 token 块存为独立对象,只有四个阶段都持有该前缀才算命中。恢复时通过 RDMA 将数据直接读入 GPU 内存,GPU 自行解包,无 CPU 拷贝;请求需等待所有阶段就绪后才开始预填充。
预填充到解码的 KV 传输是如何优化的?
由于预填充(PP4)和解码(TP4+DCP4)的 KV 布局不同,直接拷贝会产生大量小写入。ATOM 先在预填充 GPU 上按目标解码 GPU 聚集 KV 到连续缓冲区,Mooncake Transfer Engine 以最大 8 MiB 的 RDMA 写传输到解码 GPU 的着陆缓冲区,再由解码分散到 KV 页。一个 8192 token 块从 163,840 次小写减少到 12 次大写。
单台 8 卡 MI355X 服务器使用共享 KV 池后性能如何?
在 96 到 112 并发会话下,每 GPU 吞吐约 44K tokens/s,提示词复用率超过 95%。56 会话时预填充 GPU 内存服务 81% 提示词 token,Store 服务 16%;112 会话时 Store 份额增至 46%。中位首 token 时间在 96 会话内保持 2.5 秒以下,112 会话时升至约 7 秒。
四台 MI350X 服务器共享 KV 池与独立池相比吞吐提升多少?
在 AgentX 测试中,共享池系统吞吐从 56 会话的 256K tokens/s 升至 96 会话的峰值 389K,112 会话为 348K;而独立池仅 156K–194K tokens/s,共享池在 96 和 112 会话时约快两倍。共享池下 KV 复用率保持 94–96%,独立池则降至 65–79%。
