


RAG还活着吗?向量数据库在向量搜索中的作用 | Qdrant
内容提要
文章讨论了向量数据库在人工智能中的重要性,尤其是在检索增强生成(RAG)中的应用。尽管大型语言模型(LLM)如Google的Gemini 1.5提供了更大的上下文窗口,但依赖上下文并不总是有效且成本高昂。向量搜索提供更高的精度和效率,能够实时获取最新信息,适合企业使用。Qdrant的向量数据库在成本和性能上具有显著优势,帮助企业优化AI系统的运行。
延伸解读
大上下文窗口的局限
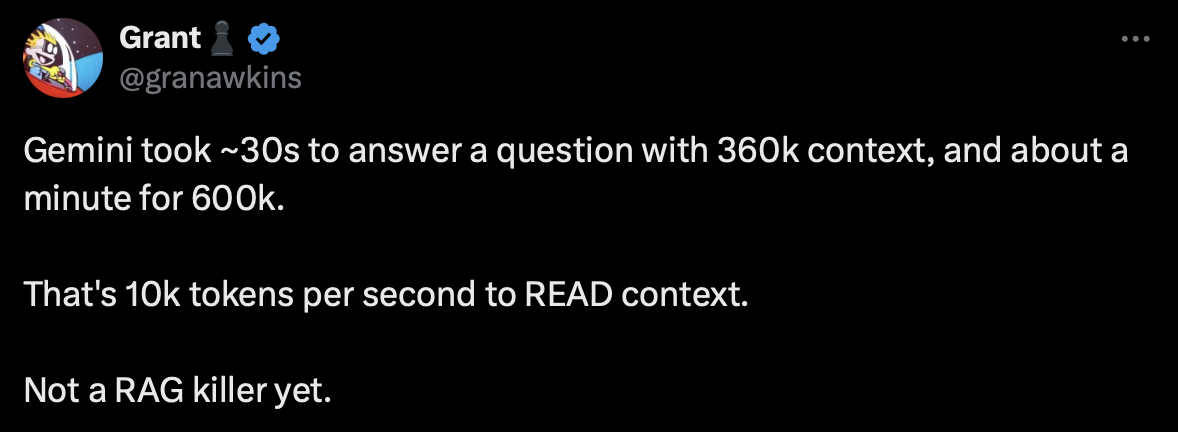
文章指出,尽管大语言模型的上下文窗口不断扩大,但依赖上下文并非有效解决方案。更大的上下文窗口需要更多计算资源,导致处理速度变慢,且难以聚焦相关信息,增加错误或幻觉风险。例如,Gemini 1.5在长上下文下召回率仍低于0.8,意味着可能丢失高达40%的信息。因此,单纯扩大上下文窗口并不能替代检索增强生成(RAG)和向量搜索。
向量搜索的成本优势
在企业环境中,向量搜索查询的成本远低于大语言模型查询。文章估算,向量搜索查询比LLM查询便宜至少1亿倍。使用LLM处理大量数据时,每次深入10万token可能花费1美元,而向量数据库只需前期索引投入,之后查询成本极低。Qdrant通过多租户和分片等功能,帮助企业扩展向量检索,减少对计算密集型LLM的依赖,从而显著降低运营成本。
RAG在企业中的关键作用
RAG并非仅为了弥补上下文限制,而是让LLM能够利用高价值的专有知识,这些知识通常不在公开训练数据中。通过向量索引,企业可以高效检索内部知识,并将LLM降级为写作助手,从而使用更小、更经济的模型(如7B开源模型)完成任务。文章引用Databricks数据称,60%的LLM应用使用了某种形式的RAG,表明RAG在复合系统中具有重要地位。
Q&A
向量数据库在人工智能中的作用是什么?
向量数据库在人工智能中用于提高检索增强生成(RAG)的精度和效率,能够实时获取最新信息,适合企业使用。
大型语言模型的上下文窗口有什么局限性?
大型语言模型的上下文窗口需要更多计算资源,处理速度较慢,且依赖上下文并不总是有效,可能导致错误或信息遗漏。
Qdrant的向量数据库有哪些优势?
Qdrant的向量数据库在成本和性能上具有显著优势,能够帮助企业优化AI系统的运行,并且可扩展性强。
RAG如何提高大型语言模型的动态性?
RAG允许大型语言模型从最新的内部和外部知识源中获取实时信息,使其更具动态性和适应性。
使用向量搜索的成本与LLM查询相比如何?
向量搜索查询的成本远低于大型语言模型查询,能够显著降低计算费用。
企业如何利用Qdrant优化AI系统?
企业可以通过使用Qdrant的向量数据库来降低计算成本,同时保持高质量的响应,从而优化AI系统的运行。
