


如何在多GPU上训练超大规模模型?
内容提要
训练超大规模神经网络需多GPU并行,主要方法包括:数据并行(复制模型、切分数据,分同步与异步)、模型并行(按层切分)、流水线并行(拆分小批次以减少空闲)、张量并行(横向切分运算)。混合专家通过门控稀疏激活专家,GShard、Switch Transformer和专家选择路由可提升规模与效率。显存优化方法包括CPU卸载、激活重计算、混合精度、压缩和ZeRO。
延伸解读
并行策略的权衡:同步与异步
数据并行中,同步(BSP)在每个小批次后同步梯度,保证模型权重一致性,但需等待最慢的worker;异步(ASP)无需等待,却可能使用过时权重,降低统计学习效率。折中方案是梯度累积,每x次迭代同步一次。选择时需在训练速度与收敛性之间权衡。
流水线并行的气泡与调度优化
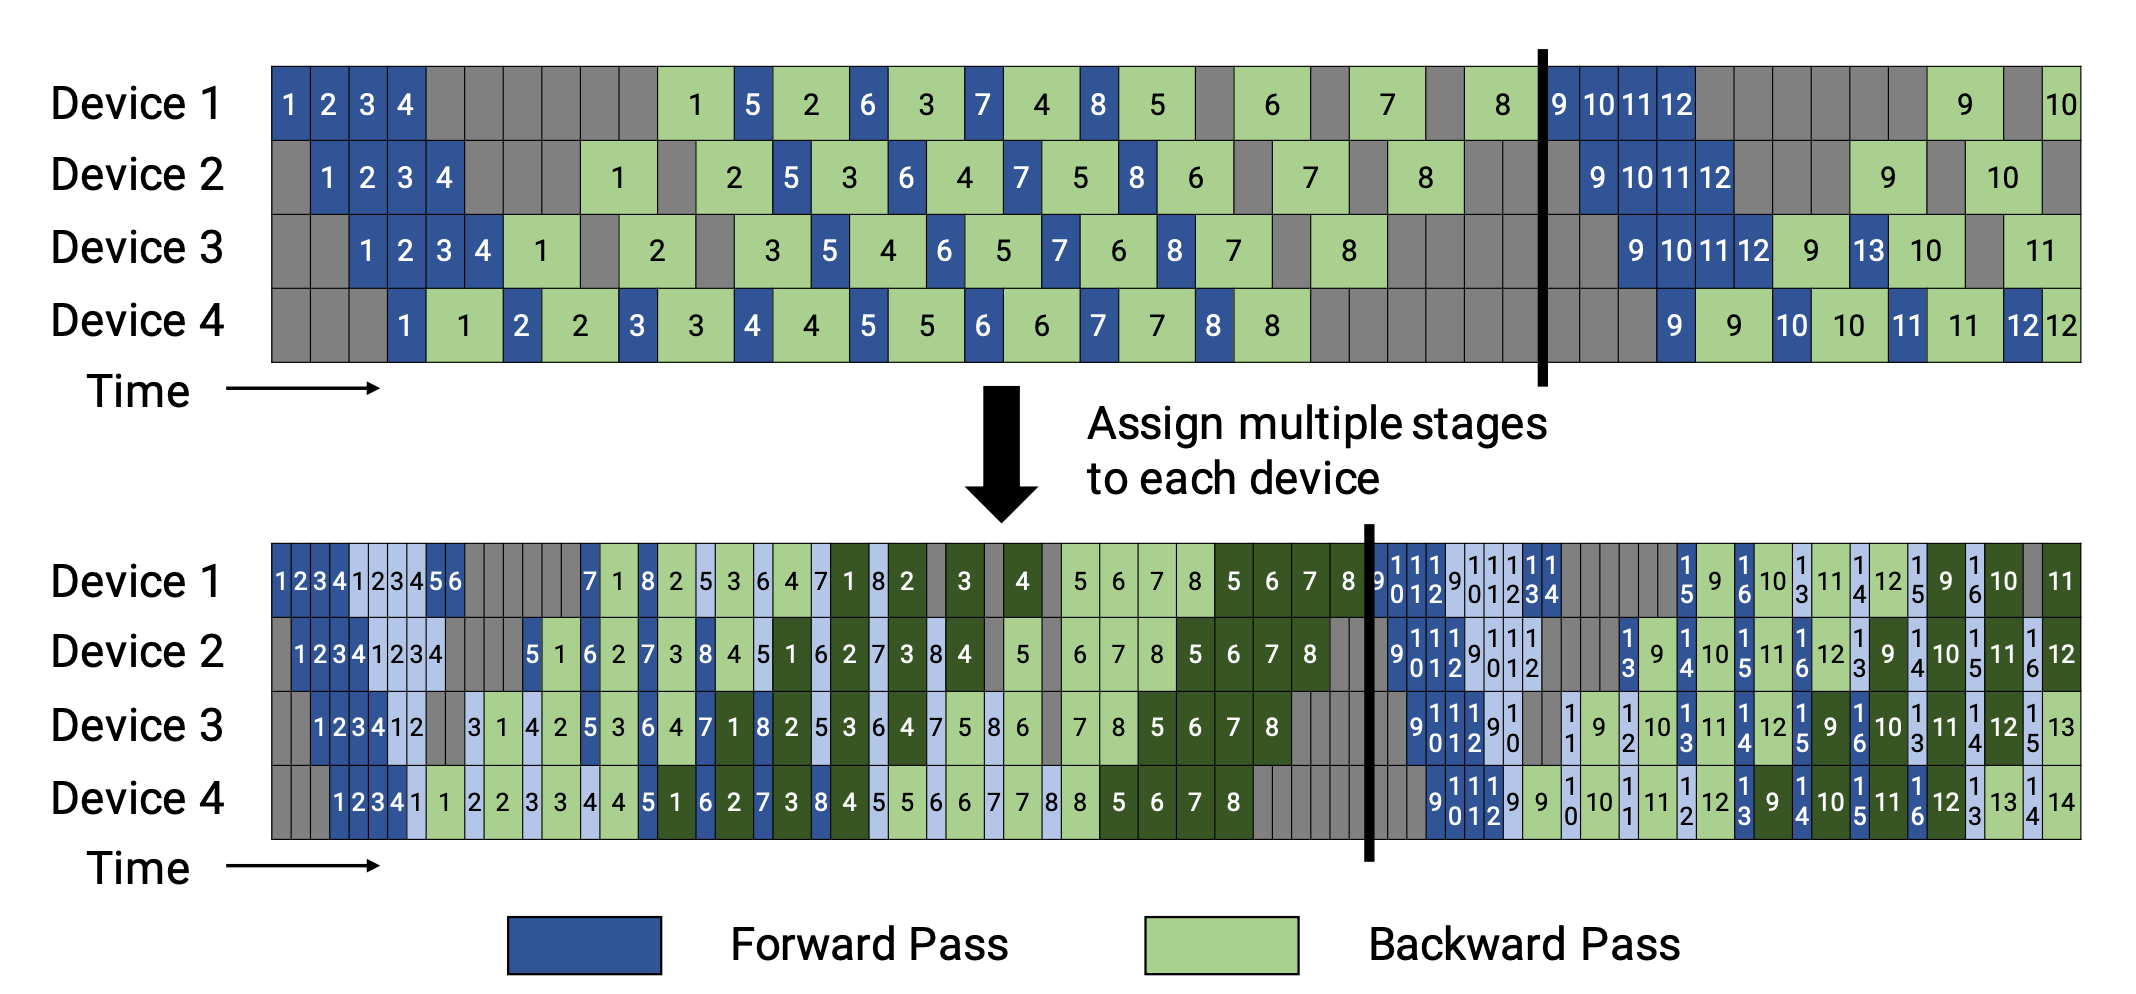
流水线并行将小批次拆分为微批次,减少空闲时间。GPipe同步更新梯度,气泡比例约为(d-1)/(m+d-1),当微批次数量m>4d时气泡几乎可忽略。PipeDream采用1F1B调度,但需权重暂存和垂直同步来保证版本一致。PipeDream-flush和2BW进一步减少内存占用。
混合专家:稀疏激活与路由选择
MoE通过门控网络稀疏激活专家,提升模型规模。GShard和Switch Transformer采用令牌选择路由,但可能负载不均;专家选择路由(EC)让每个专家选择top-k令牌,实现完美负载均衡,训练收敛速度提升2倍。但EC不适用于小批量或自回归生成,因需未来令牌信息。
显存优化:从计算换内存到算法改进
激活重计算以额外前向计算换取内存,将内存降至O(√ℓ);混合精度训练用FP16存储、FP32更新,需损失缩放;ZeRO通过分割优化器状态、梯度和参数,减少数据并行中的冗余。这些方法常结合使用,以训练超大规模模型。
Q&A
训练超大规模模型时,为什么需要多GPU并行?
因为单个GPU的内存有限,而超大规模模型(如数百亿参数)的模型权重、梯度、优化器状态等需要大量显存,远超单卡容量;同时训练数据量大,单卡训练时间过长。因此需要多GPU并行来分摊内存和计算。
数据并行中同步和异步更新有什么区别?
同步更新(BSP)在每个小批次结束时所有工作节点同步梯度,避免权重过期,学习效率高,但需等待最慢节点;异步更新(ASP)各节点独立更新,无等待,但可能使用过期权重,降低统计学习效率,甚至可能不加速收敛。折中方案是每x次迭代全局同步一次(梯度累积)。
流水线并行如何减少GPU空闲时间?
流水线并行将一个小批次拆分成多个微批次,让不同阶段的工作节点同时处理不同微批次,从而减少因顺序依赖导致的空闲“气泡”。例如GPipe同步聚合梯度,PipeDream采用1F1B调度交替执行前向和反向传播。当微批次数量大于4倍分区数时,气泡开销几乎可忽略。
张量并行是如何切分模型计算的?
张量并行将单个张量运算(如矩阵乘法)横向切分到多个设备上。以Transformer为例,对MLP层的权重矩阵按列切分,分别计算GeLU后合并;对自注意力块,将Q、K、V权重按列切分并行计算,再通过另一个GEMM合并结果。
混合专家(MoE)模型如何提升训练效率?
MoE通过门控网络稀疏激活部分专家(如top-k),避免计算所有专家,从而在扩大模型规模的同时保持计算效率。例如GShard使用专家容量和局部组调度,Switch Transformer将每个输入路由到一个专家,专家选择路由(EC)让每个专家选择top-k令牌,实现完美负载均衡并加速收敛。
有哪些显存优化方法可以训练超大模型?
常见方法包括:CPU卸载(将暂时不用的数据移到CPU)、激活重计算(只保存分区边界激活,中间激活在反向传播时重算,内存降至O(√ℓ))、混合精度训练(用FP16计算,保留FP32主权重和损失缩放)、压缩中间结果(如Gist编码)、以及ZeRO优化器(分区优化器状态、梯度和参数,减少冗余)。
