

读《通向AGI之路:大型语言模型(LLM)技术精要》笔记整理
内容提要
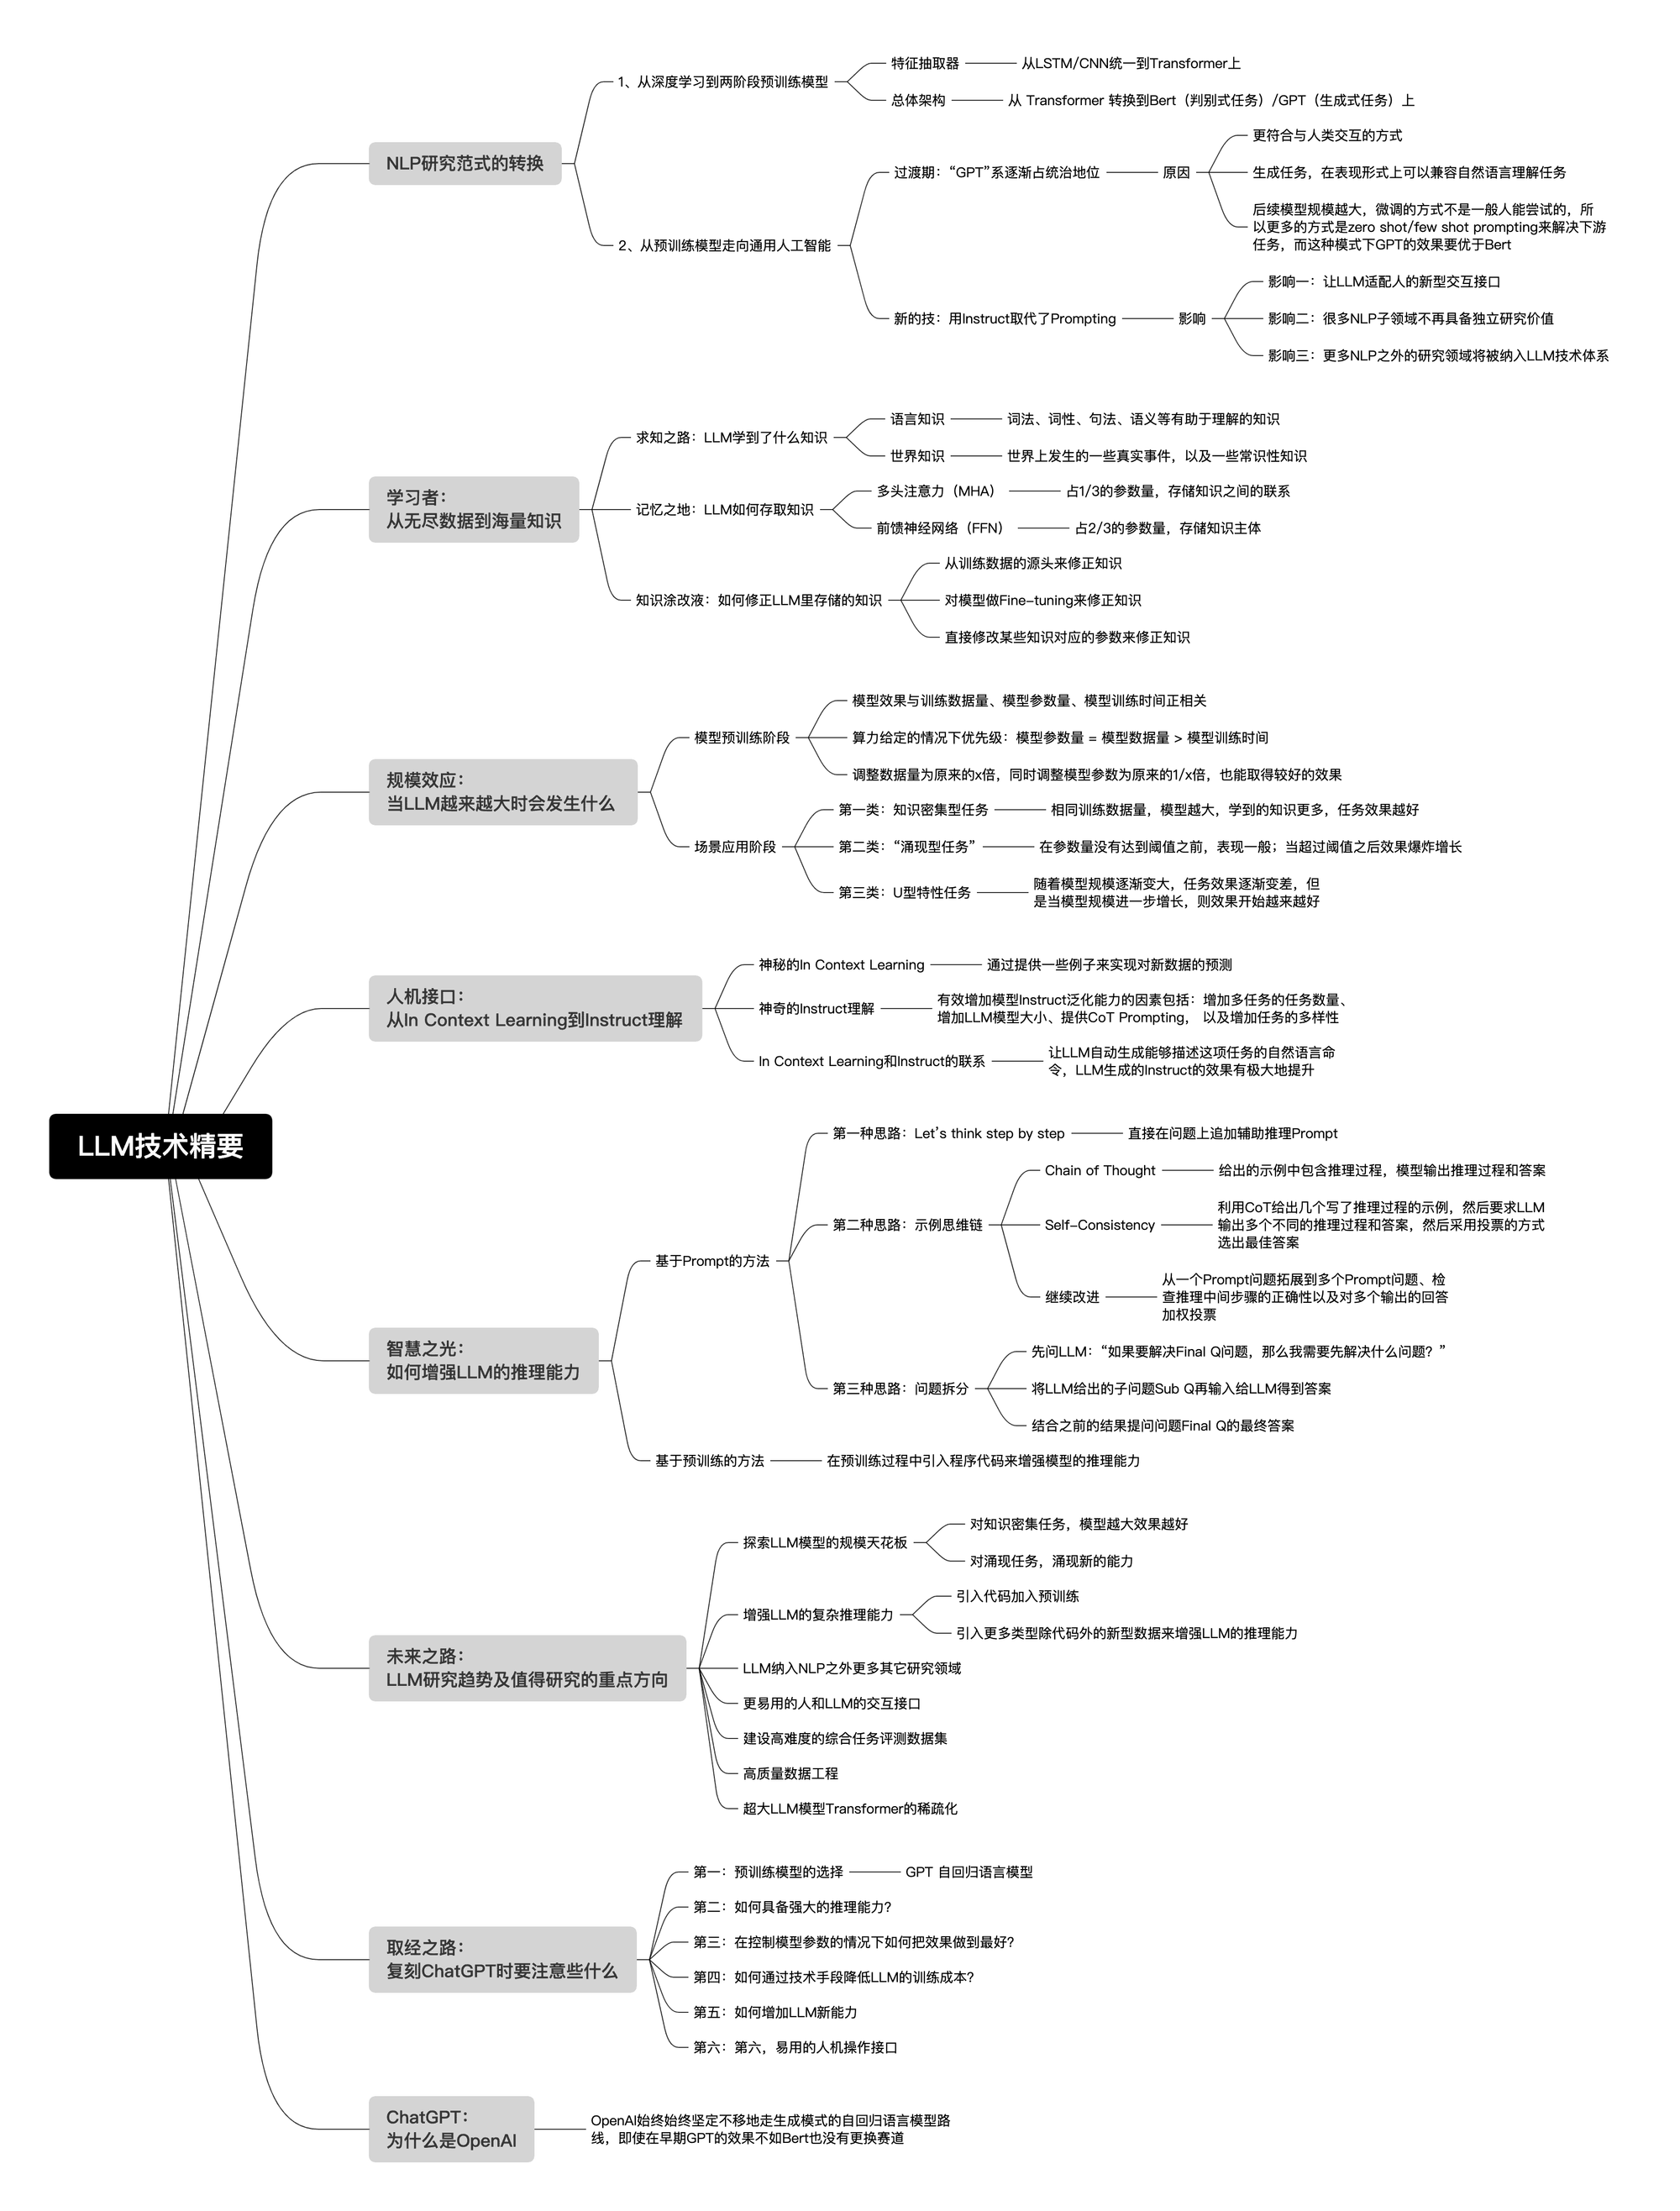
《通向AGI之路》梳理了大语言模型技术要点:NLP经历从深度学习到预训练模型、再到ChatGPT以指令取代提示的两次范式转换;LLM从数据中习得语言与世界知识,存储于Transformer的FFN参数中;模型规模扩大带来涌现能力,但复杂推理仍薄弱;未来方向包括增强推理、引入代码预训练、建设易用人机接口及高质量数据工程。
延伸解读
范式转换的实质:从人适配模型到模型适配人
文章指出,NLP领域十年间经历两次范式转换:第一次从深度学习到预训练模型,统一了技术栈;第二次从预训练模型到ChatGPT,用Instruct取代Prompting。其核心变化是交互接口的革新——让LLM理解人类习惯的命令,而非让人绞尽脑汁设计提示语。这降低了使用门槛,也意味着未来评估模型时,易用性将与能力同等重要。
知识存储与修正:FFN是记忆主体,修正需权衡成本
文章明确,LLM的知识主要存储在Transformer的FFN参数中,约占三分之二,而注意力机制负责建立知识联系。若要修正错误知识,有三种路径:从训练数据源头修正、微调修正、直接修改参数。但三者各有局限:源头修正成本高,微调可能引发灾难性遗忘,参数编辑则需精确定位。这提示我们,知识修正并非易事,需根据场景选择方法。
规模效应与涌现能力:并非所有任务都随规模线性提升
文章强调,模型规模扩大能提升知识密集型任务效果,并可能解锁“涌现能力”,但复杂推理仍薄弱。同时,存在U型特性任务,即效果随规模先降后升。此外,Scaling Laws研究显示,参数量与数据量需按比例增加,Chinchilla模型即通过更小参数量、更多数据量取得更优效果。因此,盲目追求大模型未必是最佳策略。
增强推理的路径:提示工程与代码预训练
针对LLM推理能力不足,文章总结了两类方法:基于Prompt的方法,如思维链、自洽性、问题分解;基于预训练的方法,如引入程序代码。前者通过提示激发模型已有能力,后者则从训练阶段增强推理。作者主观判断,LLM推理可能本质上是图上推理或程序流程图执行。这为未来研究提供了方向,也说明推理增强需多管齐下。
Q&A
NLP领域近十年经历了哪两次研究范式转换?
第一次是从深度学习到两阶段预训练模型(如BERT/GPT),第二次是从预训练模型走向通用人工智能,以ChatGPT用Instruct取代Prompting为标志。
LLM从数据中学到的知识主要存储在Transformer的哪个部分?
LLM的知识主体存储在Transformer的前馈神经网络(FFN)结构中,约占参数总量的三分之二;多头注意力(MHA)约占三分之一,主要用于建立知识间的联系。
什么是In Context Learning?它和Fine-tuning有什么区别?
In Context Learning(少样本提示)是通过给LLM几个示例来完成任务,但不更新模型参数;而Fine-tuning是用示例作为训练数据,通过反向传播修正模型参数。
LLM的涌现能力是什么?为什么会出现?
涌现能力指模型规模超过一定阈值后,某些任务表现突然大幅提升。可能原因:任务评价指标不平滑,或任务由多步骤构成,模型规模增大使各步骤能力增强但需全部正确才能得分。
如何增强LLM的复杂推理能力?
基于Prompt的方法:如思维链(CoT)提示、自洽性投票、问题分解等;基于预训练的方法:引入程序代码参与预训练。
复刻ChatGPT时需要注意哪些关键点?
选择GPT自回归模型;引入代码和文本一起训练增强推理;控制参数下走Chinchilla路线或检索增强;稀疏化降低训练成本;增加数据多样性;建设易用人机接口。
