


GPT-3 如何工作——可视化与动画
内容提要
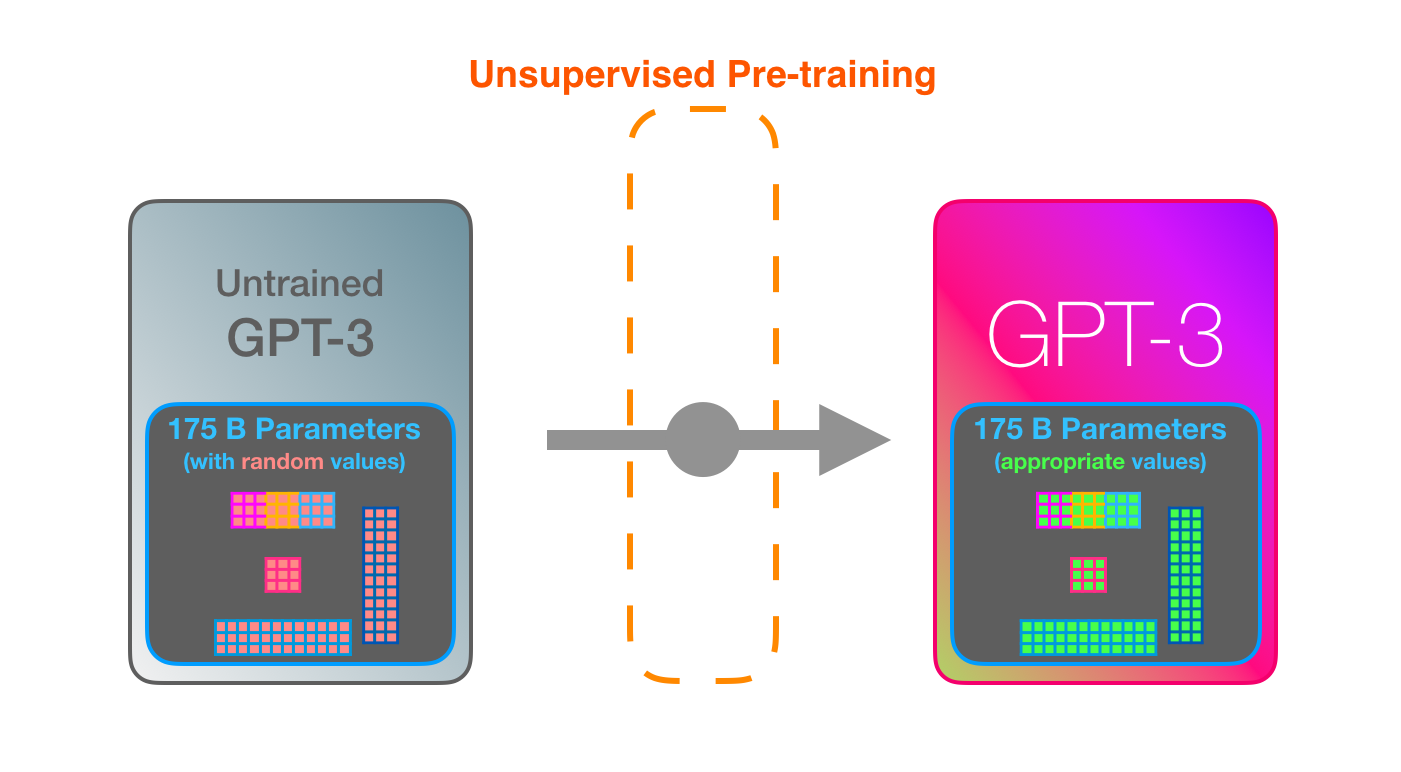
GPT-3是拥有1750亿参数的超大规模语言模型,训练耗资约460万美元、355个GPU年,使用3000亿词元数据。它基于Transformer解码器,通过预测下一个词并反复修正误差来学习。模型上下文窗口为2048词元,经96层解码器逐层计算,每层约18亿参数。生成时逐词输出并回馈输入,可完成代码生成等任务,未来微调将进一步提升能力。
延伸解读
训练成本与规模:355 GPU年、460万美元
文章给出GPT-3训练耗资约460万美元、355个GPU年的估算,并强调其1750亿参数和3000亿词元的数据集。这些数字说明模型能力背后是极高的算力与数据投入,也解释了为何当时只有少数机构能训练此类模型。读者可借此理解大模型并非单纯算法突破,而是工程规模与资源密集的结果。
上下文窗口2048词元:生成时逐词回馈
GPT-3的上下文窗口为2048词元,生成时每次只输出一个词元,并将其重新作为输入的一部分,逐步推进。这意味着模型对长文本的处理受窗口限制,且生成过程是自回归的。文章以代码生成为例,说明输入提示和示例会被拼接后送入模型,输出则逐词元产生。读者可注意:窗口大小直接影响模型能参考的上下文长度。
96层解码器与稀疏注意力:深度带来参数分布
模型内部由96层Transformer解码器堆叠而成,每层约18亿参数,总计1750亿参数。文章指出GPT-3与GPT-2的差异之一是交替使用稠密和稀疏自注意力层。这种深度结构让每个词元流经全部层,计算主要是大量矩阵乘法。读者可理解“深度”不仅指层数多,也意味着参数分散在各层中,共同决定每次预测。
微调尚未落地:当前能力来自预训练模型
文章明确表示,目前看到的实验都来自同一个已训练好的模型,微调尚未推出。微调会更新模型权重,使其在特定任务上表现更好。作者认为微调 rollout 后可能性会更惊人。读者应注意:当前GPT-3的代码生成等能力是在无任务特定权重更新下实现的,这既体现预训练模型的通用性,也提示其可靠性仍有限。
Q&A
GPT-3 的训练成本大概是多少?
训练 GPT-3 估计需要 355 个 GPU 年,花费约 460 万美元。
GPT-3 的模型规模有多大?
GPT-3 拥有 1750 亿个参数,上下文窗口为 2048 个词元,由 96 层 Transformer 解码器组成,每层约 18 亿参数。
GPT-3 是如何训练的?
GPT-3 使用 3000 亿词元的文本数据集,通过滑动窗口生成大量训练示例。模型只看到特征,被要求预测下一个词,然后计算预测误差并更新模型参数,重复数百万次。
GPT-3 生成文本时是如何工作的?
GPT-3 一次生成一个词元。输入词被转换为向量,经过 96 层解码器计算,输出预测向量再转换回词。生成每个词后,该词会被反馈回模型作为后续输入,逐词输出。
GPT-3 的架构有什么特点?
GPT-3 基于 Transformer 解码器架构,与 GPT-2 的主要区别是使用了交替的稠密和稀疏自注意力层。
GPT-3 能用来生成代码吗?
可以。例如在 React 代码生成示例中,将描述和几个示例作为输入提示,模型就能逐词生成对应的 React 代码。
GPT-3 的微调有什么作用?
微调会更新模型的权重,使模型在特定任务上表现更好,未来微调功能的推出将进一步提升 GPT-3 的能力。
