


Qdrant 中的混合搜索
内容提要
混合搜索结合稠密与稀疏检索,兼顾语义相似与精确词匹配。稠密检索擅长同义改写,稀疏检索(如BM25)擅长标识符和专有词。融合方法中,RRF按排名合并以避免分数尺度差异,DBSF则归一化分数。在五个公开数据集上,默认RRF在四个上优于单一检索器。但混合搜索增加存储、索引和查询延迟,需实测收益是否值得成本。
延伸解读
稠密与稀疏检索的互补性
稠密检索基于语义相似度,能匹配同义改写,但可能忽略查询中的精确标识符;稀疏检索(如BM25)依赖词项匹配,擅长处理专有名词和标识符,但无法理解语义。文章通过产品搜索示例说明:对于“french molding”,稀疏检索会因词项匹配错误而返回无关产品;对于“bathroom vanity knobs”,稠密检索能正确识别类别,而稀疏检索则可能因“knobs”一词匹配到相关产品。两者结合可覆盖不同查询类型。
融合方法:RRF与DBSF的取舍
RRF(倒数排名融合)仅利用文档在各自列表中的排名,避免稠密相似度与BM25分数的尺度差异,无需调整权重。DBSF(基于分布的分数融合)则对每个列表的分数进行归一化,保留分数差距,使某一检索器的显著优势能影响最终排名。文章指出,没有一种方法普遍最优,建议从RRF开始,再与DBSF在相同标注查询上对比。
混合搜索的成本与实施考量
混合搜索需要为每个点添加稀疏向量、建立第二个索引,并在每次查询时执行额外搜索。在单容器单请求的测试中,额外搜索使中位查询延迟增加0.60至1.47毫秒。若在已有稠密集合上添加稀疏向量,必须新建集合并完全重建索引,因为向量配置在集合创建时固定。稀疏向量需使用IDF修饰符,以提升稀有词权重。
评估混合搜索收益的实践建议
在五个公开数据集上,默认RRF在四个数据集上优于单一检索器,但DBPedia-entity例外,融合分数低于稠密检索。建议使用标注查询,固定模型和候选限制,以nDCG@10评估稠密、稀疏和融合检索。若融合未超越两者,需检查排名差异大的查询,并考虑调整融合方法或权重。若两个检索器均未召回相关文档,融合无法弥补。
Q&A
混合搜索是什么?它和单独使用稠密或稀疏检索有什么区别?
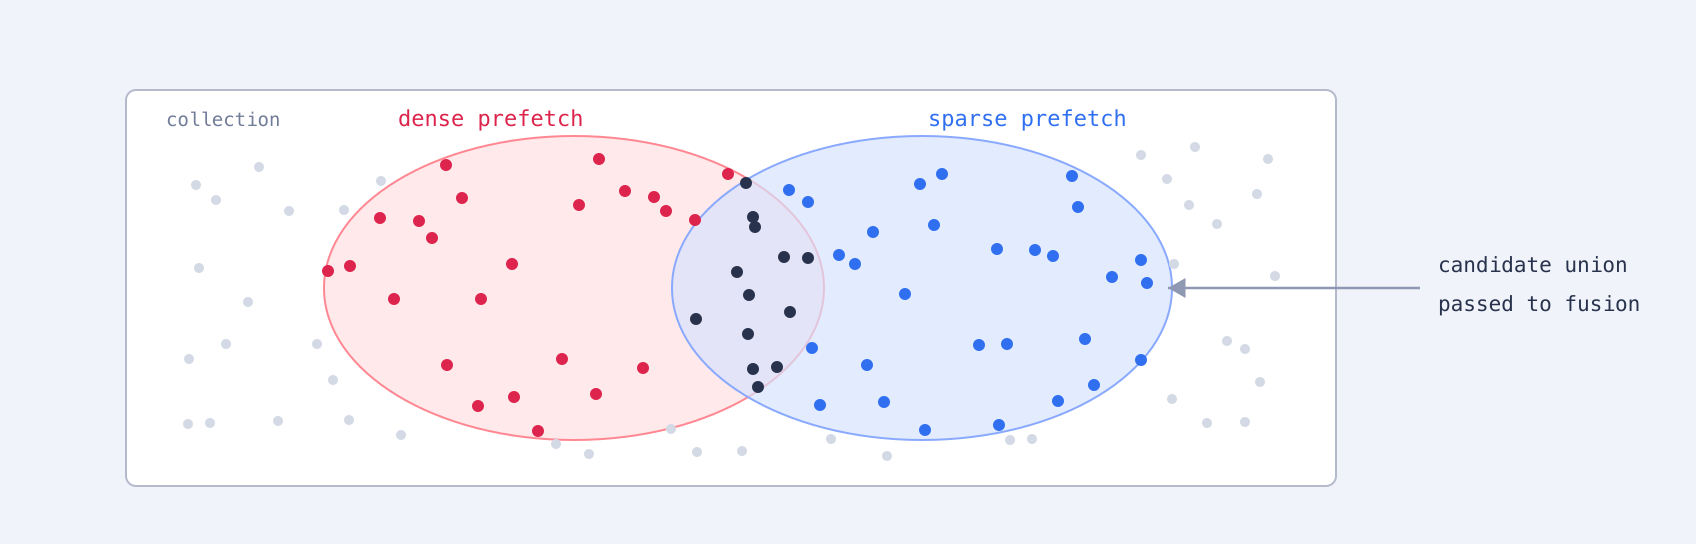
混合搜索同时对同一个查询运行稠密检索和稀疏检索,然后合并它们的结果列表。稠密检索提供语义相似性,使同义改写能排在一起;稀疏检索提供加权词项匹配,用于精确词和标识符。与单独使用任一检索器相比,混合搜索会增加存储、索引和查询工作量。
稠密检索和稀疏检索各自擅长什么?为什么它们会漏掉不同的内容?
稠密检索将查询和文档嵌入后按向量相似度排序,擅长语义相似,但精确字符串可能失去影响力。稀疏检索将文本表示为加权词项并计算重叠,BM25根据词频、逆文档频率和文档长度设置权重,擅长精确词和标识符,但可能漏掉用不同术语描述的相关文档。
RRF和DBSF融合方法有什么区别?应该先用哪个?
RRF只读取每个文档在每个列表中的排名,丢弃分数大小,从而避免稠密相似度与BM25分数的尺度不匹配。DBSF则用每个列表的平均分和分数分布重新缩放分数后再相加,保留分数差距的大小。没有一种方法普遍胜出,建议先使用RRF,再用相同的标注查询对比DBSF。
在Qdrant中如何实现混合搜索?需要哪些配置?
在Qdrant中,混合搜索使用一个prefetch进行稠密检索,另一个prefetch进行稀疏检索,然后通过FusionQuery合并候选列表。创建集合时需声明稠密向量和稀疏向量,稀疏向量需设置IDF修饰符。查询时用using选择每个prefetch的向量,并设置融合方法(如RRF)。
混合搜索在公开数据集上的效果如何?是否总是优于单一检索器?
在五个公开数据集上,默认RRF在四个数据集上优于更强的单一检索器。DBPedia-entity是例外,融合得分低于稠密检索。因此混合搜索并非总是更好,需要在自己的标注查询上评估。
添加第二个检索器(如BM25)会带来哪些成本?如何评估是否值得?
添加BM25作为第二个检索器意味着每个点增加稀疏向量、第二个索引以及每次查询的额外搜索。在一个容器单请求下,额外搜索使中位查询延迟增加0.60到1.47毫秒。需要在自己的并发和分片布局下测量成本,并确认相关性提升是否值得索引和延迟开销。
