

Uzair Aslam:使用 pgvector 的 PostgreSQL 向量搜索:Next.js 中的混合检索
内容提要
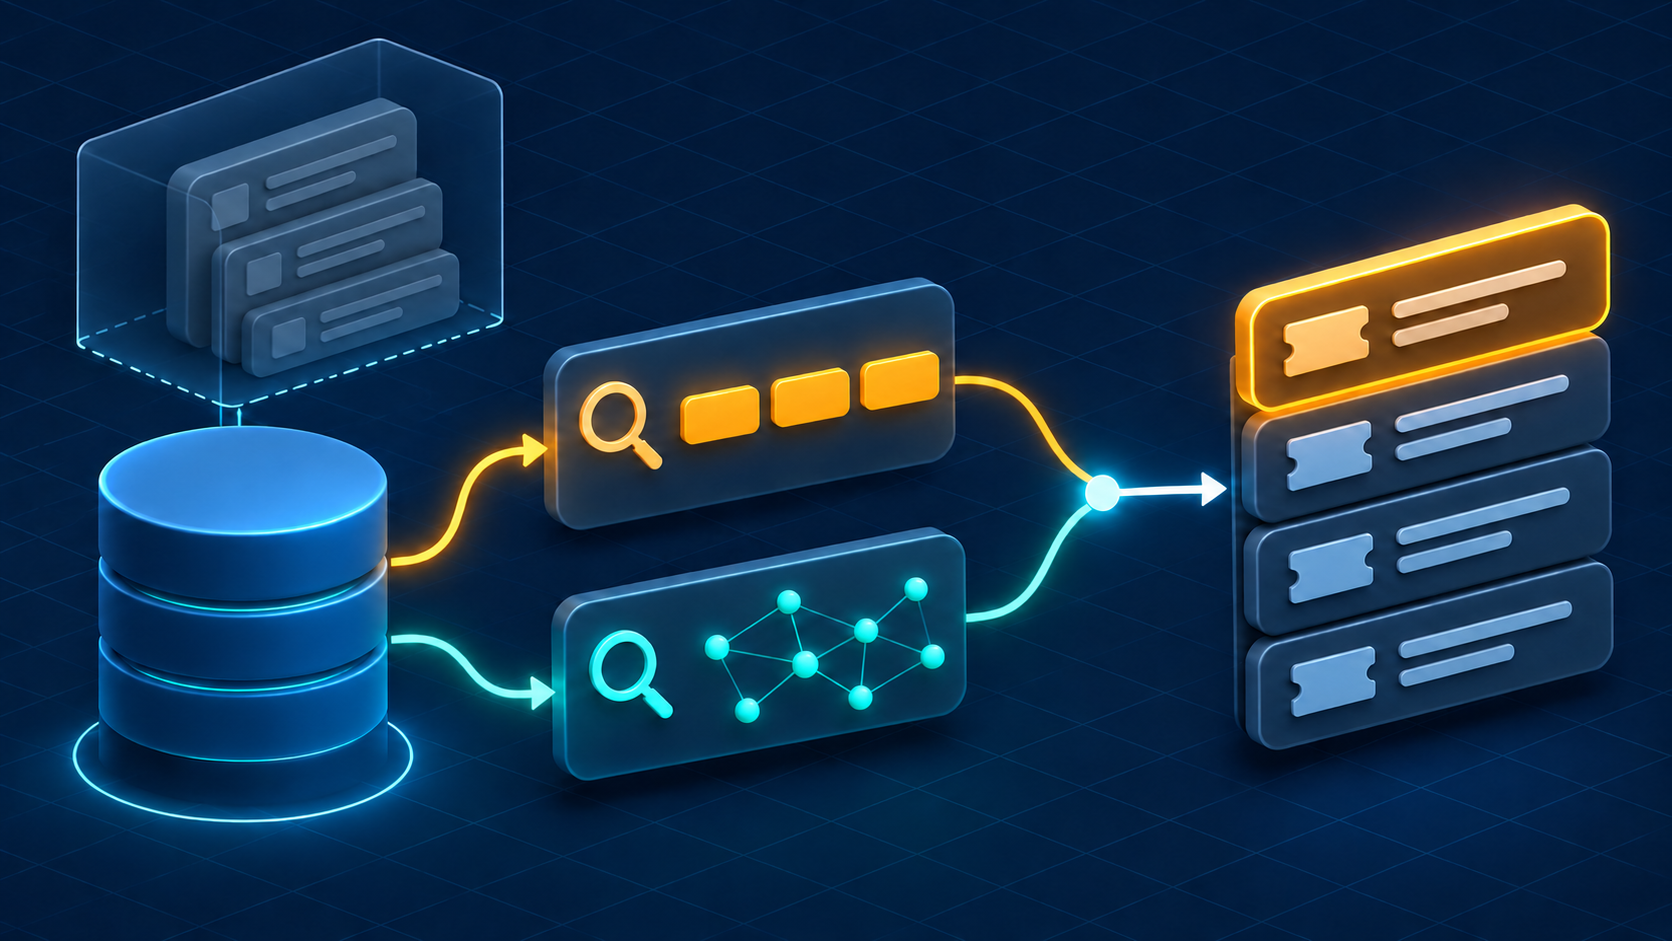
本文介绍在PostgreSQL中用pgvector为工单系统构建关键词、向量与混合检索,并接入Next.js路由。关键词检索适合错误码等精确标识,向量检索可匹配语义改写;混合检索用倒数排名融合合并两路结果,并优先精确错误码。租户过滤须在数据库层完成,配合行级安全策略。文章还演示HNSW近似索引在租户过滤下可能召回不足,需用迭代扫描并测量召回率。
延伸解读
混合检索的融合策略与局限
文章采用倒数排名融合(RRF)合并关键词与向量检索结果,并优先精确错误码。RRF基于排名而非原始分数,避免尺度差异问题。但融合分数并非置信度,顶部结果仍可能错误,尤其当两路证据均弱时。建议用人工标注的查询集评估,而非依赖固定阈值判断“无可靠匹配”。
租户隔离需在数据库层落实
文章强调租户过滤必须在数据库层完成,而非应用层后置过滤。通过行级安全策略(RLS)和事务内设置租户ID,确保查询仅返回当前租户数据。运行时角色需最小权限,不能拥有表或绕过RLS。此模式依赖应用控制连接并执行参数化SQL,不适合作为任意SQL的沙箱。
HNSW近似索引的召回风险
在租户过滤下,HNSW索引可能因后过滤导致返回行数不足。文章演示了关闭迭代扫描时召回为0,启用严格迭代扫描后恢复。但迭代扫描不保证精确召回。生产环境应对比精确搜索、普通HNSW和迭代HNSW的召回率与延迟,并记录查询计划,以权衡性能与准确性。
从实验向量到真实嵌入的注意事项
实验使用固定三维向量便于复现,但真实系统需统一嵌入模型和维度,并跟踪模型版本与文档修订。内容变更时重新嵌入,删除源数据时清理向量。模型迁移需新建索引或版本化存储,避免比较不兼容向量。同时为嵌入调用设置超时和输入限制,并在提供方不可用时降级到关键词搜索。
Q&A
在PostgreSQL中如何实现关键词、向量和混合检索?
文章使用pgvector扩展,在support_ticket表上分别建立全文搜索索引(GIN)和向量列。关键词检索通过tsvector和websearch_to_tsquery匹配,向量检索通过余弦距离排序,混合检索使用倒数排名融合(RRF)合并两路结果,并优先精确错误码。
为什么混合检索要用倒数排名融合(RRF)而不是直接相加分数?
因为文本排名和余弦距离的含义与尺度不同,直接相加没有意义。RRF使用候选在各列表中的排名位置计算得分(1/(常数+排名)),避免分数尺度问题,并提供一个可调优的基线。
如何确保多租户环境下搜索不会泄露其他租户的数据?
必须在数据库层进行租户过滤:在关键词和向量查询中都加上tenant_id条件,并启用行级安全策略(RLS),通过set_config设置事务局部的app.tenant_id,且运行时角色不能拥有表或绕过RLS。
HNSW近似索引在租户过滤下可能召回不足,如何检测和缓解?
可以构造其他租户的密集向量来模拟过滤失败,通过EXPLAIN ANALYZE观察计划,并计算recall@3(返回结果与精确top3的重合度)。缓解方法是启用迭代扫描(hnsw.iterative_scan = strict_order),但迭代扫描不能保证精确召回,需在生产中测量召回率与延迟。
在Next.js Route Handler中如何安全地执行混合搜索查询?
使用pg连接池,在事务中设置statement_timeout和事务局部的租户ID,然后执行参数化的混合搜索SQL。确保每个语句使用同一个客户端,提交后返回结果,并设置Cache-Control为private, no-store。
从实验向量迁移到真实嵌入模型时需要注意什么?
选择固定的嵌入模型和维度,为文档回填向量,查询使用同一模型。记录模型版本和文档修订,内容变更时重新嵌入,删除源时删除向量。模型迁移需要新索引或版本化存储,避免比较不兼容的向量空间。
