

分享一下vibe coding多agent并发编程
内容提要
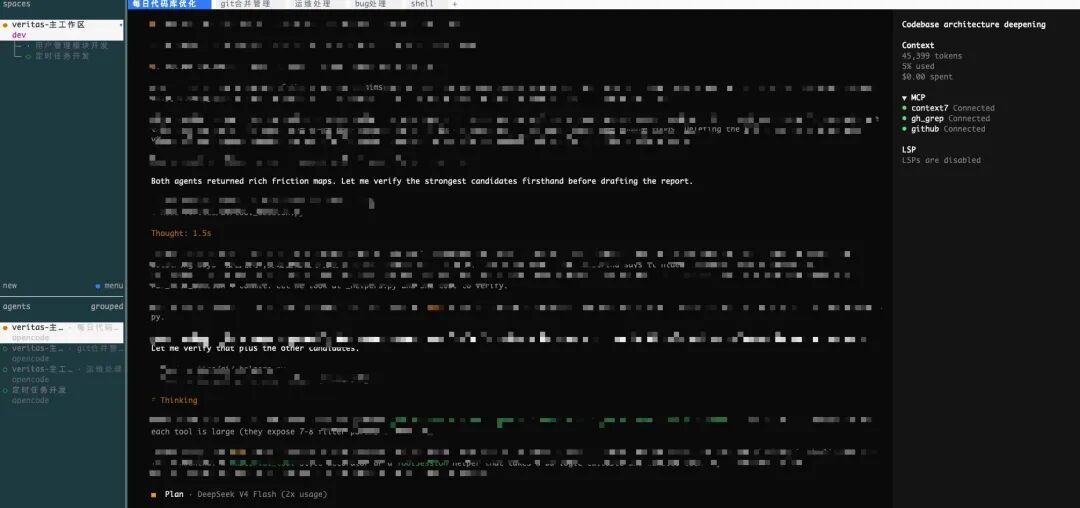
作者分享基于 herdr 的多 agent 并发编程工作流:按工作空间划分 worktree,每个 agent 使用 opencode,开五个标签页分别负责每日代码优化、git 合并、运维、bug 修复和终端。流程为拆分需求、建 worktree、用 plan 模式描述需求,并根据 agent 状态(红暂停、绿完成、黄运行)回复;复杂需求用 grill-me 对齐,验收后生成交接报告并合并。该方法适合短平快需求,但需频繁切换上下文,作者极限约两三个 worktree,且依赖对模型和测试用例的信任。
延伸解读
多 agent 并发的瓶颈在人的注意力
作者用 herdr 管理多个 worktree,每个 worktree 跑一个 opencode agent,并开五个标签页分别处理代码优化、git 合并、运维、bug 修复和终端。但作者明确说,频繁切换上下文对注意力要求很高,自己的极限是两三个 worktree,再多就容易搞混。这说明并发数量并不由工具决定,而受限于人同时跟踪多个任务状态的能力。
信任模型是提速的前提,测试用例是信任的底线
作者指出,这种方法隐含一个条件:你大致相信所选模型能完成需求,否则做得越快项目崩溃得越快。作者当前使用 DeepSeek v4 flash 0731 模型,并强调信任建立在测试用例全部通过的基础上。这意味着,多 agent 并发的效率优势,需要以可验证的测试作为安全网,而不是盲目放手。
前期对齐需求比后期返工更省时间
作者会在前期花较多时间整理需求,并与 AI 讨论实现:简单需求直接用 plan 模式交互,复杂需求则用 grill-me 的 skill 对齐。验收后还会让 AI 生成交接报告到固定目录,再合并 worktree。这套流程把沟通和验收前置,减少多 agent 并行时因理解偏差导致的返工,也方便后续合并与追溯。
Q&A
herdr 多 agent 并发编程的工作空间和标签页是怎么划分的?
每个工作空间对应一个独立的 worktree,agent 都使用 opencode。每个工作空间内一次启动五个标签页,分别负责:每日代码优化、git 合并开发、运维处理、bug 处理、shell 终端。
多 agent 并发编程的具体工作流程是什么?
流程为:确定需求→拆成 AI 10 到 30 分钟能完成的需求并分类→按分类创建 worktree→在 worktree 中用 plan 模式描述需求→等待 AI 探索→根据 agent 状态(红暂停、绿完成、黄运行)回复→复杂需求用 grill-me 对齐→验收后生成交接报告到 docs/handoff 并提交代码→回主工作空间合并 worktree→有新需求则从第 3 步重复。
agent 状态的红、绿、黄分别代表什么?
红色表示暂停,可能是 agent 在问问题或需要用户授权;绿色表示已经完成,会有声音提示;黄色表示正在干活。
这种多 agent 并发开发方法适合什么场景,有什么局限?
适合能将需求拆成短平快任务的场景。局限是注意力要求高,需要不断切换上下文,作者极限约两三个 worktree,再多容易搞混看不过来。
使用多 agent 并发编程有什么隐含前提或风险?
隐含前提是你要大致相信所选模型能完成需求,否则做得越快项目越快崩溃。作者使用 DeepSeek v4 flash 0731 模型感觉还行,信任建立在对应测试用例全部通过的基础上。
复杂需求和简单需求分别怎么和 AI 对齐?
简单需求直接用 plan 模式交互;复杂一点的需求用 grill-me 的 skill 对齐需求。前期会花较多时间整理需求并与 AI 讨论实现。
每日代码优化和交接报告是怎么处理的?
每日代码优化放在晚上进行,使用代码优化的 skill 检查需要优化重构的部分,比较费时所以等它慢慢优化。验收完成后让 AI 生成交接报告到固定目录如 docs/handoff,并提交代码。
