


[译][论文] InstructGPT:基于人类反馈训练语言模型遵从指令的能力(OpenAI,2022)
内容提要
本文讨论了通过人类反馈微调语言模型(如InstructGPT)以更好地理解用户意图。研究表明,这种微调显著提高了模型输出的质量和安全性,减少了虚假和有毒内容的生成。尽管InstructGPT在某些任务上不如GPT-3,但其遵循指令的能力更强,更符合用户期望。
延伸解读
对齐税:性能与安全的权衡
InstructGPT在遵循指令和安全性上优于GPT-3,但在SQuAD、DROP等公开NLP数据集上性能下降,这被称为“对齐税”。文章指出,通过混合PPO与预训练梯度(PPO-ptx)可大幅减少性能下降。这表明对齐并非免费,需在模型能力与人类偏好间寻找平衡,而技术手段可以缓解这一矛盾。
小模型胜大模型:参数并非一切
1.3B的InstructGPT输出被人类偏好的比例高于175B的GPT-3,说明模型规模并非决定输出质量的唯一因素。经过人类反馈微调后,小模型也能更好地理解用户意图。这提示我们,在追求更大参数量的同时,对齐训练同样关键,甚至能弥补规模上的不足。
泛化到新标注员:偏好的一致性
InstructGPT能泛化到未参与训练数据的标注员,这些标注员同样更偏好其输出。训练标注员之间一致率为72.6%,而留出标注员为77.3%,表明模型学到的偏好并非过拟合于特定群体。但文章也指出,仍需研究更广泛用户群体及人类偏好存在分歧时的表现。
安全性的局限与未来方向
尽管InstructGPT减少了有毒和虚假内容,但在Winogender和CrowSPairs等偏见数据集上未见明显改进,且仍会犯简单错误,如捏造事实或无法检测错误前提。文章强调,对齐研究仍处于早期,需更多工作提高安全性和可靠性,尤其是在处理有争议或敏感主题时。
Q&A
InstructGPT是如何通过人类反馈进行微调的?
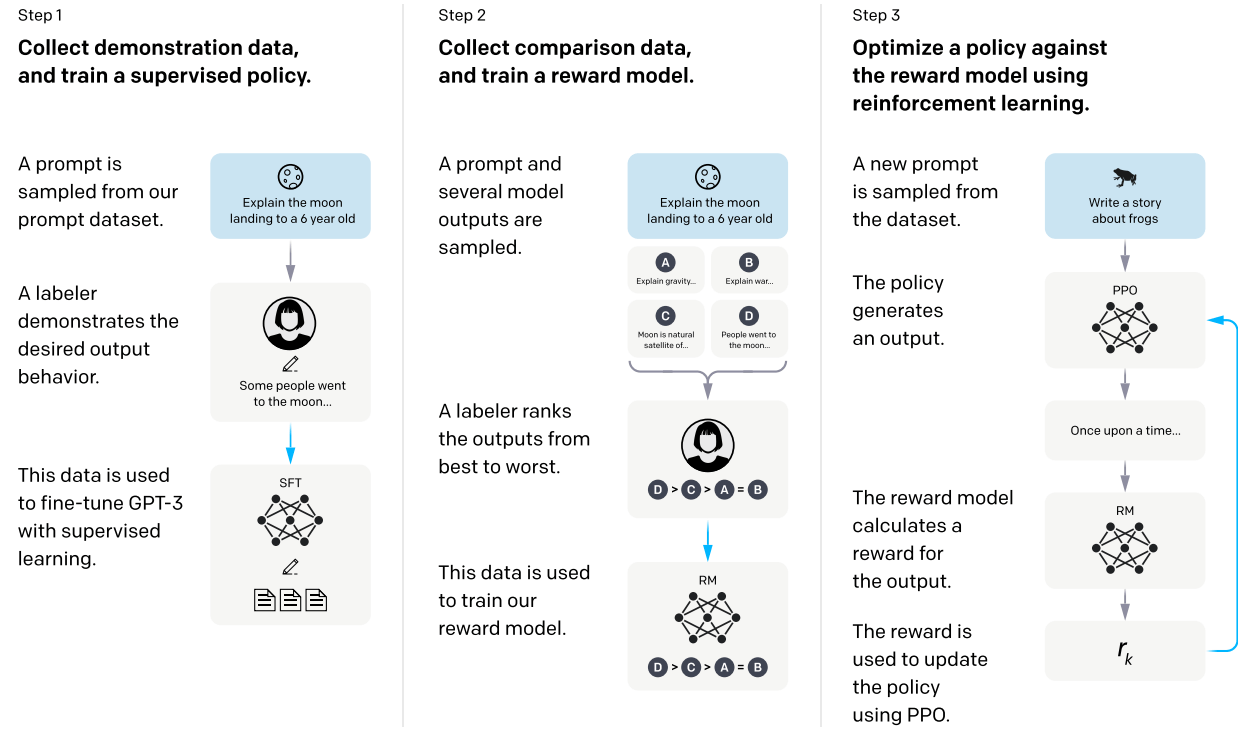
InstructGPT通过三个步骤进行微调:收集示例数据、训练监督策略和使用奖励模型进行优化。
InstructGPT与GPT-3相比有哪些优势?
InstructGPT在遵循指令的能力上更强,生成的输出更符合用户期望,且在TruthfulQA基准测试中生成真实和信息丰富的答案的概率比GPT-3高约一倍。
使用人类反馈微调语言模型的好处是什么?
这种微调显著提高了模型输出的质量和安全性,减少了虚假和有毒内容的生成。
InstructGPT在某些任务上表现不佳的原因是什么?
在某些公开NLP数据集上,InstructGPT相比GPT-3存在性能下降,这是对齐过程中的一个“对齐税”。
InstructGPT的泛化能力如何?
InstructGPT能够推广到未参与编写训练数据的标注员,显示出良好的泛化能力。
InstructGPT在生成有毒内容方面的表现如何?
当提示模型需要尊重时,InstructGPT生成的有毒输出比GPT-3少约25%。
