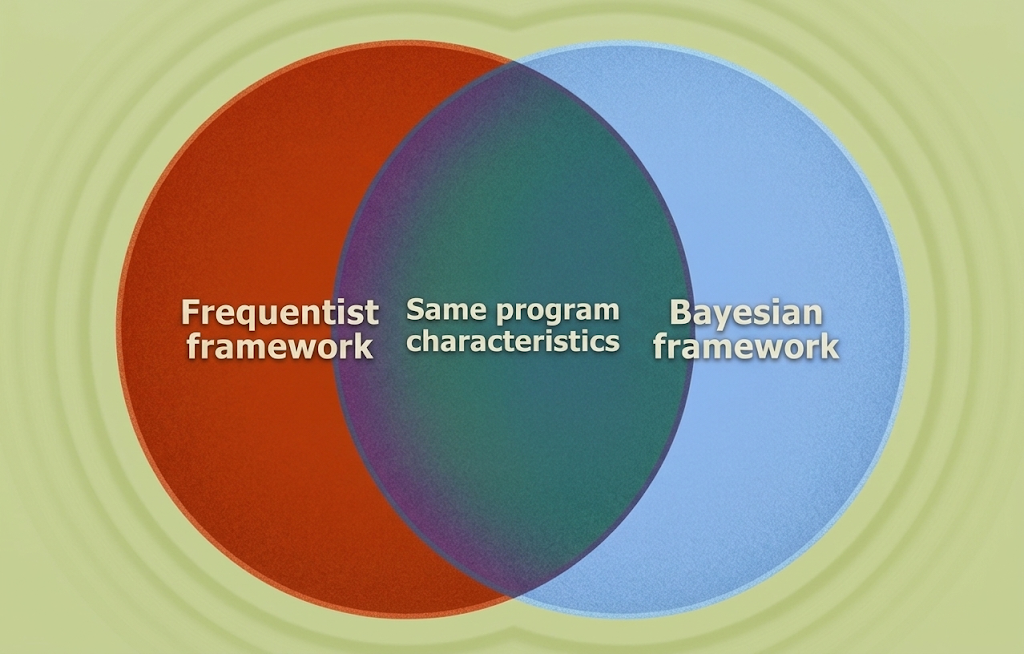



贝叶斯A/B测试并非单一方法,其效果取决于先验和停止规则等配置。默认平坦先验加后验概率阈值会重现频率派的偷看问题,而贝叶斯因子停止可控制错误率。经验贝叶斯先验能纠正赢家诅咒,但需高质量维护。贝叶斯与频率派方法在常见配置下等价,Spotify因维护成本高,暂不采用贝叶斯推断。
语音增强(SE)面临数据、目标和任务等挑战,自监督学习(SSL)逐渐成为解决方案。SSL通过未配对数据学习和生成式方法,重塑了SE的训练目标。研究表明,SSL特征在增强任务中有效,未来将关注多任务统一增强、低信噪比生成模型及可控的语音生成。整体来看,SSL为SE提供了更强的先验和设计空间。
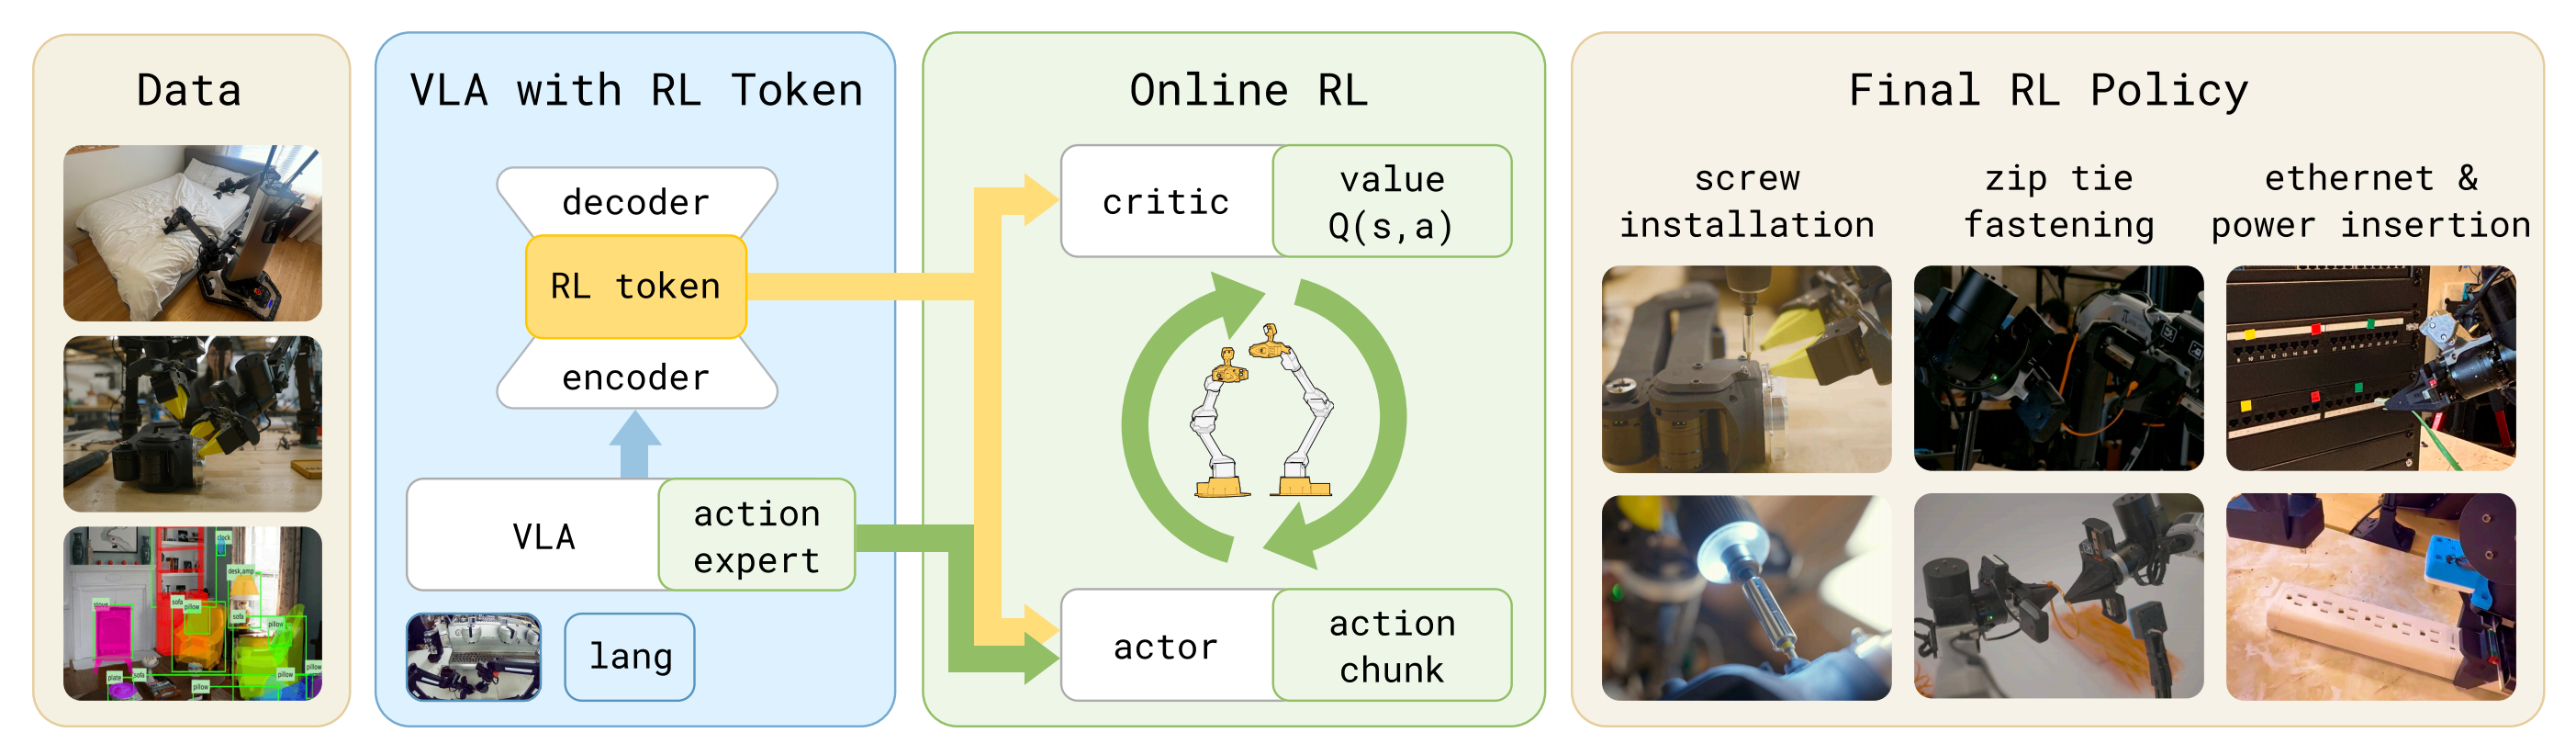
本文讨论了一种轻量级的在线强化学习方法,用于微调视觉-语言-动作模型。研究者通过引入“RL token”提高样本效率,使得模型能够快速适应真实世界任务。该方法结合冻结的VLA和小型actor-critic网络,优化关键任务阶段的表现,旨在实现高效的在线微调,同时保持泛化能力。
北京大学彭宇新团队提出了分类感知表征对齐方法TARA,旨在解决多模态大模型在生物类别分层识别中的挑战,提升细粒度和分层视觉识别的准确率。该方法通过对齐大模型与生物基础模型的表征,注入类别树知识,从而增强模型的识别能力。
本文介绍了MetaWorld,一个基于分层世界模型的机器人控制框架,旨在弥合高层语义理解与低层物理执行之间的鸿沟。该框架结合视觉-语言模型、模仿学习和强化学习的优势,通过分层架构进行任务解析和动作生成,提升机器人在动态环境中的适应性和泛化能力。
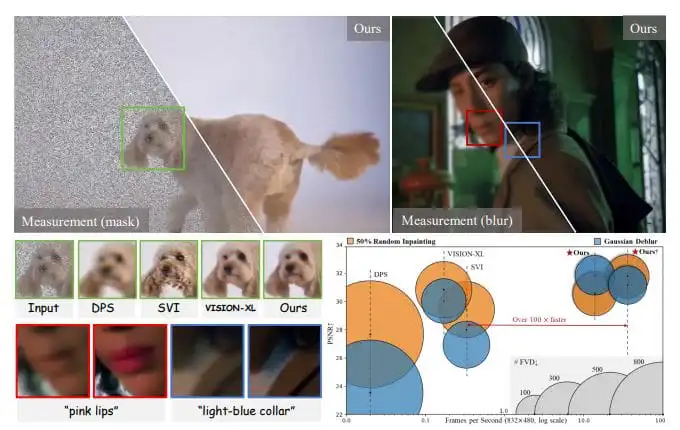
研究团队开发了InstantViR框架,成功解决了实时高质量视频重建的难题。该系统通过简化视频扩散模型,实现每秒超过35帧的处理速度,重建质量优于现有技术,为视频会议和直播等应用带来了新机遇。
MIT团队提出SpectroGen模型,通过物理先验生成高保真光谱,解决了传统材料表征效率低、成本高的问题,实现了材料发现与验证的同步,推动材料科学向新范式发展。
本文讨论了DreamControl,一种结合扩散模型与强化学习的全身类人机器人控制方法。该方法利用人类动作数据生成自然运动轨迹,提升机器人在复杂环境中的自主操作能力,解决了稳定性和协调性问题。研究表明,该方法在多种任务中有效,推动了人形机器人技术的发展。
Evo-0模型通过隐式注入3D几何先验,提升机器人对三维空间的理解,成功率提高31%。该方法无需额外传感器,利用VGGT提取3D信息,显著增强空间感知,训练效率高,适用于多种机器人任务。
本文介绍了一种新框架MAPLE(基于偏好的模态对齐学习),通过多模态大语言模型(MLLM)指导跨模态表示学习。MAPLE利用MLLM的细粒度对齐先验,采用强化学习方法构建自动偏好数据,并引入相对偏好对齐损失(RPA),显著提升了跨模态检索效果,尤其在处理细微语义差异方面表现突出。
本研究针对现有面部图像压缩方法在低比特率下重建图像质量不佳的问题,提出了一种新的面部图像压缩方法FaSDiff。该方法通过高频敏感压缩器和低频增强模块相结合,有效保留面部图像的高频信息,从而在确保人类视觉效果的同时,降低机器视觉中的语义不一致性。实验表明,FaSDiff在提升人类视觉质量和机器视觉精度的平衡方面超过了现有的最先进方法。
本研究解决了多模态大型语言模型(MLLMs)在视觉和语言深度对齐方面的挑战,指出这些模型往往未能充分利用视觉输入。论文提出新的技术,以加深模型对视觉内容的理解,并确保这些视觉洞察有效地指导语言生成,最终在视觉依赖的任务中实现显著的性能提升。
本研究提出了一种新方法,通过引导大型语言模型不依赖先验知识,显著提高其在确定性任务中的准确性,并利用可解释性技术调整神经网络中的先验影响。
本研究针对强化学习在学习新任务时忽视先验知识的问题,提出了一种通过贝叶斯非参数模型有效捕捉技能多样性的先验知识方法。研究表明,使用这种灵活的技能先验,能够显著提升机器人的学习和执行能力,尤其是在复杂的长时域任务中,促进技能转移和任务成功。
本研究提出了一种新的后训练偏好对齐方法,旨在缩小多智能体运动生成模型与人类偏好之间的差距。通过利用先前训练示范中的隐式反馈,显著提高了生成行为的真实性和一致性,无需额外的人类偏好注释。
本研究提出了一种新颖的插拔式朗之万取样方法,针对低光子泊松成像问题,结合边界反射和泊松似然近似,提高了成像模型的准确性与稳定性。
本研究提出了一种变分贝叶斯推断框架(VINP),旨在解决混响语音信号的去混响和盲室冲激响应(RIR)识别问题。通过结合深度神经网络预测先验分布,显著提升了自动语音识别(ASR)和盲RIR识别的性能。
本研究提出PIPA框架,以统一理解语言模型的偏好对齐问题。通过最大似然估计,PIPA实现了3-10%的性能提升,并有效整合了先验信息。
本研究针对现有单目神经形态相机在3D重建中的不足,提出了一种无物理先验的端到端方法。该方法引入了新颖的事件表示,增强了边缘特征学习的效果,并通过优化二值化阈值选择原则提供了未来研究的指导。实验结果表明,该方法的重建精度比基线方法提高了54.6%。
本研究探讨了提示调优中嵌入崩溃现象对模型性能的影响,发现嵌入先验显著影响调优位置,模型能够有效处理不同激活空间的嵌入,且生成轨迹超出模型激活空间,揭示了大规模语言模型的泛化能力。
完成下面两步后,将自动完成登录并继续当前操作。