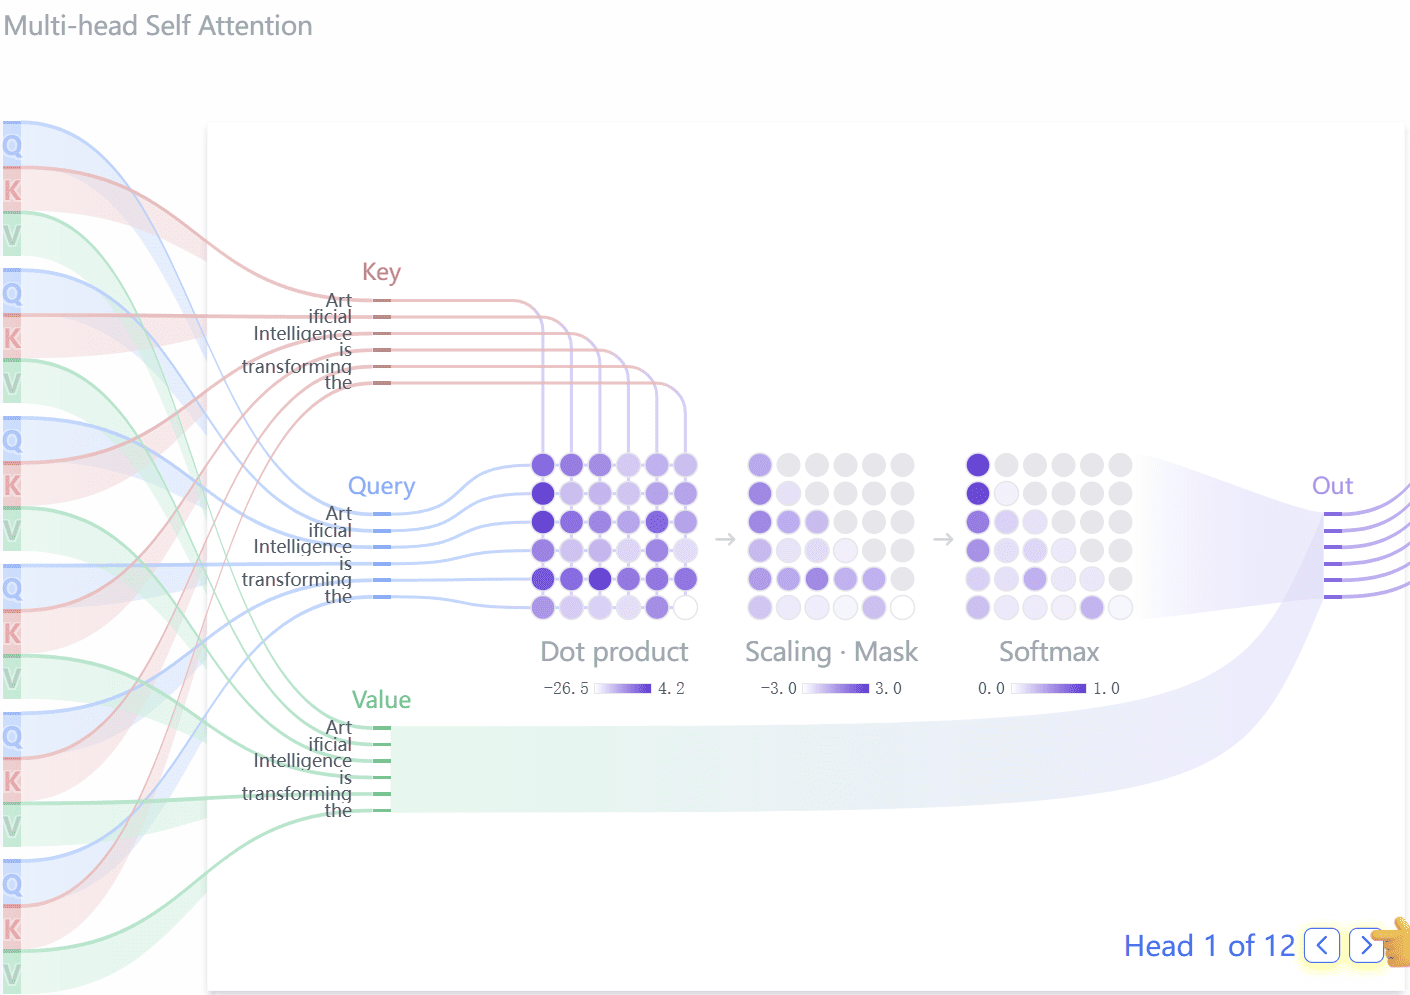



本文介绍了Transformer模型的注意力机制及其背景。传统的卷积神经网络(CNN)和循环神经网络(RNN)在处理长距离依赖时存在局限,而Transformer通过自注意力机制解决了这些问题。模型使用位置编码来区分词序,核心是通过Query、Key和Value计算注意力权重。多头注意力允许模型并行处理不同关系,增强表达能力。混合专家模型(MoE)通过选择部分专家参与计算,提高了效率和性能。
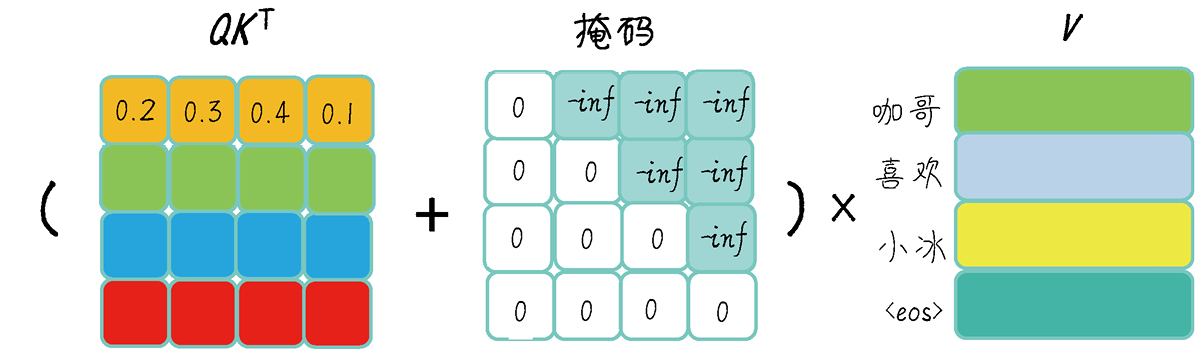
本文探讨了注意力机制中的QKV、多头注意力和掩码。QKV分别代表查询、键和值,通过矩阵变换提取特征。多头注意力将输入分为多个子空间,从不同角度学习特征。掩码用于将不重要的信息权重设为接近“0”,以优化注意力计算。
本文探讨了大型语言模型(LLM)的训练与推理过程,重点介绍了向量点积、Softmax、LayerNorm、Token化、BPE编码、位置嵌入、自注意力机制和多头注意力等关键概念。这些技术使模型能够理解词语的上下文关系并生成连贯的文本。训练过程中通过损失函数和反向传播优化模型参数,以提高预测准确性。
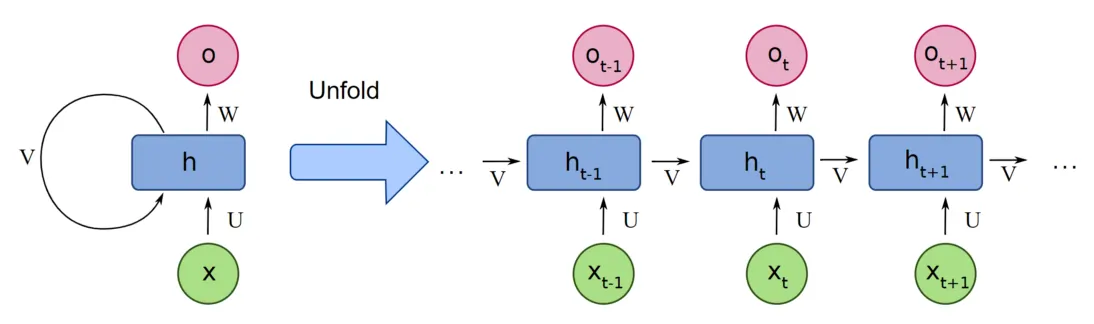
本文探讨了自注意力机制的核心概念及其与传统模型的比较。自注意力允许序列内的每个token相互沟通,解决了RNN的长依赖问题。由于自注意力对位置无知,需通过位置编码注入位置信息。多头注意力使不同头学习不同关系。尽管自注意力在长序列处理上表现优异,但其计算复杂度为O(N²),引发了对优化的研究。
多头注意力机制的核心在于独立计算不同的注意力分布,而非简单平均。理解位置限制和计算复杂度是后续研究的重点。
本文介绍了Transformer模型的结构与工作原理,包括输入嵌入、位置编码、自注意力机制和多头注意力等模块,强调了缩放点积注意力的重要性及其通过交叉熵损失函数进行训练的方法。
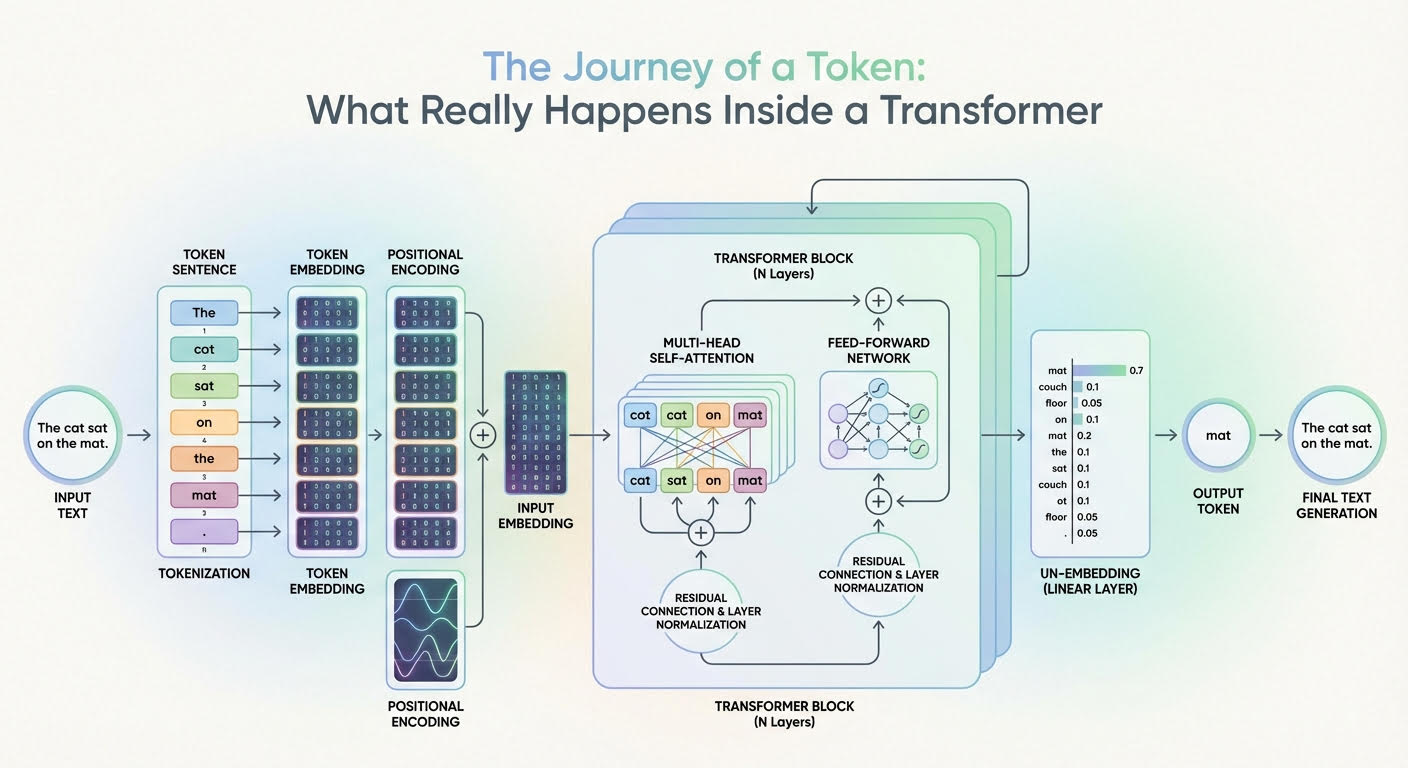
大型语言模型(LLMs)利用变换器架构将文本转化为数字表示。文本首先被分割为标记,随后每个标记转化为向量并注入位置信息。模型通过多头注意力机制和前馈神经网络逐步学习文本关系,最终预测下一个单词,从而生成连贯的输出。
本文介绍了变换器模型如何将输入标记转换为上下文感知的表示和下一个标记的概率。文本经过标记化和嵌入处理,加入位置信息。通过多头注意力机制和前馈神经网络,逐层提取和丰富标记的上下文信息,最终通过线性层和softmax计算生成下一个标记的概率。这一过程展示了大型语言模型的文本处理与生成能力。
本文探讨了Transformer模型在序列建模中的重要性,解决了RNN和CNN在并行计算及长距离依赖方面的局限。通过多头注意力机制和位置编码,Transformer显著提升了语言建模和机器翻译的效果。
本文介绍了多头注意力机制和分组查询注意力的基本概念。注意力机制帮助模型理解序列中词语之间的关系,尤其在长距离依赖情况下。多头注意力通过多个投影矩阵并行处理信息,提高模型表现;分组查询注意力通过共享键和值的投影降低计算成本,提升效率。
本文探讨了变换器架构中的注意力机制,强调其在生成式AI模型中的关键作用。与传统递归神经网络不同,注意力机制能够同时处理文本序列中的所有标记,捕捉长距离依赖关系,从而提升语言理解能力。多头注意力机制进一步增强了模型的表现,使其能够学习不同的语言和语义特征。
变压器是一种深度学习架构,通过编码器和解码器结构及多头注意力机制,克服了传统自然语言处理模型的局限性,有效捕捉长距离依赖关系。它在自然语言处理和计算机视觉领域取得了重大突破,推动了GPT、BERT等大型语言模型的发展。
DeepSeek-V3 是一款强大的混合专家语言模型,拥有671B参数,采用多头潜在注意力架构,经过高效训练和微调,支持多令牌预测,性能优于其他开源模型。DecryptPrompt和Semantra等项目推动AIGC应用,提供丰富的资源和工具,适合各种用户。
本研究探讨了变压器模型在短序列训练后对长序列泛化不良的问题。通过分析消失方差,证明了长序列导致多头注意力模块输出方差降低。实验结果表明,在注意力输出后应用层归一化能显著改善长度泛化效果,减少分布偏移。
本研究提出了一种新模型,通过语言无关的数据增强和多头注意力加权嵌入,解决低资源班图语言文本分类中的数据短缺问题,提升分类性能。
本文提出了一种名为MHA2MLA的数据高效微调方法,旨在降低深度学习模型中多头注意力推理的成本。研究表明,该方法能够使用0.3%到0.6%的数据恢复性能,同时显著降低推理成本并压缩KV缓存。
大型语言模型中的注意力机制帮助理解单词间关系,生成有意义的回应。注意力机制像聚光灯,聚焦句子中的不同单词,评估其重要性。多头注意力使模型从多个角度理解文本,处理长距离依赖,提升自然语言处理能力。
本研究提出了一种新方法——多头注意力特征融合(MHAFF),结合卷积神经网络与Transformer的优势,牛只识别准确率分别达到99.88%和99.52%。
本研究提出了一种利用面部深度图增强面部操纵检测鲁棒性的方法。通过面部深度图变换器和多头深度注意力机制,有效捕捉操纵导致的局部深度异常,实验结果表明该方法在检测中具有显著优势。
本研究提出了一种新型变压器架构MemoryFormer,通过使用内存查找表替代全连接层的线性投影,降低了大型语言模型的计算复杂度,优化了多头注意力操作,实现了效率与性能的新平衡。
完成下面两步后,将自动完成登录并继续当前操作。