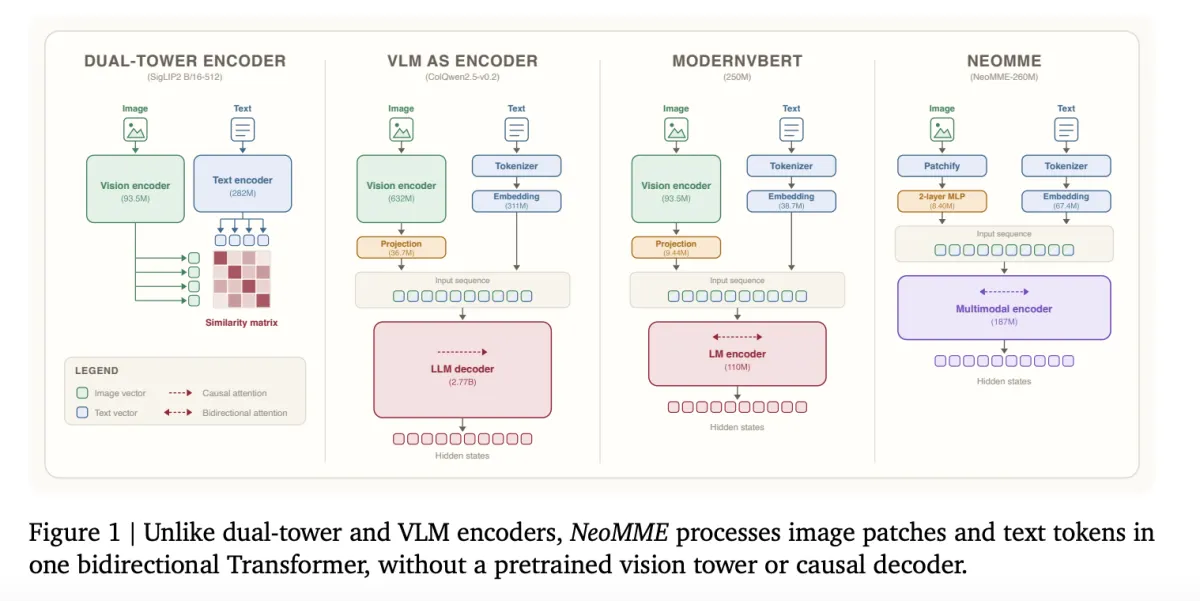


H公司发布NeoMME系列双向编码器,采用单塔架构同时处理文本与图像块,移除视觉塔和因果解码器。其中NeoMME-Retriever-260M在ViDoRe v3基准上达到0.523 nDCG@10,性能媲美3.75B模型,但体积小14倍。该模型支持高效索引压缩,但纯文本检索能力较弱。
谷歌扩展了Gemini API的文件搜索功能,增强了多模态检索能力。新功能支持图像与文本混合检索、自定义元数据过滤和页面级引用,提高了AI在企业知识库和文档问答中的准确性。开发者可直接使用Gemini API,无需复杂的向量数据库,适合构建企业级知识助手和客服机器人。
JoyCastle与亚马逊云科技合作,利用Amazon Nova Multimodal Embeddings构建了智能广告素材管理系统,实现了从人工标签到AI语义搜索的转变,解决了传统素材管理的高成本和低效率问题,提升了创意团队的生产力,并为广告创意的智能化提供了可能。
AMES(近似多模态企业搜索)是一种支持文本、图像和视频跨模态检索的统一架构。它采用两阶段管道,结合并行搜索和优化重排序,展示了高效的检索性能,尤其在可扩展的Solr系统中表现出色。
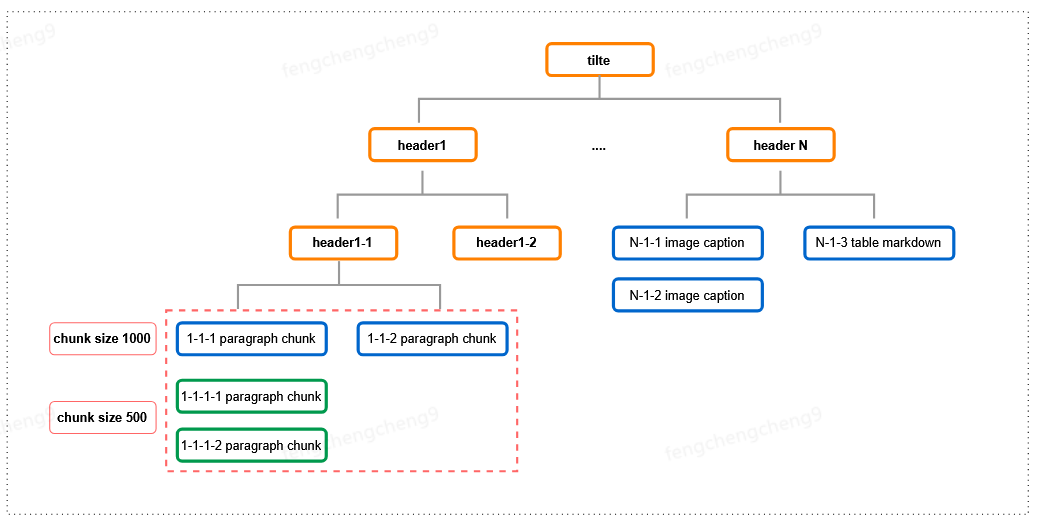
京东的JoyAgent平台今年开源了多模态RAG能力,旨在提升智能体技术,解决传统RAG在处理多种数据格式时的局限性,支持动态知识管理和多模态检索,提升企业知识利用效率。未来将继续融合多种能力,推动智能系统发展。
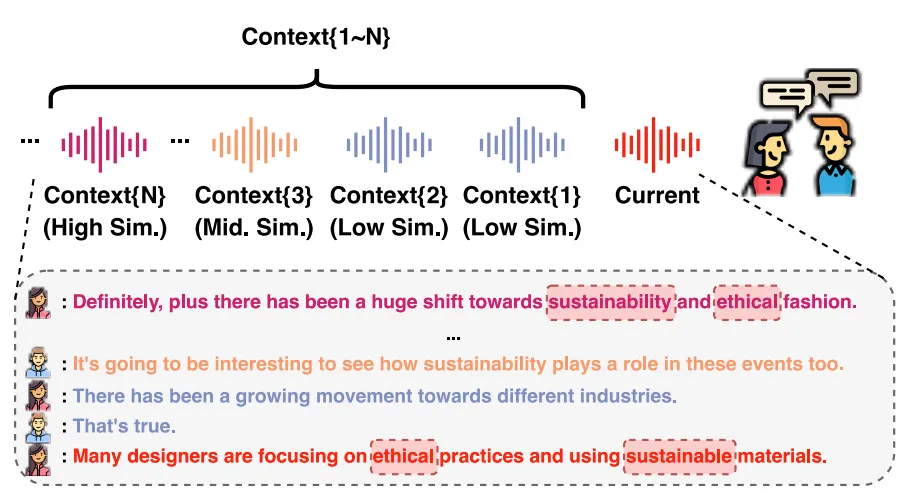
西北工业大学与南洋理工大学合作提出MARS方法,通过多模态检索和选择历史上下文,提升对话语音识别(ASR)性能。该方法在MLC-SLM数据集上表现优异,展示了有效利用历史上下文的潜力。
快手与东北大学联合推出UNITE框架,旨在解决多模态检索中的跨模态干扰问题。该框架能够处理文本、图像和视频等多种输入,采用模态感知对比学习机制,显著提升检索性能。在多个评测中,UNITE表现优异,超越现有模型,展现出良好的通用性和综合性能。
本周LlamaIndex通讯介绍了深度研究代理工作坊、新的LlamaParse功能和多模态检索技术。纽约将举办金融领域的独家活动,学习构建多代理系统和使用Voyage AI的多模态嵌入。LlamaParse的新特性提升了AI应用的引用和推理能力。
本研究提出CAFe框架,首次在大型视觉语言模型中同时提升表征学习与生成能力,推动多模态检索与生成基准的发展。
智源发布的BGE-VL模型在多模态检索中表现优异,仅需1/70的数据量即可实现更好的效果。该模型通过MegaPairs合成数据,训练出2600万条样本,显著提升了检索性能,并在多个基准测试中超越传统方法,展现出高效性和可扩展性。
北京大学彭宇新教授团队研究了多轮组合图像检索,提出FashionMT数据集和MAI模型,解决了历史上下文缺失和数据规模限制的问题。实验结果显示,MAI在FashionMT基准上的召回率提升了8%,有效优化了多模态检索性能。
本研究提出了一种基于图表的多模态检索增强生成(MRAG)任务,针对现有基准在简单图像-文本互动方面的局限性,引入新的评估框架CHARGE,通过结构化关键点提取和跨模态验证,建立全面的图表基础MRAG评估基准。
Sentrev是一个Python库,旨在简化嵌入模型的评估,帮助用户选择适合文本数据的最佳模型。它支持多种文档格式,提供检索准确性指标和性能分析,并与Qdrant和FastEmbed集成,未来计划扩展到多模态检索。选择合适的嵌入模型对提高检索效率至关重要。
本研究提出了一种名为MegaPairs的新型数据合成方法,旨在解决多模态检索中的训练数据不足问题。该方法通过视觉语言模型生成大规模合成数据集,显著提升了检索器的性能,超越了基线模型,并具备良好的扩展性。
本研究提出了一种名为Ret-XKnow的端到端多模态检索系统,通过动态模态交互解决了图像理解模型分离的问题,显著提升了零样本检索性能和微调场景的表现。
本研究构建了Dyn-VQA数据集,解决了现有多模态检索增强生成方法的非适应性和过载问题。提出的自适应规划代理OmniSearch在动态问题中表现优越,为mRAG的发展提供了新方向。
该研究介绍了多模态检索系统“时尚聚焦”,用于视频与购物匹配,结合图像和文本特征。提出K3M方法以解决电商数据中的噪声问题,利用M5Product数据集和SCALE框架实现特征融合。CommerceMM模型在多任务中表现优越,MIEM提高了图像搜索准确性,ARMMT方法提升了商品推荐精准性,优化了搜索相关性,显著改善用户体验。
本文介绍了多个视频处理相关的数据集和模型,如 Moments-OVRE、Countix 和 TVR,重点在于视频中重复动作的识别与计数。研究表明,结合音频信息和新型网络结构可以显著提高模型性能,尤其在复杂视觉条件下。此外,提出的多模态检索任务和数据集为视频分析提供了新的方法和基准。
大型语言模型(LLMs)在应用中面临幻觉和知识更新慢等挑战。检索增强生成(RAG)通过外部知识库改善回答质量。论文总结了三种RAG范式及其组成部分,讨论了评估方法和未来研究方向。研究表明,结合多模态检索和增强技术可显著提高问答系统的效率和准确性,为RAG领域的发展提供了新思路。
本文探讨了如何通过大型语言模型提升多模态双编码检索系统在多语言和跨语言任务中的性能。研究表明,改进语义表示和检索模型能够有效提高语音与文本的匹配率,增强跨语言检索能力。
完成下面两步后,将自动完成登录并继续当前操作。