小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
一分钟读论文:《测试时扩展:瓶颈在筛选,不在采样》

该论文首次在开放生成任务上对比五种测试时扩展方法,发现瓶颈不在生成候选(探索有效),而在选择最终答案(利用失效)。奖励模型相关性低,BoN近乎随机,Fusion仅回收约40%增益。树搜索多样性坍缩,自我修正多无效。结论:候选池非瓶颈,选择才是,Fusion是目前唯一一致有效方法。

一分钟读论文:《测试时扩展:瓶颈在筛选,不在采样》

Micropaper Micropaper · 2026-08-21T00:00:00Z

后训练是一个复杂的数据流水线,包含多个阶段,如SFT、奖励模型和策略优化。每个阶段旨在将预训练模型转变为更符合人类指令和偏好的模型。SFT主要调整回答格式,奖励模型提供训练信号,策略优化提升生成候选的能力。评测确保模型的安全性和准确性,整体流程强调数据回流和持续优化,以提升模型性能和可靠性。

【强化学习与大模型后训练】06|后训练全景:SFT → RM → RLHF → 评测

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-05-29T00:00:00Z

本文探讨了大模型对齐的流程,包括监督微调(SFT)、奖励模型(RM)和强化学习(RL)。对齐不仅提升了模型对指令的理解能力,还影响推理能力和回答质量。文章介绍了直接偏好优化(DPO)作为一种新方法,简化了训练流程,减少了模型数量,提高了效率。未来研究将关注可验证奖励和长上下文推理,以增强模型的推理能力和应用范围。

【大模型基础设施工程】09:RLHF 与对齐流水线

土法炼钢兴趣小组的博客 土法炼钢兴趣小组的博客 · 2026-04-22T00:00:00Z

上海AI Lab提出的POLAR新范式通过参考答案灵活打分,提升了强化学习中奖励模型的可扩展性和泛化能力,克服了传统模型的局限性,展现出显著的Scaling效应。

奖励模型也能Scaling!上海AI Lab突破强化学习短板,提出策略判别学习新范式

量子位 量子位 · 2025-07-11T03:19:21Z
Crome:Google DeepMind 的因果框架,用于 LLM 对齐中建立稳健奖励模型

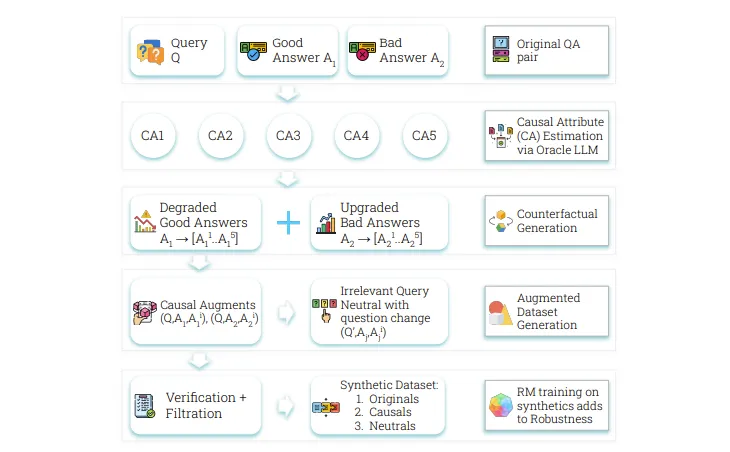
奖励模型(RM)面临奖励黑客攻击的挑战,难以区分表面属性与真实质量。Crome框架通过因果增强和中性增强策略,提高了RM的稳健性和准确性,有效解决了训练中的虚假相关性问题,优于传统方法。

Crome:Google DeepMind 的因果框架,用于 LLM 对齐中建立稳健奖励模型

实时互动网 实时互动网 · 2025-07-04T02:35:51Z

张丽及其团队在微软亚洲研究院引入“System2”概念,提升大模型的深度推理能力。通过蒙特卡洛搜索算法,7B模型的数学推理能力接近OpenAI的o1,激发了学术界的广泛讨论。她指出智商和推理能力是大模型应用的关键,未来将继续优化奖励模型并扩展任务领域。

她如何把“系统2”带给了大模型 |对话微软亚洲研究院张丽

量子位 量子位 · 2025-05-26T04:20:12Z

本研究提出了一种新颖的数据标注方法,解决了现有过程奖励模型在长链推理中仅关注初始错误的问题。通过引入错误传播和终止概念,显著提升了模型在自我纠正和推理方面的性能,实验结果优于现有模型。

Beyond the First Error: Process Reward Models for Reflective Mathematical Reasoning

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-20T00:00:00Z

本研究提出R3框架,以解决现有奖励模型在可控性和可解释性方面的不足,从而增强语言模型与人类价值观的一致性和灵活性。

R3: Robust Reward Models without Evaluation Standards

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-19T00:00:00Z

清华、复旦和港科大联合发布RM-BENCH基准,旨在评估奖励模型的认知敏锐度,解决“形式大于内容”的问题。该基准关注模型对细微内容差异的敏感性和风格偏差的鲁棒性,涵盖聊天、代码、数学和安全等领域。研究表明,现有奖励模型在这些领域表现不佳,亟需改进。

首个奖励模型评分基准!清华复旦港科大联合攻克AI评委“偏科”

量子位 量子位 · 2025-05-13T08:19:10Z

本文探讨了基于人类反馈的强化学习中奖励模型过度优化的问题,提出了一种新正则化方法——批量归零正则化(BSR),显著提升了模型的鲁棒性和泛化能力。

语言模型对齐中奖励模型的鲁棒性研究

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-12T00:00:00Z

本研究提出了一种遍历生成流(EGF),旨在解决生成流网络在模仿学习中的训练难题,并优化了流匹配损失和奖励模型。实验结果表明其在2D任务和NASA数据集上有效。

Traversing Generative Flow

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-06T00:00:00Z

本研究提出了一种通过奖励模型对视觉语言模型(VLM)进行过程监督的方法,显著提升了其在复杂图形用户界面交互中的表现,静态环境下一步行动准确率提高3.4%,动态环境任务成功率提高约33%。

在推理时使用过程奖励指导 VLM 代理进行 GUI 导航

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-22T00:00:00Z

本研究探讨了结合强化学习与符号执行技术以提升代码生成大语言模型(LLMs)微调性能的方法。改进后的奖励模型在生成代码质量上显著优于现有基准CodeRL,展示了符号执行的潜力。

Integrating Symbolic Execution into the Fine-Tuning of Code Generation Large Language Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-21T00:00:00Z

该研究提出了一种新的可靠性度量指标“RETA”,旨在解决大型语言模型中奖励模型的不确定性问题,并提供了集成基准测试管道,帮助研究人员评估奖励模型的可靠性。实验结果表明,RETA在评估奖励模型的可靠性方面表现优异。

Establishing Reliability Metrics for Reward Models in Large Language Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-21T00:00:00Z

本研究提出了一种名为CHARM的校准方法,旨在解决奖励模型中的偏差问题,从而提高评估的准确性和与人类偏好的相关性,促进更公平可靠的奖励模型构建。

CHARM: Calibrating Reward Models Using Chatbot Arena Scores

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-14T00:00:00Z

本文探讨了评估和提升AI生成文本的写作质量,提出了写作质量基准(WQ)和训练写作质量奖励模型(WQRM)。研究表明,WQRM在质量评估中表现优越,能够选择更高质量的输出。人类评估显示,使用WQRM选择的文本获得了66%的专家偏好,从而提升了AI写作系统的质量对齐。

From AI Draft to AI Polish? Aligning Language Models through Edit-Based Writing Rewards and Test-Time Computation

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-10T00:00:00Z

研究团队提出了RLVR框架,将强化学习应用于医学、法律等多个领域,使用7B奖励模型显著提升了复杂任务的表现。通过软奖励机制,模型在处理非结构化答案时更加灵活,无需特定领域的标注。

大模型RL不止数学代码!7B奖励模型搞定医学法律经济全学科, 不用思维链也能做题

量子位 量子位 · 2025-04-02T09:08:50Z
为什么明明很准,奖励模型就是不work?新研究:准确度 is not all you need

普林斯顿大学的研究表明,训练狗和设计RLHF奖励模型都需要考虑奖励的多样性。奖励模型的准确性并不等同于优化效率,低奖励方差会减缓优化速度。因此,不同策略应采用不同的奖励模型,以提升优化效果。

为什么明明很准,奖励模型就是不work?新研究:准确度 is not all you need

机器之心 机器之心 · 2025-03-24T05:12:44Z

本研究探讨了奖励模型在强化学习中的有效性,指出仅依赖准确性无法全面评估其教学能力。建议通过降低奖励方差来提高模型训练效率。

什么使得奖励模型成为优秀的教师?优化视角

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-19T00:00:00Z

本文介绍了MPBench,一个多任务多模态基准,旨在评估过程级奖励模型(PRMs)在不同场景中的有效性,以提高推理准确性并推动多模态PRMs的发展。

MPBench: A Comprehensive Multimodal Reasoning Benchmark for Process Error Identification

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-16T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码