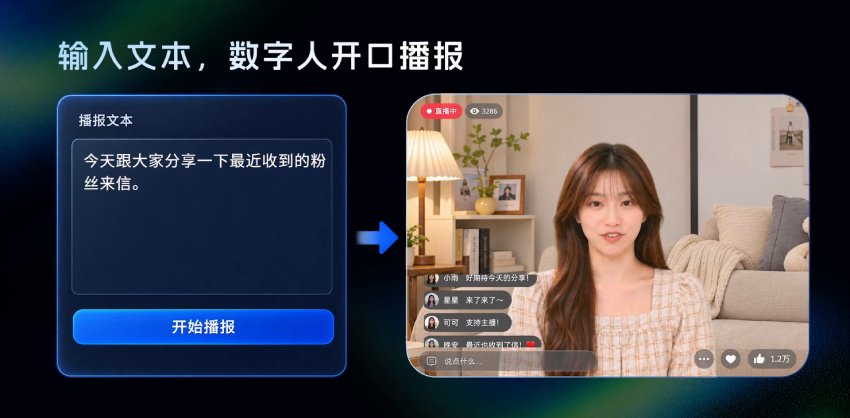
即构科技升级数字人直播能力:支持文本驱动播报,并借助大模型实时改稿回应弹幕评论,形成互动闭环;新增透明背景叠加,数字人可直接嵌入现有直播间或网页,降低搭建成本;直播流可转推抖音、快手、YouTube、TikTok等国内外平台,适配电商、社交、教育场景,缓解真人主播难以长期稳定出镜的问题。
SakanaAI推出的Text-to-LoRA(T2L)技术简化了大模型的微调流程,用户只需一句话即可生成LoRA,压缩率达到80%,准确率仅下降1.2%。该技术使非技术用户能够轻松适配模型,推动“文本驱动”时代的到来。
本研究提出了MuseFace框架,解决了文本驱动面部编辑在多样性和可控性方面的不足。通过生成语义掩码,结合扩散模型和语义编辑模型,显著提高了编辑的精度和控制能力,实验结果表明其具有高保真性和广泛的应用潜力。
本研究提出了一种骨架感知潜在扩散模型(SALAD),旨在解决文本驱动运动生成中关节、时间帧和文本表示的简化问题,从而显著提高文本与运动的对齐能力。
本文提出的ControlVideo模型实现了文本驱动的视频编辑,确保内容的忠实性和时间的一致性。通过引入条件控制信息和改进注意力机制,ControlVideo能够处理140帧视频,显著提升编辑效果和一致性,优于现有方法。
本研究提出了一种文本驱动的立体视频生成系统(T-SVG),旨在简化立体视频创作流程。该系统通过文本提示生成参考视频,并将其转换为自然立体效果的3D点云序列,推动多媒体领域的发展。
本文介绍了Gen-L-Video方法,扩展了文本驱动的视频生成和编辑能力,支持生成数百帧长的视频。同时提到MovieFactory框架和VBench系统,提供视频生成评估基准。研究了人体视频生成的最新进展与挑战,提出了高效的视频生成方法,优化了计算成本,推动了文本到视频合成技术的发展。
本研究提出了一种改进的概念增强视频编辑方法,解决了文本驱动视频编辑中的细致编辑困难。该方法通过生成多样且稳定的目标视频,显著提升了视频的稳定性和真实性,超越了现有技术。
本研究提出了多种视频生成模型,优化了时序一致性和长视频生成能力。新方法如Gen-L-Video和LaVie,利用文本驱动生成高质量长视频,表现优异。同时介绍了OpenVid-1M数据集和Loong模型,解决了生成长视频的挑战,展现出显著的创新性和实用潜力。
本文介绍了一种基于扩散模型的文本驱动运动生成框架MotionDiffuse,能够生成复杂的人类运动。该模型通过优先级中心的运动分散扩散模型(M2DM)和细粒度控制方法,在多个数据集上表现优越,尤其在处理复杂文本描述时。此外,研究提出了基于马尔可夫决策过程的算法InstructMotion,优化了文本与动作的对齐,提升了生成效果。
本研究提出了MoRAG,一种基于多部分融合的检索增强生成策略,用于解决文本驱动的人类运动生成中的拼写错误和改写问题。该方法通过改进的运动检索过程,增强了运动扩散模型的表现,展示了其在运动生成领域的潜力。
本研究提出了基于扩散模型的动作生成框架ReMoDiffuse,通过结合检索机制改善去噪过程,提升文本驱动动作生成的多样性。相关模型如MoDiff、MotionDiffuse和CrossDiff在运动合成和预测方面表现优异,能够生成复杂的人类运动,适应实时命令,展现出强大的鲁棒性和生成质量。
本文介绍了一种新方法,通过将2D扩散模型转化为3D场景表示,实现多视图图像的3D区域修补。该方法结合文本驱动技术,生成高质量3D内容,改善视觉效果和一致性。同时,提出基于文本的图像修复技术,确保主题复制和细节控制。研究展示了利用扩散模型进行动态3D场景生成,显著提升图像质量和一致性。
ControlVideo 是一种基于文本的扩散模型,能够快速生成高质量视频。MAGE 视频生成器通过运动锚结构提升了可控性和多样性。AVID 方法解决了文本引导视频修复中的时间一致性问题,能够生成任意长度的视频。此外,研究还提出了自动视频修复算法,显著提升了处理动态纹理和移动对象的速度。这些技术推动了文本到视频生成和视频修复的进展。
该文综述文本驱动人体动作生成与识别研究,涵盖压力图生成、运动合成、压力仿真、VQ-VAE与GPT运动生成、无监督扩散、可穿戴IMU动作重建及视频生成等方法,验证了文本监督与多模态融合的有效性。
本文综述了NeRF三维场景编辑的多项进展,包括基于潜变扩散模型的快速编辑、统一场景分解与合成框架、网格可控形状变形、深度条件快速编辑、文本驱动编辑、点或文本提示对象移除、10-30倍加速且视角一致的方法,以及局部感知可编辑三维合成。
本研究提出了一种基于级联扩散的生成框架,用于文本驱动的人体动作合成。该框架利用了一种名为GUESS的策略,将人体姿态逐步抽象为多个粒度级别上的更粗糙的骨架,从而改善了跨模态动作合成任务。实验证明,GUESS优于现有方法。
该文综述文本驱动的3D人物头像生成研究,涵盖Text2Human(分层纹理码书与扩散变换器生成多样人像)、AvatarStudio(结合NeRF与SMPL生成可动画头像)、DreamHuman(融合文本到图像模型、NeRF与人体模型)、DreamAvatar(双空间设计与法线正则提升几何纹理),以及AvatarBooth、GETAvatar等实现个性化、可动画高质量头像的方法。
StableVideo是一种文本驱动视频编辑框架,通过引入时态依赖于现有的文本驱动扩散模型,解决了扩散模型在自然视频编辑中编辑现有对象时难以保持其外观随时间稳定的问题。该框架利用分层表示的概念将相邻帧的外观信息传播到下一帧,实现了一致感知的视频编辑。实验证明该方法具有强大的编辑能力,展示了卓越的定性和定量结果。
该研究提出了一种新的文本驱动的整体运动生成任务,使用HumanTOMATO文本对齐全身运动生成框架解决了以往的限制,并在实验证明中表现出显著优势。
完成下面两步后,将自动完成登录并继续当前操作。