小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
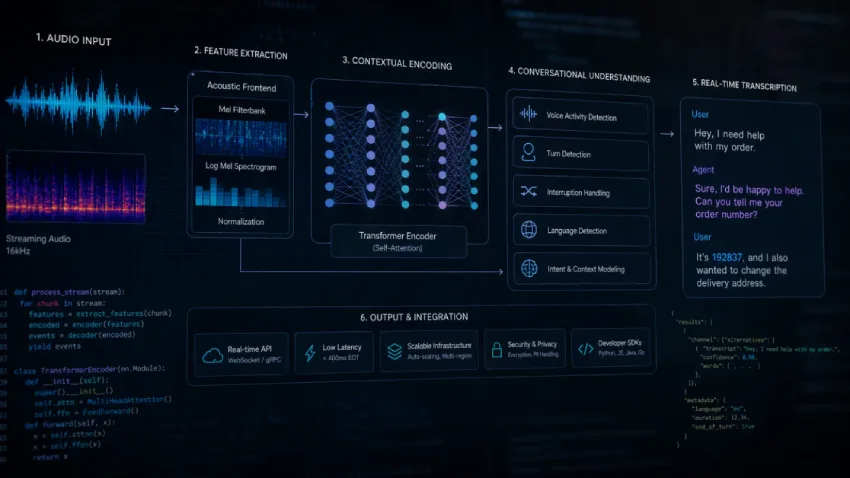
超越转录:对话式语音识别 (CSR) 如何教会 AI 真正倾听

对话式语音识别(CSR)正取代传统自动语音识别,通过理解对话的实时展开、轮流发言和时机,实现低延迟响应。它支持多语言切换,已在客服、医疗、金融等领域应用,推动人机交互更自然、更人性化,成为下一代语音AI的基础。

超越转录:对话式语音识别 (CSR) 如何教会 AI 真正倾听

实时互动网 实时互动网 · 2026-08-04T02:28:15Z
重新审视自动语音识别中的错误修正与专用模型

本文探讨了自动语音识别(ASR)中的错误修正,提出使用紧凑的seq2seq模型来处理ASR错误。通过合成语料库训练,该模型在LibriSpeech测试中表现优异,参数量仅为大型语言模型的15分之一,并在低错误率情况下提供准确修正。

重新审视自动语音识别中的错误修正与专用模型

Apple Machine Learning Research Apple Machine Learning Research · 2026-07-06T00:00:00Z
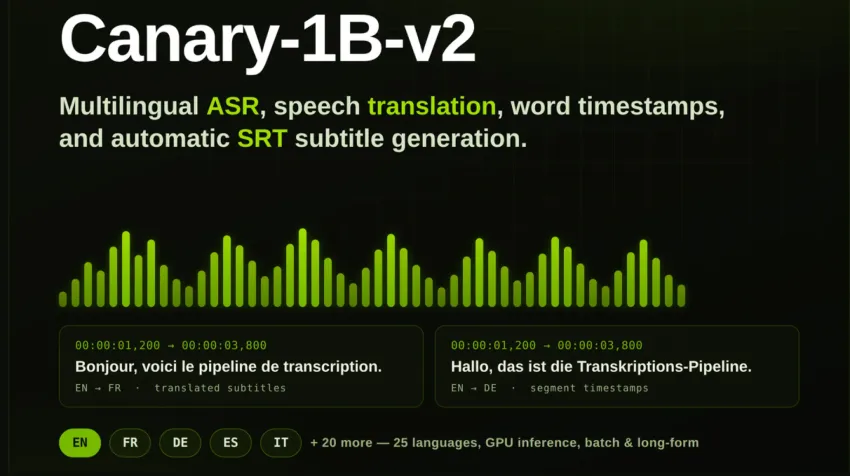
如何使用 NVIDIA Canary-1B-v2 在 Python 中实现 ASR、翻译和自动 SRT 字幕导出

本文介绍了如何使用NVIDIA Canary-1B-v2构建多语言自动语音识别(ASR)和翻译工作流程,包括安装依赖项、加载模型、处理音频、执行英语转录和多语言翻译、生成时间戳及导出SRT字幕,最后测试长文本转录和批量处理以评估模型性能。

如何使用 NVIDIA Canary-1B-v2 在 Python 中实现 ASR、翻译和自动 SRT 字幕导出

实时互动网 实时互动网 · 2026-06-24T02:20:25Z
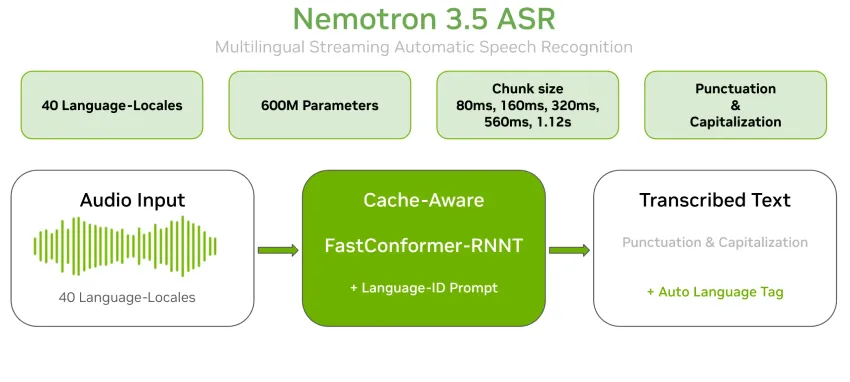
NVIDIA 发布 Nemotron 3.5 ASR:一个拥有 6 亿参数、支持缓存的流式转录模型,可实时转录 40 种语言区域设置

NVIDIA发布了Nemotron 3.5 ASR,这是一个支持40种语言的流式自动语音识别模型,拥有6亿参数。该模型采用FastConformer-RNNT架构,实时转录时无需单独处理标点和大小写,推理延迟可调,适合多种应用场景。经过微调,希腊语和保加利亚语的识别准确率显著提高。

NVIDIA 发布 Nemotron 3.5 ASR:一个拥有 6 亿参数、支持缓存的流式转录模型,可实时转录 40 种语言区域设置

实时互动网 实时互动网 · 2026-06-08T02:31:38Z
云语音AI :为什么你的网络即将成为你最智能的业务资产

语音AI技术正在迅速改变商业通信,超越传统电话功能,成为决策工具。现代语音AI利用自然语言处理和自动语音识别,提升客户体验,企业可自动处理大部分咨询。企业应尽早部署语音AI,以建立竞争优势。

云语音AI :为什么你的网络即将成为你最智能的业务资产

实时互动网 实时互动网 · 2026-04-13T03:04:34Z
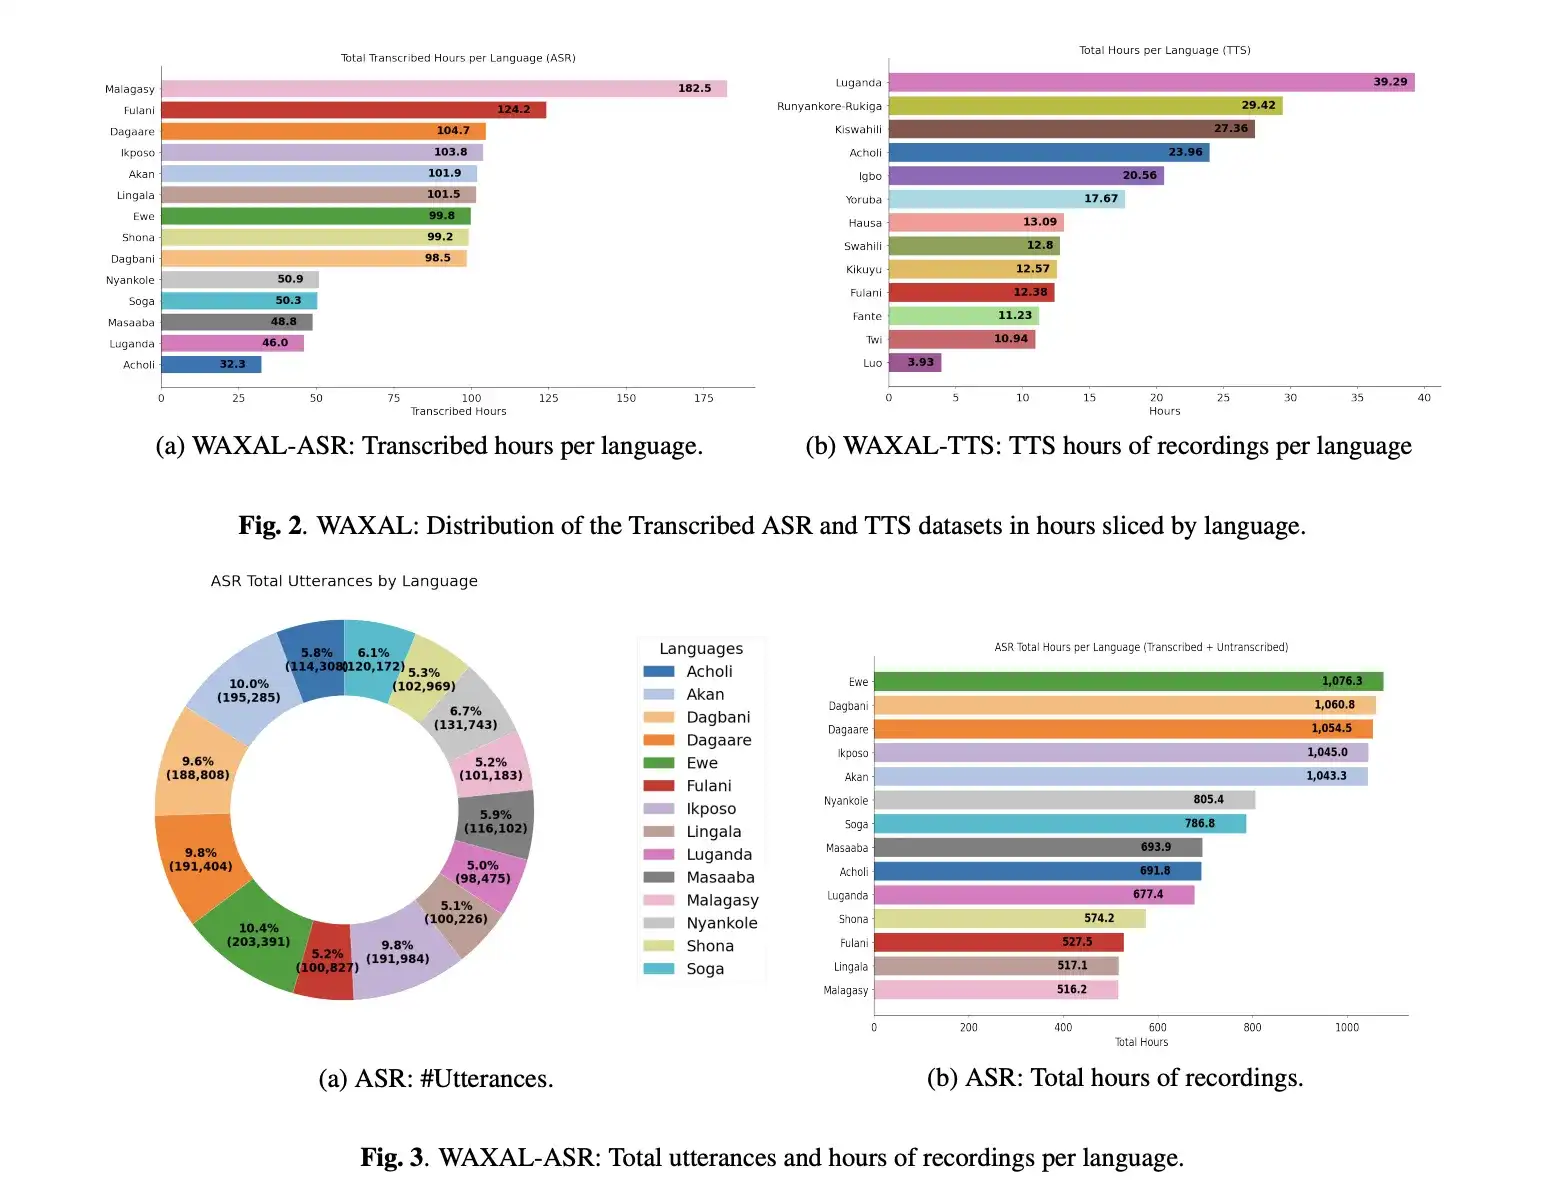
Google AI 发布 WAXAL:用于训练自动语音识别和文本转语音模型的多语言非洲语音数据集

WAXAL是一个开放的多语言语音数据集,涵盖24种非洲语言,专为自动语音识别(ASR)和文本转语音(TTS)设计。ASR部分通过图像提示自然采集语音,TTS部分在录音棚中高质量录制,确保语音一致性。

Google AI 发布 WAXAL:用于训练自动语音识别和文本转语音模型的多语言非洲语音数据集

实时互动网 实时互动网 · 2026-03-19T02:10:27Z
lyrichroma-一键将语音转换为视频的Python命令行工具

lyrichroma是一个Python命令行工具,能够将音频转换为视频,支持动态背景和字幕编辑。它利用自动语音识别技术,允许用户自定义字幕样式和背景,适合需要高质量字幕的场景。用户可以通过简单命令生成视频,并手动校正识别错误。

lyrichroma-一键将语音转换为视频的Python命令行工具

Yunfeng's Simple Blog Yunfeng's Simple Blog · 2025-12-20T08:56:43Z
KrillinAI - 一款结合大型语言模型、自动语音识别和文本转语音的支持100种语言的视频翻译与配音工具

KrillinAI是一款支持100种语言双向翻译和自然配音的视频翻译工具,集成自动语音识别和文本转语音技术,适用于YouTube和TikTok等平台,帮助内容创作者快速本地化视频。

KrillinAI - 一款结合大型语言模型、自动语音识别和文本转语音的支持100种语言的视频翻译与配音工具

云原生 云原生 · 2025-12-05T11:52:10Z
为语音识别启用差分隐私的联邦学习:基准测试、自适应优化器与梯度裁剪

联邦学习(FL)与差分隐私(DP)在自动语音识别(ASR)中的应用尚待深入。本文通过逐层裁剪和梯度归一化技术,缓解了大模型在FL中面临的梯度异质性问题。实验结果表明,在强隐私保护下,FL与DP在用户规模达到数百万时是可行的,并且在不同规模下的字错误率有所改善。这为大模型的隐私保护FL算法设计提供了指导。

为语音识别启用差分隐私的联邦学习:基准测试、自适应优化器与梯度裁剪

Apple Machine Learning Research Apple Machine Learning Research · 2025-09-29T00:00:00Z
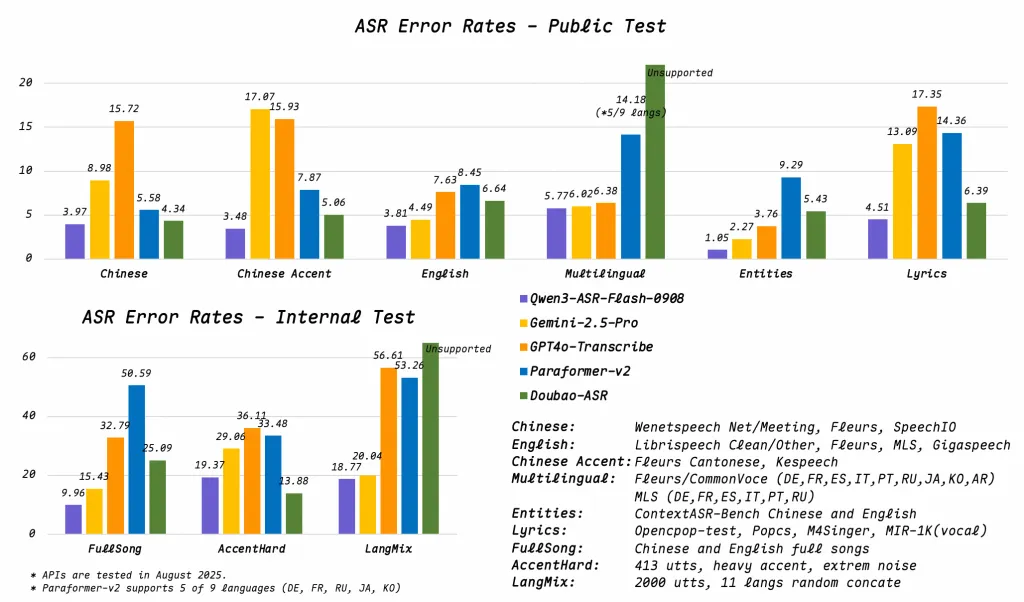
Qwen3-ASR:阿里基于 Qwen3-Omni 构建的全新语音识别模型,实现更强大的语音识别性能

阿里云推出Qwen3-ASR Flash,一体化自动语音识别模型,支持11种语言的自动识别与转录,具备上下文注入和强大的音频处理能力,适用于教育、媒体和客户服务等领域,词错误率低于8%,易于部署。

Qwen3-ASR:阿里基于 Qwen3-Omni 构建的全新语音识别模型,实现更强大的语音识别性能

实时互动网 实时互动网 · 2025-09-11T02:30:25Z
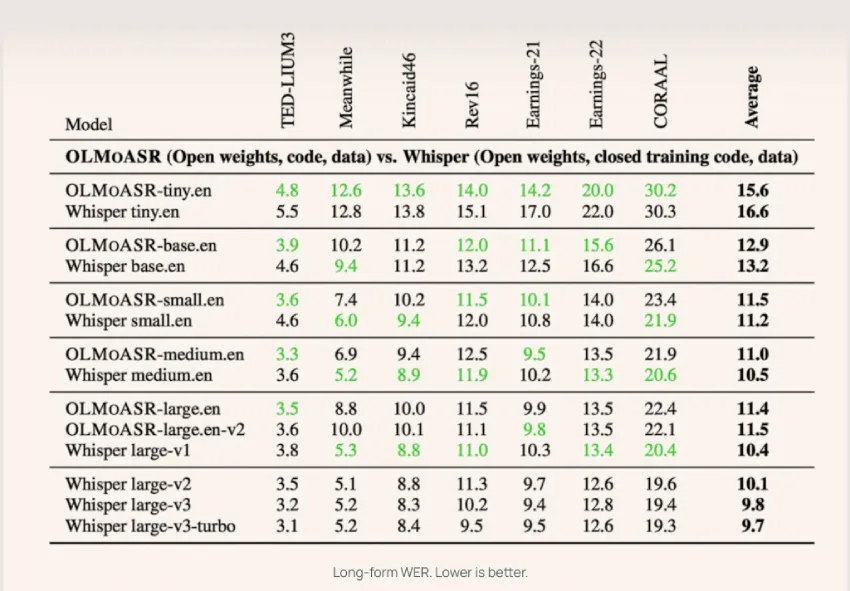
OLMoASR 是什么?它与 OpenAI 的语音识别 Whisper 相比如何?

艾伦人工智能研究所发布了OLMoASR,这是一套开放的自动语音识别模型,采用transformer架构,支持多种尺寸,适用于不同应用场景。其开放性促进了语音识别研究的可重复性和科学进步,为开发者提供灵活选择和领域适应的可能性。

OLMoASR 是什么?它与 OpenAI 的语音识别 Whisper 相比如何?

实时互动网 实时互动网 · 2025-09-05T02:43:58Z
音调重音检测提升了预训练自动语音识别的性能

本文介绍了一种联合自动语音识别(ASR)和音调重音检测模型,显著提升了ASR系统的性能。音调重音检测模块使F1-score提高41%,并在LibriSpeech数据集上将错误率降低28.3%。研究强调了扩展预训练语音模型以保留重要韵律线索的必要性。

音调重音检测提升了预训练自动语音识别的性能

Apple Machine Learning Research Apple Machine Learning Research · 2025-08-15T00:00:00Z
2025年国际语音通信会议语音可及性项目挑战

自动语音识别(ASR)系统在过去十年取得了显著进展,但对有语言障碍个体的表现仍然不足。为了解决这一问题,2025年启动了语音可及性项目挑战,利用超过400小时的来自500多名有语言障碍个体的数据。挑战评估结果显示,12支队伍在字错误率(WER)上超越基线,17支队伍在语义评分(SemScore)上表现优异,最高队伍的WER为8.11%,SemScore为88.44%。

2025年国际语音通信会议语音可及性项目挑战

Apple Machine Learning Research Apple Machine Learning Research · 2025-08-08T00:00:00Z
DiceHuBERT:基于自监督学习目标的HuBERT知识蒸馏

本文介绍了DiceHuBERT,一种用于压缩HuBERT的知识蒸馏框架。与传统方法不同,DiceHuBERT通过直接替换原始模型为学生模型,利用HuBERT的自蒸馏机制进行训练。实验结果显示,DiceHuBERT在音素识别和自动语音识别(ASR)性能上显著优于现有方法,提升超过21%和14%。

DiceHuBERT:基于自监督学习目标的HuBERT知识蒸馏

Apple Machine Learning Research Apple Machine Learning Research · 2025-08-08T00:00:00Z
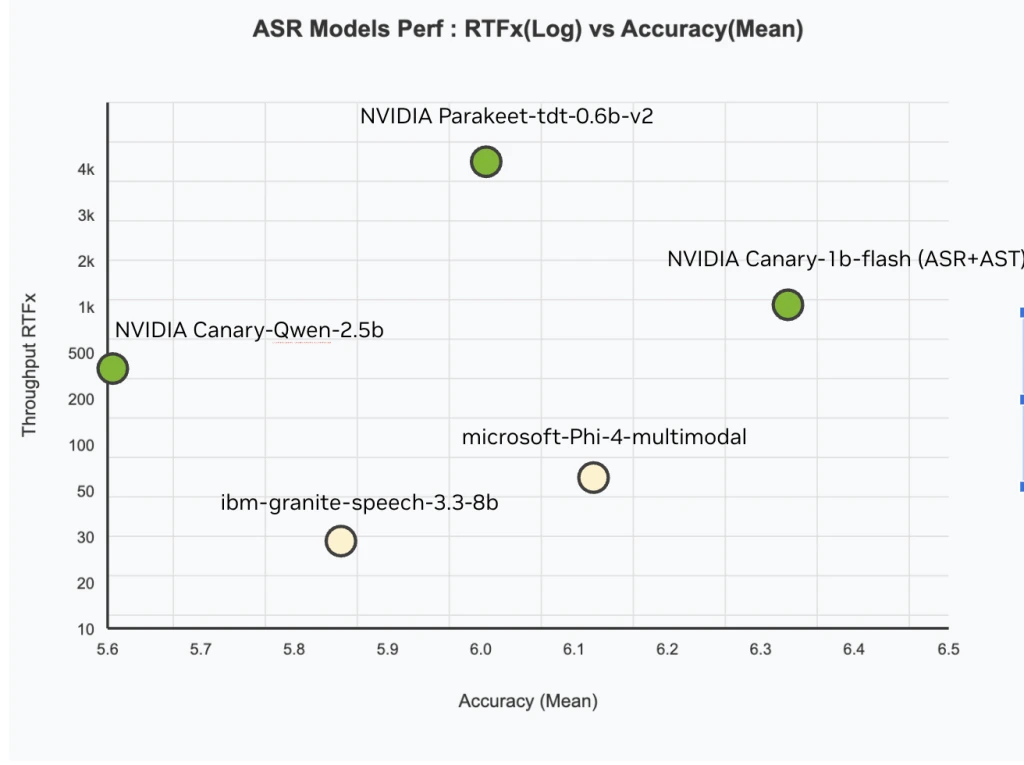
NVIDIA AI 发布 Canary-Qwen-2.5B:一款先进的 ASR-LLM 混合模型,在 OpenASR 排行榜上拥有 SoTA 性能

NVIDIA发布了Canary-Qwen-2.5B模型,词错率为5.63%,在Hugging Face OpenASR中排名第一。该模型结合了自动语音识别和语言模型,支持音频摘要和问答,适用于多个行业,具有商业和开源特性。

NVIDIA AI 发布 Canary-Qwen-2.5B:一款先进的 ASR-LLM 混合模型,在 OpenASR 排行榜上拥有 SoTA 性能

实时互动网 实时互动网 · 2025-07-18T02:25:48Z
通过提示Whisper提高逐字转录和端到端错误检测的准确性

本文探讨了一种新方法来识别阅读错误,提出了结合目标阅读文本的端到端架构,以提高自动语音识别(ASR)的准确性和错误检测能力。研究表明,整合阅读文本的提示可以改善逐字转录性能,尤其在儿童朗读和成人非典型言语的案例中,效果优于现有技术。此外,播客转录的可读性和准确性对听障人士至关重要。

通过提示Whisper提高逐字转录和端到端错误检测的准确性

Apple Machine Learning Research Apple Machine Learning Research · 2025-06-03T00:00:00Z

本研究提出了一种基于最佳运输的图匹配方法(GM-OT),旨在解决从预训练语言模型向声学特征学习转移语言知识时的对齐挑战。该方法通过将语言和声学序列建模为结构化图,提升了知识迁移效率,显著提高了自动语音识别模型的性能。

Cross-modal Knowledge Transfer Learning for Automatic Speech Recognition Based on Optimal Transport Graph Matching

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-19T00:00:00Z

本研究提出了一种创新方法,利用大型语言模型提升国际口语翻译研讨会(IWSLT)中的语音翻译与指令跟随任务的性能。通过融合多个自动语音识别系统的输出,采用两步翻译和文档级精炼,显著提高了翻译质量。

KIT's Offline Speech Translation and Instruction Following Submission: IWSLT 2025

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-19T00:00:00Z

本研究建立了一个包含18.9小时潮州方言的语音语料库,提供了精准标注,促进了自动语音识别与合成的应用。

潮州-野生:首个带有拼音标注的潮州方言语料库

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-08T00:00:00Z
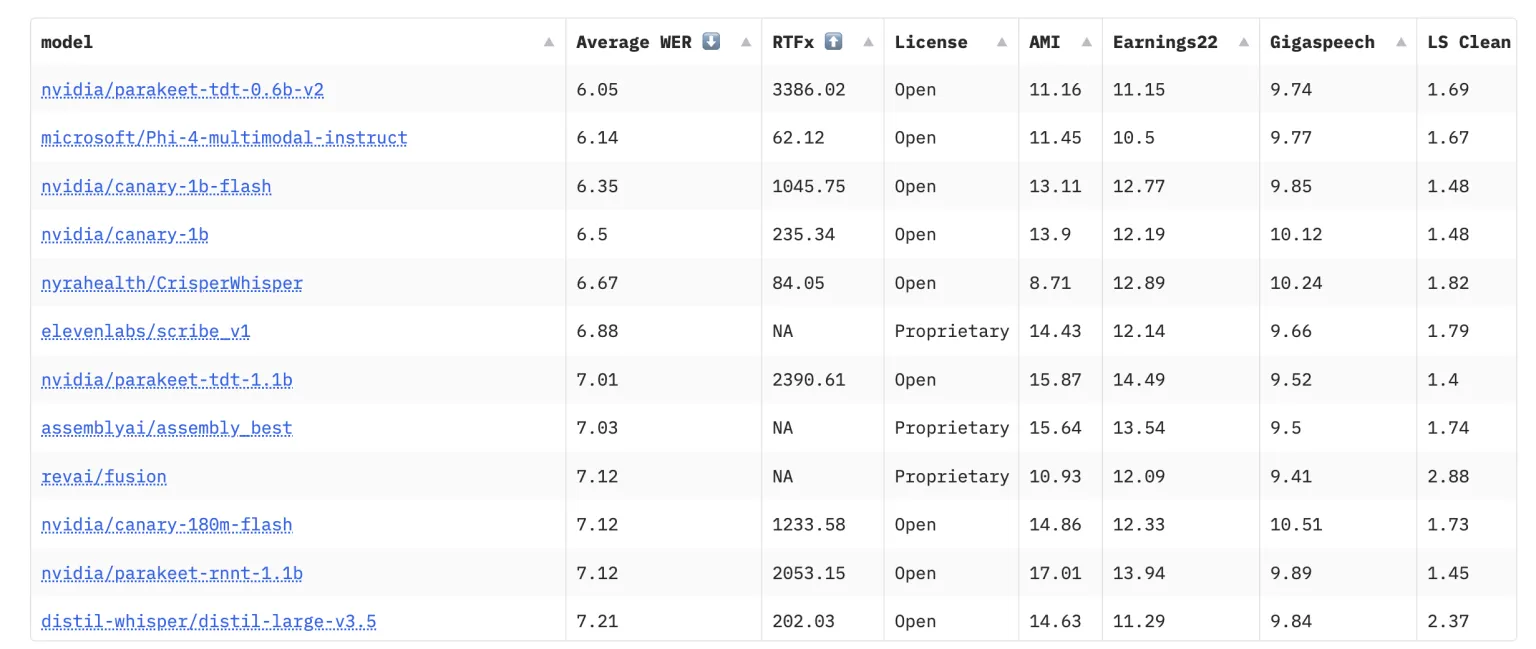
NVIDIA 开源 Parakeet TDT 0.6B:打造自动语音识别 ASR 全新标准,一秒转录一小时音频

NVIDIA 发布了 Parakeet TDT 0.6B,这是一款开源的自动语音识别模型,拥有6亿参数和3386倍实时因子,具备快速转录和高准确率,支持歌曲转录、时间戳和标点恢复,适合企业级应用,推动语音AI发展。

NVIDIA 开源 Parakeet TDT 0.6B:打造自动语音识别 ASR 全新标准,一秒转录一小时音频

实时互动网 实时互动网 · 2025-05-06T08:34:13Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。
1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码