Mistral AI发布Voxtral 3语音模型家族及配套SDK,包括3个转写模型、1个TTS模型和基于LiveKit的语音智能体SDK,均已在Mistral API公开预览。Small Transcribe 3的AA-WER为2.1%,排名第三,说话人分离表现最佳,但实时模式精度落后于Gemini 3.5 Realtime。批处理转写每分钟0.0035至0.004美元,TTS每百万字符13美元,未宣布开源权重。
Druid AI推出语音、代理互操作、治理与评估新功能,帮助企业将AI代理从实验推向受监管生产流程。新功能包括行业定制语音模型、Druid MCP跨平台编排、Druid Conductor行业代理协调,以及含26项可衡量组件的AI代理参考模型,强调以业务成果而非活动量衡量成功。
阿里发布Qwen-Audio-3.1系列五款语音模型,覆盖识别、合成、实时交互与音频创作,全线降价:TTS降约70%、Realtime降约85%、ASR降95%。ASR支持30种语言和16种中文方言,新增润色与分角色转写;ASR-Next可理解情绪与环境声;TTS支持跨语言音色合成;TTS-Next统一生成人声、音效与环境声;Realtime实现全双工交互并可调用工具。
谷歌AI网关上线Gemini 3.8 Flash-Lite TTS与Flash TTS两款语音模型,支持超100种语言、长文本朗读、语气节奏控制及双人对话。Lite版适合大批量语音生成,Flash版可通过自然语言提示设计音色与角色,支持口音和表演提示。开发者可用统一API调用并追踪用量成本。
2026年9月15日,Google发布Gemini 3.8 Live与Extended Thinking两款语音模型,分别主打低成本对话与多步推理。后者语音质量指数82.6分居首,但真实客服任务完成率仅68.6%,银行场景更低至35.1%,暴露语音智能体在工具调用、多语言识别与治理上的共同瓶颈。
谷歌发布Gemini 3.8 Live与3.8 Live Extended Thinking两款语音模型。前者主打规模化与低成本,支持近实时视觉输入、97种语言切换及后台工具调用;后者面向复杂任务,可边推理边说话,在语音质量与智能体任务评测中领先。模型已通过API、AI Studio及Search Live等渠道推出,音频均带SynthID水印。
OpenAI在API推出GPT-Live-1语音模型,支持同时听说,简化语音代理架构并降低延迟。该模型具备打断处理、推理与工具调用委托、语气节奏定制、静音与背景噪音管理、长会话可靠性及电话支持。全双工基准性能提升30个百分点,客户反馈代码减少80%,定价为每分钟0.05美元。
Wispr AI完成2.8亿美元B轮融资,估值达20亿美元,并推出自研语音模型Canto。该模型能在嘈杂环境中识别语音,将错误率从30%降至5-10%。其产品Flow已处理超600亿字,被财富500强企业广泛使用,惠及商务人士及听障群体。
NVIDIA发布开源11B端到端语音模型NemotronLabs VoiceChat 11B,支持实时全双工对话,延迟仅448毫秒,可插话和调用工具。需80GB GPU,仅供研究,未用于生产。在基准测试中表现优异,但存在音频时长限制和语音降级等问题。
xAI推出Grok Voice Think Fast 2.0语音模型,支持语音输入输出,推理与说话并行,减少延迟,提升转录准确性和对话能力。通过AI Gateway实时API使用,需在服务器端生成短期令牌以保护API密钥,并可在playground试用。
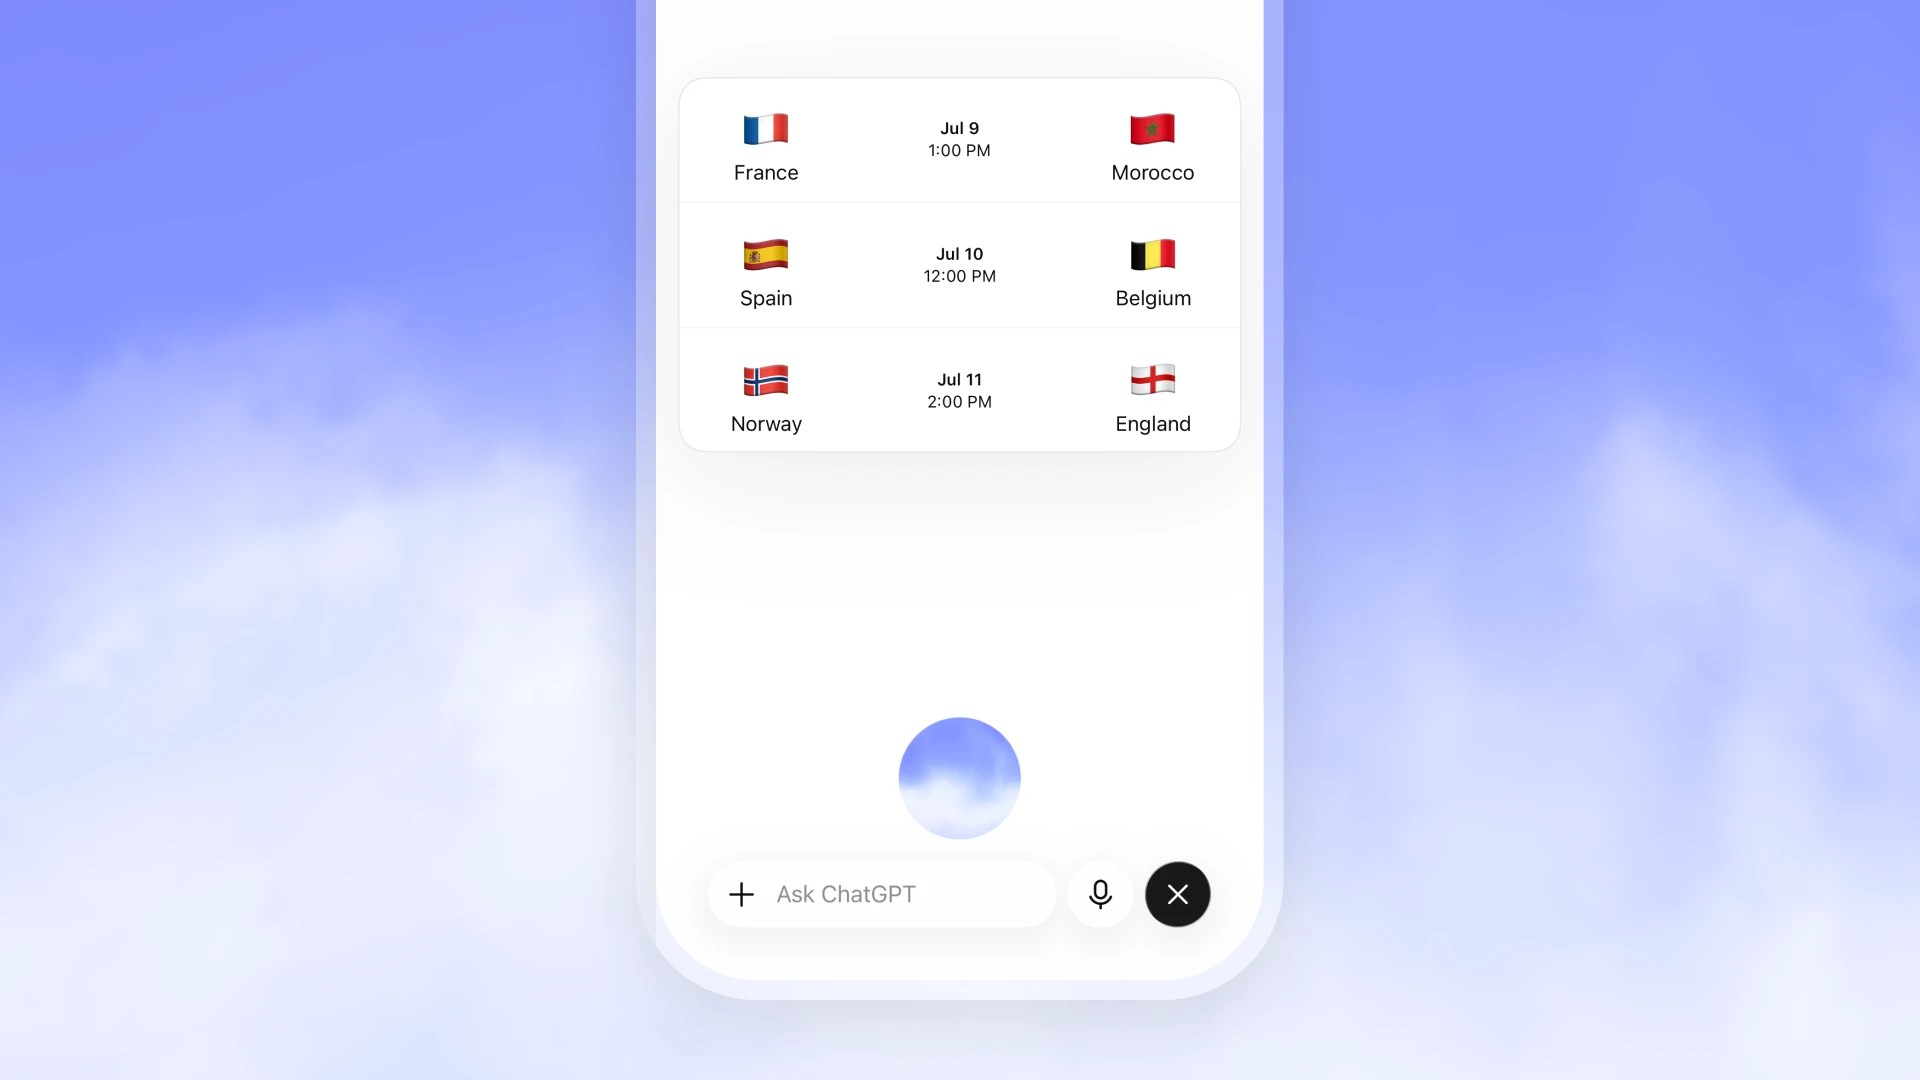
OpenAI推出了新的GPT-Live-1语音模型,能够实时说话和倾听,减少打断。该模型支持实时翻译和AI生成的视觉信息,具备内置安全措施,确保适龄回答。GPT-Live-1将在iOS、Android和网页上推出,Go、Plus和Pro用户将使用此模型,免费用户则使用更小的GPT-Live-1迷你版。
GPT‑Live是新一代语音模型,支持双向交流,使与AI的对话更自然。它使用GPT‑5.5进行复杂任务处理,提供更智能的回答,并推出了两种版本,以提升人机互动体验和安全性。
OpenAI推出了三种新的语音模型:GPT-Realtime-2、GPT-Realtime-Translate和GPT-Realtime-Whisper。GPT-Realtime-2性能提升11%,支持更复杂的交互;GPT-Realtime-Translate专注于实时翻译,支持70种输入语言和13种输出语言;GPT-Realtime-Whisper是最新的流媒体转录模型,适用于多种语音AI应用场景,定价合理。
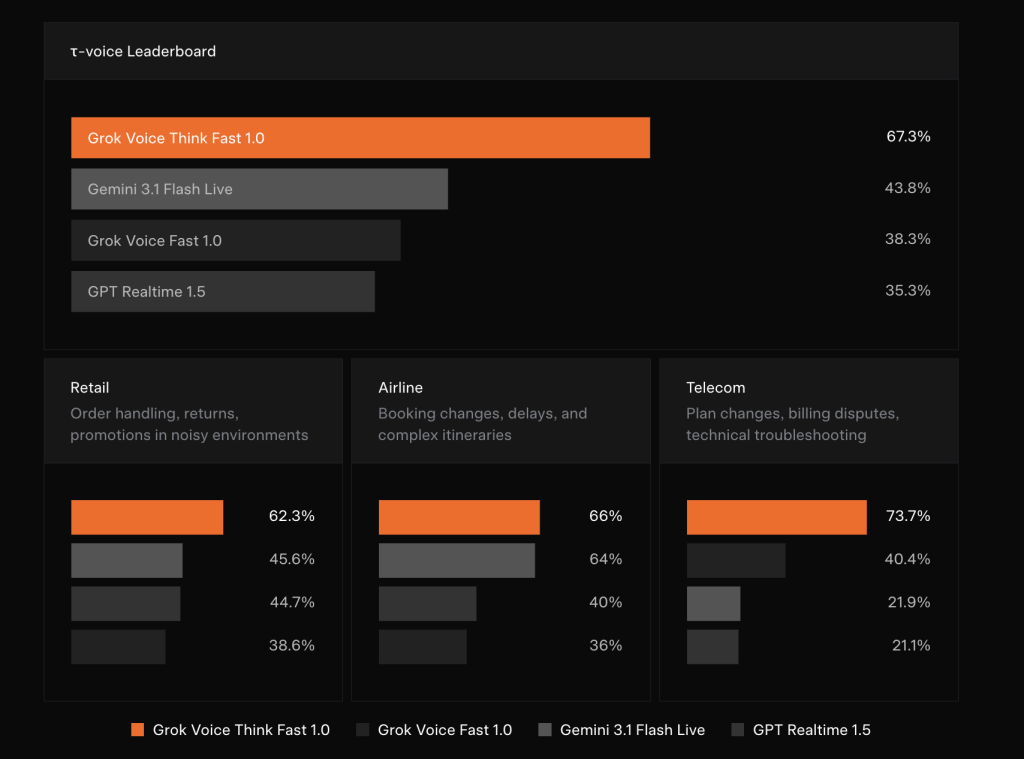
xAI的新语音模型grok-voice-think-fast-1.0在τ-voice基准测试中以67.3%的得分领先,支持实时推理,能够无延迟处理复杂对话中的语音输入,准确捕获结构化数据。该模型已成功应用于Starlink的客户支持,展现出高效的销售转化率和自动解决客户咨询的能力。
国产开源语音模型VoxCPM 2成功复刻郭德纲的《莽撞人》,展现高保真、多方言和多语种能力,音质达到CD级别,适用于游戏和影视等领域,吸引了众多用户体验。
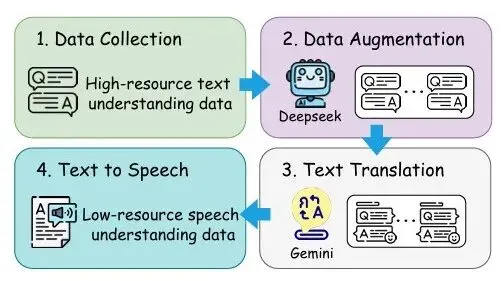
本文提出了一种针对低资源语言(如泰语)的语音大语言模型(SLLM)多任务理解方案,核心创新包括自监督学习的语音编码器XLSR-Thai、通用语音-文本对齐方法U-Align,以及泰语口语理解数据生成流水线Thai-SUP。实验结果表明,该方案有效提升了泰语的自动语音识别和多任务理解能力,为低资源语言的SLLMs构建提供了新路径。
本文提出了一种统一的分类法,用于评估语音模型,解决不同模型在语音处理中的评估需求。该分类法定义了三个维度:评估方面、模型能力和任务要求。通过将现有评估与模型能力和方法论需求相匹配,提供了选择和解释语音模型评估的框架,并揭示了未来基准设计的优先领域。
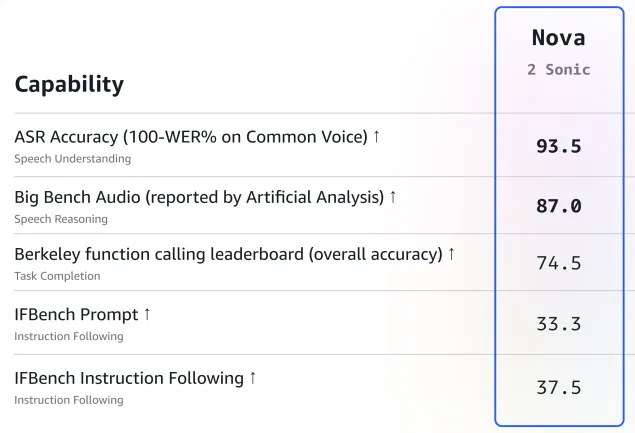
亚马逊云科技推出的Amazon Nova 2 Sonic语音模型提升了语音交互的流畅性与智能性,支持多语言切换,优化了语音识别和对话机制,增强了多任务处理能力,适用于多种应用场景。
美团LongCat团队开源了LongCat-Audio-Codec,解决了语音大语言模型在Token化中的难题。该方案通过双Token并行提取、低延迟解码和超低比特率高保真设计,实现了高效音频处理,提升了语音理解与生成质量,降低了技术门槛,丰富了应用场景,推动了语音智能系统的发展。
豆包大模型推出四档思考长度调节功能,提高AI使用效率并降低企业成本。同时,新语音模型能准确朗读复杂公式,增强语音交互能力。火山引擎发布智能模型路由,自动选择最优模型以满足不同需求,推动AI行业发展。
完成下面两步后,将自动完成登录并继续当前操作。