小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
当多模态开始卷落地:MiniCPM-o-4.5仅9B覆盖实时图像理解与文本生成;vLLM Omni 同时支持文本与多模态模型的高吞吐部署与服务化

OpenBMB推出的MiniCPM-o-4.5模型仅用9B参数实现全模态能力,强调跨模态对齐与推理效率,适合主流GPU部署,具备高性能与轻量化优势。

当多模态开始卷落地:MiniCPM-o-4.5仅9B覆盖实时图像理解与文本生成;vLLM Omni 同时支持文本与多模态模型的高吞吐部署与服务化

HyperAI超神经 HyperAI超神经 · 2026-02-28T06:48:25Z
我们在ICLR 2025上学到了什么

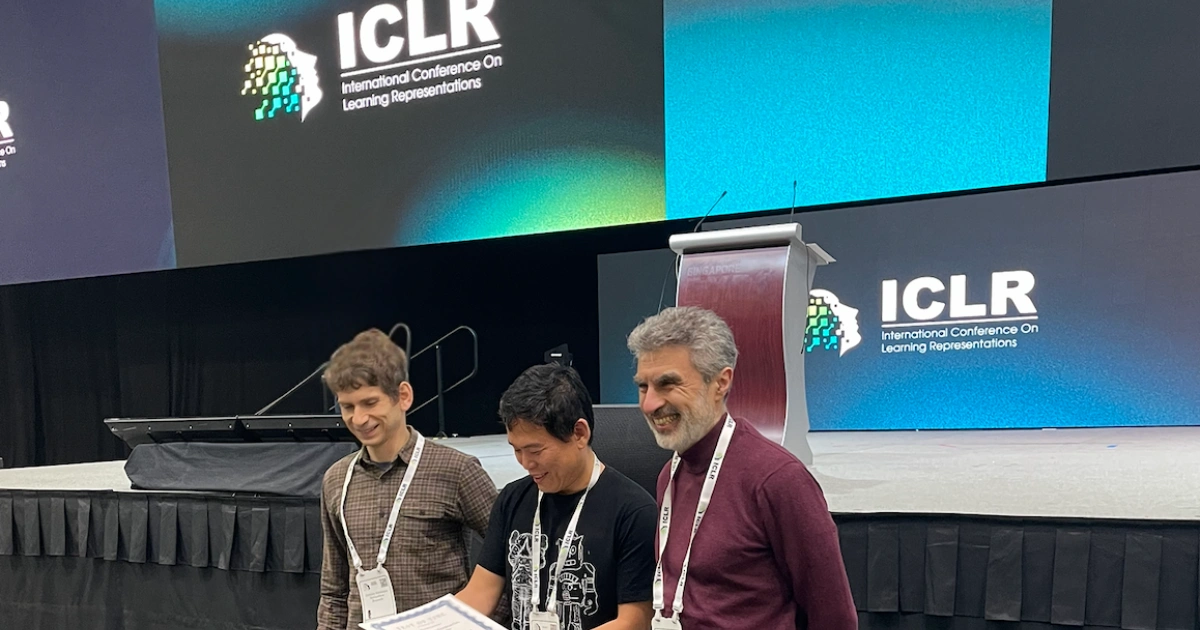
ICLR 2025将在新加坡举行,这是该会议首次在亚洲举办,吸引了大量中国参与者。会议展示了多项研究成果,包括小型高效模型的优势。研究如AlignCLIP改善了跨模态对齐,jina-clip-v2支持多语言任务,ReaderLM-v2高效提取网页内容。此外,新方法FlexPrefill和TAID提升了长序列推理和知识蒸馏的效率,推动了AI技术的发展。

我们在ICLR 2025上学到了什么

Jina AI Jina AI · 2025-05-25T22:06:37Z

本研究提出了一种新的跨模态对齐方法——结构引导跨模态对齐(SGCMA),旨在提升大型语言模型在时间序列预测中的应用。该方法通过学习状态转移图结构和语义对齐,显著提高了预测性能和泛化能力。

Enhancing the Application of Large Language Models in Time Series Forecasting via Structure-Guided Cross-Modal Alignment

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-19T00:00:00Z

本研究提出了一种对比式一阶段变换器融合框架(COST),有效解决视觉-语言追踪算法中的分布偏差问题,提升了跨模态对齐和特征表示的一致性。实验结果表明,COST在多个数据集上表现优异。

Application of Contrastive One-Stage Transformer in Visual-Language Small Object Tracking

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-02T00:00:00Z

本研究提出了一种新策略,通过多模态微调方法显著改善OOD检测性能,关键在于正则化图像与文本嵌入间的距离,增强跨模态对齐。实验结果表明,该方法在ImageNet-1k OOD基准数据集上优于现有技术,达到最先进的检测表现。

Enhanced Out-of-Distribution Detection through Cross-Modal Alignment of Multi-Modal Representations

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-24T00:00:00Z

本研究提出了一种双阶段跨模态对齐框架,用于情感模仿强度(EMI)估计。通过改进的CLIP架构和时间感知动态融合模块,显著提高了特征对齐精度和抗噪声能力,实验结果表明该方法在情感维度上优于最佳基线40%。

Dual-Stage Cross-Modal Network with Dynamic Feature Fusion for Emotional Mimicry Intensity Estimation

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-13T00:00:00Z

本研究提出CGP-Tuning,一种结构感知软提示调优方法,旨在提高代码漏洞检测效果。该方法通过类型感知嵌入捕捉代码图的语义信息,并设计跨模态对齐模块,使得在DiverseVul数据集上的准确率提高3.5个百分点,同时保持对长源代码的检测能力。

CGP Tuning: Structure-Aware Soft Prompt Tuning for Code Vulnerability Detection

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-08T00:00:00Z

本研究提出了一种高效的跨模态对齐框架,解决了边缘设备上自动语音识别与大型语言模型个性化训练不足的问题,提升了训练速度和对齐质量。

微调:在边缘设备上连接自动语音识别和大型语言模型

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-11-21T00:00:00Z

本研究提出了一种视频检索增强生成(Video-RAG)的方法,旨在解决大型视频语言模型在长视频理解中的局限性。通过视觉对齐的辅助文本,Video-RAG显著提升了跨模态对齐效果,减少了对高质量数据和GPU资源的依赖,并在多个基准测试中表现优异。

Video Retrieval-Augmented Generation: Visually-Aligned Long Video Comprehension

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-11-20T00:00:00Z

本研究分析了大型语言和视觉模型在基础感知任务中的不足,尽管在高级推理任务中表现良好。通过评估多个模型家族,揭示其内部处理机制、数学推理能力及跨模态对齐问题,并提出改进建议和未来评估基准的发展方向。

大型语言与视觉模型的有趣特性

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-10-07T00:00:00Z

本文探讨了多模态表示学习的进展,提出了多种算法和模型以实现跨模态的有效对齐和泛化。研究表明,利用大规模数据训练可以有效进行知识转移,提升文本、图像和音频等任务的表现。新方法如LanguageBind和ModaVerse显著提高了多模态理解和生成的效率,推动了相关领域的发展。

OneEncoder:一种轻量级的逐步对齐多模态框架

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-09-17T00:00:00Z

本文介绍了一种基于常识感知的跨模态对齐框架,旨在提高视频时间定位的精确度和效率。该方法通过结构化语义信息提取和跨模态交互模块,在多个数据集上超越了现有技术。此外,研究提出了CONE、Mug-STAN和TOPA等新方法,在视频-语言对齐和分析中取得了显著成果,推动了多模态大语言模型的发展。

PiTe:大规模视频语言模型的像素时间对齐

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-09-11T00:00:00Z

本文研究了联合语音-文本嵌入空间的属性,提出了一种无监督的跨模态对齐框架,通过对抗训练实现语音与文本的嵌入对齐,从而提升低资源语言的语音识别和翻译性能。此外,研究探讨了音频元数据的融合检索系统,并提出了有效的音频-文本嵌入验证器,在多个任务中表现优异。

听音不识谱:两塔多模式仪器识别系统评估

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-07-25T00:00:00Z

本文提出了一种跨模态对齐任务,旨在提高音频和视觉模态的交互,增强声源定位和跨模态检索的性能。研究开发了音频-视觉空间整合网络和无监督算法,利用空间线索和递归注意机制,提升声源定位的准确性和可靠性。实验结果表明,该方法在多个数据集上优于现有技术。

视听对齐:通过音视频对齐来实现先进的声源定位

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-07-18T00:00:00Z

本文提出了一种大型语言模型引导的时刻检索方法,旨在改善视频上下文表示和跨模态对齐,从而提升目标时刻定位的准确性。通过利用多模态大型语言模型的视觉文本理解能力,生成视频文本描述并进行时间对齐,显著提高了检索效果。研究表明,该方法在视频理解任务中表现优异,为多模态分类提供了新方向。

多模态大型语言模型对视频片段检索的惊人有效性

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-06-26T00:00:00Z

本文提出了一种基于拓扑的最优传输框架(TOT),用于解决跨模态对齐问题,揭示互联网恶意内容的隐患。TOT在公开数据集上表现优越,改进了生成分布与数据分布的对齐。此外,研究介绍了HateCOT数据集,显著提升了有害内容检测模型的性能,尤其在低资源情况下。

COT: A Method for Generating Countermeasures Against Hate Speech through Comparative Optimal Transport

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-06-18T00:00:00Z

本文提出了一种语义增强的视觉-语言预训练模型,通过局部语义增强和遮蔽策略实现跨模态语义对齐,显著提升了多项视觉-语言任务的性能,尤其在低资源环境下表现优异。

SyncMask:时尚中心化视觉 - 语言预训练的同步注意屏蔽

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-04-01T00:00:00Z

本文研究了跨模态对齐的图像检索,提出了IRRA框架,并在多个数据集上取得了优异成果。结合视觉和语言模型,探索了车辆搜索的潜力,提出VAL-PAT框架以增强行人分析任务,利用CLIP模型进行行人属性识别,展示了在数据稀缺情况下的优越性能。

CVPR 2023 第一届基础模型挑战赛 - Track2 的解决方案

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-03-26T00:00:00Z

该文综述多模态自监督强化学习进展,重点包括结合触觉与视觉提升样本效率、CURL利用对比学习从像素提取特征、M3L和MViTac等融合多模态表示,以及通过跨模态对齐、标签生成和传感器融合改善策略学习与泛化。

M2CURL: 机器人操作的自主监督表征学习实现高效的多模态强化学习

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-01-30T00:00:00Z

该文综述CLIP在持续学习中的表现:冻结模型的零样本评估在类增量、域增量等五类基准上多优于现有方法,且简单提示模板即可影响性能。后续研究提出多级交互训练轻量CLIP、跨语言参数高效迁移、NLLB-CLIP多语言图像检索、CLIP-benchmark评估、适配器与提示调整、LaCLIP语言重写、CLIPTrans跨模态对齐及VT-CLIP视觉引导文本等方法。

在 CLIP 中通过持续语言学习拥抱语言包容性和多样性

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-01-30T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码