In a recent article, Colin Weld and Connor Adams, staff engineers at Modal, describe how they rebuilt their sandbox infrastructure from the ground up to support millions of concurrent sandboxes...
开源项目 jeff 使用 4 亿参数 GLiFormer 模型在本地 GPU 进行文本分类,完整复刻 TypeSafe 的 jev API 协议,仅需修改 TYPESAFE_BASE_URL 环境变量即可零代码迁移,成本从每百万次 15.6 美元降至 2.6 美元。简单情感和情绪分类准确率几乎追平 jev,但 AG News 主题分类和反讽检测落后约 15 个百分点。推荐使用 Modal 平台的 L4 GPU 部署,每秒约处理 50 次请求。
Cohere has launched Parse 5, a multimodal foundation model designed to extract structured data from complex enterprise documents. The 2.3-billion-parameter system converts visually rich PDFs into...
Modal 是一个云AI算力平台,提供免费的 GLM-5.1 模型,参数为746B,使用限制为每次只能有一个并发请求,免费使用到4月30日。测试时可能遇到限速问题,建议用户在热度过去后再尝试。
In this article, the author explores how hierarchical agentic RAG systems coordinate specialized workers through structured orchestration to improve accuracy, reliability, and explainability in...
本文讨论了在电子商务搜索中微调稀疏嵌入的方法,重点介绍了使用亚马逊ESCI数据集训练SPLADE模型的过程。强调了数据格式化的重要性,以及通过SpladeLoss实现对比学习与稀疏性正则化的平衡。此外,使用Modal的持久存储解决了检查点管理问题,确保了训练过程的稳定性。
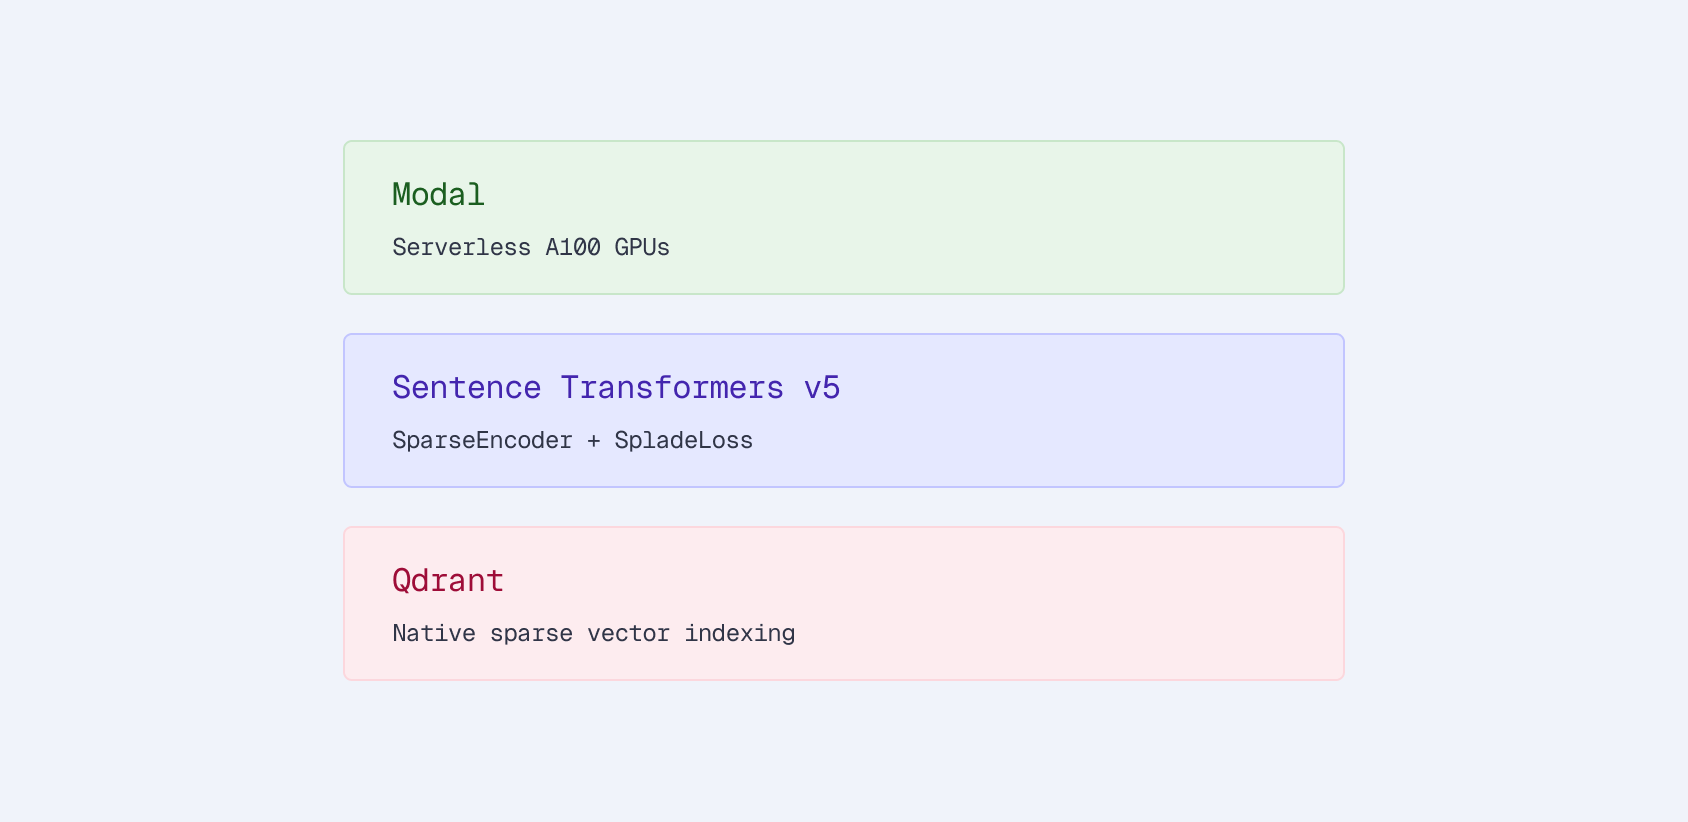
本文介绍使用Modal无服务器GPU训练SPLADE稀疏嵌入模型。基于亚马逊ESCI数据集,将Exact和Substitute对作为正样本,通过SpladeLoss结合对比学习与稀疏正则化,控制查询约30词、文档100-400词。产品文本以品牌括号和竖线分隔格式化。10万样本在A100上训练约6分钟、成本不足1美元,检查点存入持久卷,支持断连续跑和并行超参搜索。
保罗·巴特勒和泰勒·鲍德温在生成艺术领域相识后创立了Jamsocket,旨在解决浏览器性能不足的问题。Jamsocket提供实时协作和数据密集型应用的基础设施,支持会话状态管理。尽管面临开发者思维转变的挑战,Jamsocket通过开源和简化接口吸引用户。最近,Jamsocket与Modal合并,扩展产品线,提升性能和可扩展性。
Modal是一个无服务器平台,用户可以快速构建和部署Python应用。通过单个命令,用户可配置系统需求并将应用部署到云端。本文介绍了Modal的设置、vLLM服务器的创建与安全部署,以及使用CURL和OpenAI SDK进行测试。Modal简化了云基础设施管理,适合初学者和数据科学家。
本研究提出了一种新方法,结合外生时间序列特征与静态特征,以提升医疗领域时间序列预测模型的透明性和可解释性。实验结果表明,该方法在保持预测准确性的同时,增强了模型的可解释性和鲁棒性。
本研究针对语音LLM在上下文推理和副语言理解方面的不足,提出了一种新框架,通过实际语音数据生成问答数据集。研究结果显示,语音LLM在同理推理任务中的局限性,强调了对相关数据集和更强模型的需求。
本研究提出了一种新的跨模态对齐方法——结构引导跨模态对齐(SGCMA),旨在提升大型语言模型在时间序列预测中的应用。该方法通过学习状态转移图结构和语义对齐,显著提高了预测性能和泛化能力。
本研究提出了一种名为PI-VAD的框架,用于弱监督视频异常检测。通过引入五种附加模态来增强RGB特征,从而提高异常检测的可靠性。PI-VAD在多个数据集上表现出色,展示了有效整合多模态信息的潜力。
本研究提出了一种基于最佳运输的图匹配方法(GM-OT),旨在解决从预训练语言模型向声学特征学习转移语言知识时的对齐挑战。该方法通过将语言和声学序列建模为结构化图,提升了知识迁移效率,显著提高了自动语音识别模型的性能。
2025年NLPCC共享任务4旨在推动医学教学视频中的多模态、多语言和多跳问题回答研究。新挑战M4IVQA评估模型在处理视频与文本数据、理解多语言查询及合理回答方面的能力,促进医疗场景中的多模态推理系统创新,提高医疗教育平台的效率。
本研究提出了一种名为Biomed-DPT的双模态提示调优技术,旨在提升生物医学图像分类的提示学习效果。通过结合临床提示、领域适应提示和视觉提示中的零向量软提示,该方法显著提高了分类准确率。
本研究提出VITA-Audio,一种高效的大规模语音模型,解决了现有模型在流媒体生成首个音频令牌时的高延迟问题。通过引入轻量级的多模态交叉令牌预测模块,该模型显著提高了推理速度,具备实时对话能力,并在多个任务中表现优异。
本研究提出了一种多尺度跨模态融合网络(MSFNet-CPD),旨在提高农业害虫识别的准确性。该方法结合视觉和文本特征,并构建了两个新数据集(CTIP102和STIP102)。实验结果表明,MSFNet-CPD在多个检测基准上优于现有技术,展现出良好的应用潜力。
本研究提出了一种新训练目标,通过对语义表示施加约束,增强正样本对齐。同时,针对BERT模型的注意力沉没现象,提出交叉注意力结构,以提升CLS标签的注意力和池化质量。该方法在多个语义文本相似度任务中表现优异。
本研究提出CLIP-KOA框架,通过结合图像和文本信息,利用对称损失和一致性损失,提高膝关节骨关节炎(KOA)的诊断准确性。结果表明,该方法在KOA严重度预测中达到了71.86%的最佳准确率,增强了医疗预测的可靠性。
完成下面两步后,将自动完成登录并继续当前操作。