
如何在廉价硬件上运行大模型?
内容提要
大模型在普通硬件上运行需降低内存占用与计算量。主要技术包括:量化压缩权重精度(如8B模型从16GB降至4GB)、分层卸载按需将权重移入GPU、混合专家仅激活部分参数、蒸馏用小模型学习大模型、剪枝去除低贡献权重、推测解码用小模型预生成再验证。KV缓存和FlashAttention等软件优化也能提升效率。目标是在硬件预算内平衡质量与响应速度。
延伸解读
本地运行大模型:不只是省钱
文章指出,本地运行大模型可让现有硬件用于实验,减少对租用算力的依赖,尤其适合处理隐私文档和专有代码。离线可用性对桌面助手、远程安装等场景很重要,开发者也能更自主地控制模型版本和应用行为。但本地运行并非总是更便宜,硬件、电费、维护和响应速度都需考虑。偶尔使用托管服务可能更经济,频繁使用则本地硬件可能更划算,具体取决于实际应用。
量化:压缩权重,但需权衡质量与速度
量化通过降低数值精度来减少权重占用,例如8B模型从16位约16GB降至4位约4GB。参数数量不变,但每个参数存储更紧凑。代价是可能降低回答质量,程度取决于模型、压缩方法和任务。普通对话表现良好,特定编程问题可能不可靠。此外,低精度不保证速度成比例提升,因为有些实现以4位存储但以更高精度计算,高效执行依赖硬件支持和软件转换。
MoE与剪枝:架构和稀疏化的局限
混合专家(MoE)通过路由网络为每个token选择部分专家,减少计算量,但所有专家仍需存储,因此总参数决定内存占用。例如40B参数的MoE,4位存储仍需约20GB,小激活子集不改变存储需求。剪枝移除低贡献权重或结构,但置零不自动节省执行成本,需要压缩表示、能跳过工作的执行引擎或结构改变,且可能需额外训练恢复质量。两者都不能单独让大模型适配低内存设备。
KV缓存与软件优化:不可忽视的运行时因素
即使权重缩小,长文档仍可能因KV缓存导致内存不足。缓存随序列增长,多轮对话更需额外内存。解决方案包括减少上下文、检索相关段落、量化缓存或移至CPU内存,但可能影响质量或速度。软件优化如FlashAttention重组注意力计算,减少内存流量;PagedAttention管理KV缓存块,减少浪费;批处理提高吞吐但增加工作内存。这些优化不改变权重,却能显著提升相同硬件的可用性。
Q&A
量化是如何让大模型在廉价硬件上运行的?
量化通过降低权重数值的精度来减少内存占用。例如,一个8B模型在16位精度下需要约16GB,而4位量化后仅需约4GB。这通过将权重映射到更小的值集合(如4位有16个可能值)实现,可能带来轻微的质量下降,但能显著节省内存。
什么是分层卸载,它有什么优缺点?
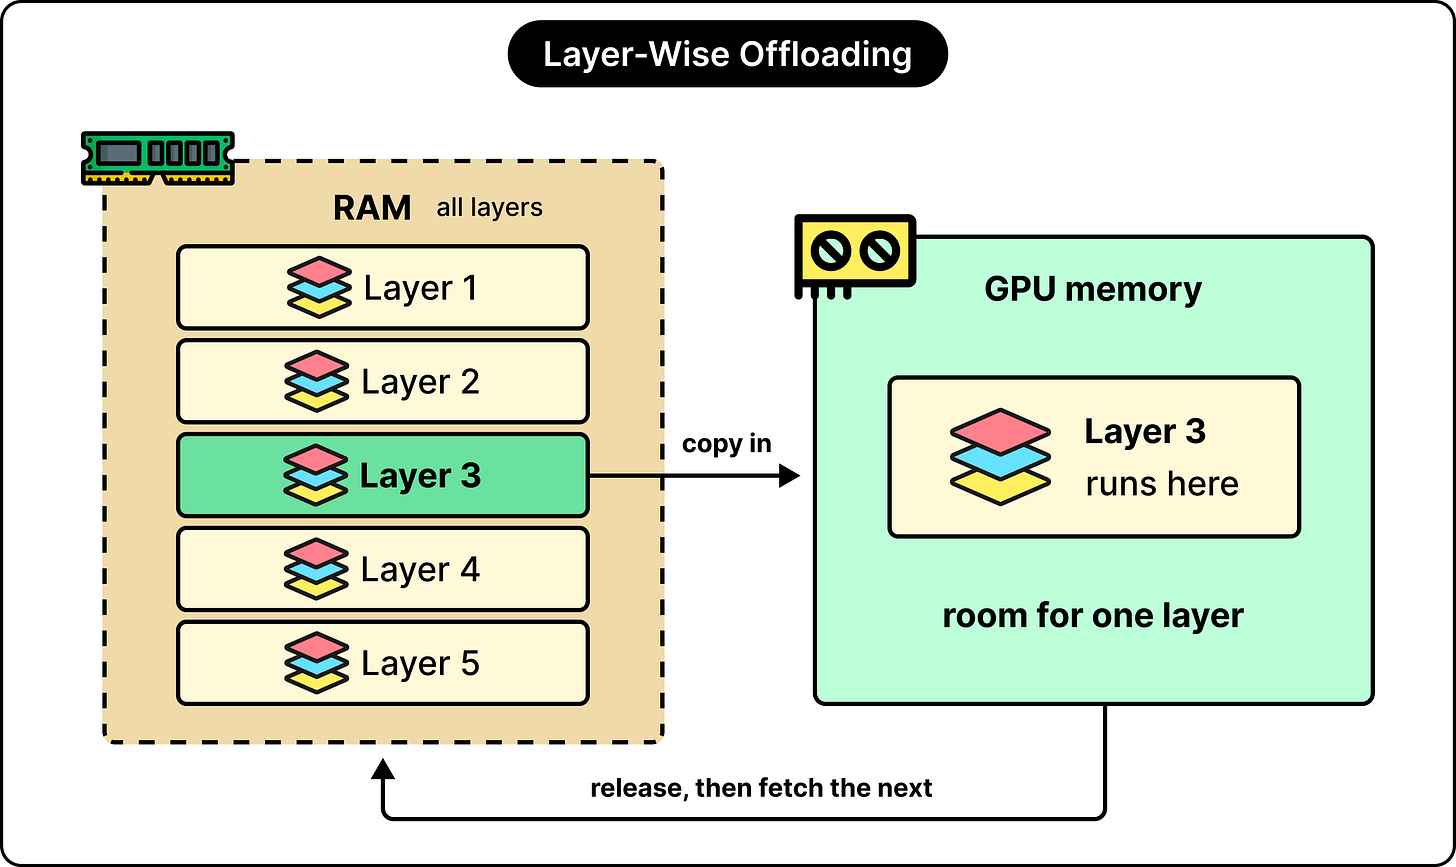
分层卸载是一种按需将模型权重从内存移到GPU的技术。它不需要一次性将整个模型放入GPU内存,而是逐层加载、执行后释放。优点是降低GPU内存需求,缺点是频繁的数据传输可能导致生成速度变慢,尤其当传输带宽有限时。
混合专家模型如何帮助减少计算量?
混合专家(MoE)模型在每层包含多个专家网络,但每个token只激活其中少数几个。这减少了每个token的计算量,因为只有被选中的专家参与运算。然而,所有专家仍需存储,因此内存占用可能仍然很大,不能自动让大模型适应低内存设备。
知识蒸馏和剪枝在模型压缩中有什么区别?
知识蒸馏是用大模型(教师)训练一个小模型(学生),使学生能独立运行,但可能失去一些泛化能力。剪枝则是移除对输出贡献小的权重或结构,但需要配合压缩表示和优化执行引擎才能真正节省计算。两者目标不同:蒸馏产生新小模型,剪枝修改原模型。
推测解码如何加速大模型推理?
推测解码使用一个小而快的草稿模型先提出多个候选token,然后由大目标模型并行验证这些token。接受正确的token,拒绝时由目标模型纠正。这利用了并行验证来加速生成,但需要额外内存存放草稿模型,且加速效果取决于草稿模型与目标模型的一致性。
除了模型权重,还有哪些因素影响大模型在廉价硬件上的运行?
KV缓存会随着序列长度增长而占用大量内存,可能成为瓶颈。软件优化如FlashAttention和PagedAttention能减少内存流量和浪费。此外,内存带宽、GPU支持的计算精度以及批处理策略也会影响推理速度和内存使用。
