


【多智能体强化学习】MAPPO 论文笔记
内容提要
本文介绍了多智能体强化学习算法MAPPO及五个调优建议,包括价值归一化、局部和全局特征输入、训练周期数、剪切比率和批量大小。MAPPO在多智能体环境中实现了与基于策略的方法相当的性能。
延伸解读
MAPPO 与 IPPO 的关键差异
MAPPO 与 IPPO 的核心区别在于价值函数的输入:MAPPO 使用全局状态,而 IPPO 仅使用局部观测。文章指出,在两个智能体的简单设置中,两者性能相当;但随着智能体数量增加,MAPPO 明显优于 IPPO,表明集中式价值输入对复杂多智能体环境至关重要。这一对比为选择算法提供了直接依据。
价值函数输入设计的权衡
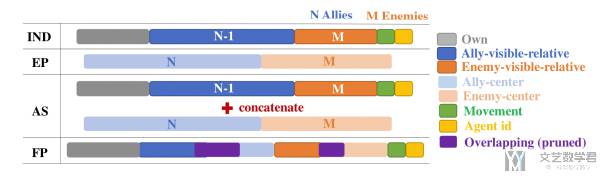
文章比较了四种价值输入:CL(局部观测拼接)、EP(环境全局状态)、AS(EP+智能体局部观测)和 FP(剪枝后的 AS)。实验显示,CL 维度高且效果差;EP 在困难地图上表现不佳;AS 和 FP 性能强劲,FP 有时更优。这提示设计价值输入时,需兼顾全局信息与智能体特定信息,并避免维度冗余。
训练数据利用的注意事项
MAPPO 对训练周期数和小批次数量敏感。文章建议在困难任务中使用 10 个周期,简单任务 15 个周期,并避免将数据分割成过多小批次(如 4 个),因为过度重用样本会因多智能体非平稳性导致性能下降。使用 1 个小批次在多数地图上表现最佳,说明大批次有助于稳定梯度估计。
超参数调优的实践指导
文章给出了剪切比率 epsilon 和批次大小的建议:epsilon 应保持在 0.2 以下,以平衡训练稳定性和收敛速度;批次大小应足够大以提升任务性能,但过大会降低样本效率并浪费计算资源。这些建议基于大量实验,为实践者提供了可操作的调参方向。
Q&A
MAPPO算法的主要目标是什么?
MAPPO算法旨在通过简单修改证明PPO在多智能体环境中的优异性能。
MAPPO的五个调优建议是什么?
五个调优建议包括:价值归一化、局部和全局特征输入、训练周期数、剪切比率和批量大小。
如何应用价值归一化来稳定价值学习?
通过使用价值目标的平均值和标准差的动态估计来标准化价值函数的目标值。
在MAPPO中,训练周期数应该如何设置?
在困难环境中最多使用10个训练周期,在简单环境中使用15个训练周期,避免将数据分割成小批次。
剪切比率epsilon的最佳设置是什么?
为了获得最佳的PPO性能,应保持剪切比率epsilon在0.2以下。
MAPPO在多智能体环境中的表现如何?
MAPPO在多智能体环境中与基于策略的方法相媲美,且无需领域特定的算法修改。
