3600万细胞装进同一空间,斯坦福大学提出通用细胞嵌入模型UCE,跨8个物种构建超大规模细胞图谱
内容提要
斯坦福团队在《Nature》提出通用细胞嵌入模型UCE,无需微调或标注即可将任意物种的单细胞数据映射到统一空间。其训练集包含超3600万个细胞,在零样本任务中优于现有方法,能揭示跨组织、跨物种的细胞组织规律,并助力肺部疾病研究。
延伸解读
无需微调与标注的通用性
UCE 的核心优势在于对新数据集无需微调或重新训练,也无需细胞类型标注和基因筛选。它利用蛋白质语言模型 ESM2 表征基因,因此能处理训练中未见过的物种和基因。这降低了单细胞数据分析的门槛,使研究人员能快速将新数据映射到统一空间,并与已有注释的参考细胞状态进行比较。
涌现的组织结构与跨组织一致性
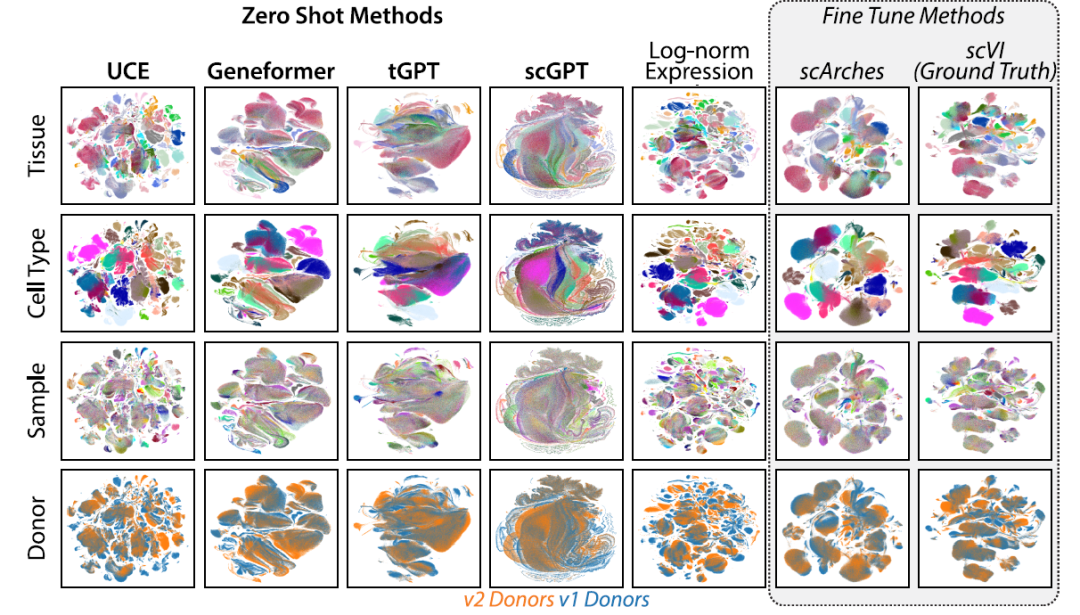
在 UCE 嵌入空间中,细胞按类型自然聚类,批次效应被混合,这种组织结构并非显式训练所得,而是涌现行为。例如,来自 73 种组织的人类巨噬细胞中,72% 的组织特异性巨噬细胞质心在 UCE 空间中最近邻是其他组织的巨噬细胞。这表明模型能捕捉跨组织共享的细胞身份,与已知生物学规律一致。
零样本性能与跨物种泛化
在未参与训练的 Tabula Sapiens v.2 数据集上,UCE 整体得分比 Geneformer 高 13.9%,生物学信息保留高 16.2%,批次校正高 10.1%。在跨物种标签迁移任务中,UCE 在 4 个数据集中的 3 个上优于 SATURN 和 SAMap,甚至对果蝇等高度分化物种也能生成一致嵌入,展示了强大的零样本泛化能力。
局限与使用边界
UCE 仍存在限制:基准测试主要评估恢复专家注释的能力,受标签粒度和主观性影响,可能无法充分反映细微生物学过程;模型是黑箱,难以解释嵌入形成原因;训练数据偏向哺乳动物和脑组织,泛化到代表性不足的物种和场景存疑。此外,UCE 不能取代传统批次校正方法,处理已知混杂因素时传统方法仍有价值。
Q&A
斯坦福大学提出的UCE模型是什么?它有什么特别之处?
UCE(通用细胞嵌入)是斯坦福团队在《Nature》提出的细胞基础模型,无需微调或标注即可将任意物种的单细胞数据映射到统一空间,训练集包含超3600万个细胞,在零样本任务中优于现有方法。
UCE模型是如何训练和工作的?
UCE完全采用自监督训练,不使用细胞类型标注。它将细胞抽象为“RNA袋”,利用蛋白质语言模型ESM2根据基因编码的蛋白质表示基因,整合染色体位置等元数据后输入Transformer,最终取CLS token的嵌入作为细胞表征。
UCE在跨物种和零样本任务上的表现如何?
UCE在零样本任务中优于现有方法,例如在Tabula Sapiens v.2上整体得分比Geneformer高13.9%。在跨物种标签迁移中,UCE在4个数据集中的3个上优于SATURN和SAMap,甚至能对果蝇等高度进化分化的物种生成一致嵌入。
UCE模型有哪些局限性?
UCE的基准测试主要评估恢复专家注释细胞类型的能力,受标签粒度和主观性限制;模型仍是黑箱,难以解释嵌入形成原因;训练数据偏向哺乳动物(尤其是人和小鼠)及脑组织,可能影响泛化;此外,它不能取代传统的批次效应校正方法。
UCE在肺部疾病研究中有什么应用?
研究人员利用UCE和Norn分类器分析了IPF、COPD患者及对照组的肺部细胞,识别出Norn样肺部细胞,并发现这些细胞在不同疾病组间存在表达差异,提示疾病预后差异可能与Norn样细胞有关。
UCE的训练数据集IMA包含哪些内容?
IMA(Integrated Mega-scale Atlas)整合了公开的单细胞RNA测序数据,核心训练数据超过3600万个细胞,其中3390万个来自人类和小鼠(285个数据集),其余230万个来自28个数据集,涵盖8个物种:人、小鼠、斑马鱼、恒河猴、食蟹猴、鼠狐猴、蛙和猪。
