使用生财 MCP 构建 LLM-WIKI
内容提要
LLM-WIKI 是 Karpathy 提出的理念:让大模型将阅读、理解、问答持续沉淀为持久、互链、带引用的 Markdown 知识库,实现知识复利。OpenKB 是其开源实现。结合 scys-mcp 采集生财有术精华帖等数据,用 AI Agent 驱动 OpenKB 编译入库,可构建知识图谱与问答系统,并定期 lint 维护。
延伸解读
LLM-WIKI 的核心机制:知识复利循环
LLM-WIKI 通过“资料进入→知识编译→问答复用→好答案回写→定期维护”的循环,将大模型的阅读从一次性消耗变为复利资产。每次摄入都会沉淀为持久、互链、带引用的 Markdown 知识库,并通过定期 lint 检查断链、修正引用、处理冲突和更新陈旧事实,防止知识腐化。这一机制强调 Agent 拥有 wiki,人类拥有判断力。
生财有术场景下的落地工具链
构建生财有术 LLM-WIKI 需要四类工具:scys-mcp 负责只读拉取生财数据,openkb 作为知识编译器与问答引擎,LLM API 提供理解与综合能力,AI Agent Client(如 ZCode 或 Claude Code)执行操作。用户只需创建 wiki 文件夹,通过对话驱动 Agent 完成初始化、数据采集与入库,无需从零搭建基础设施。
从知识库到可复用技能:优化与维护建议
文章建议将数据采集过程持久化为 SKILL,例如生成 scys-ingest skill,并优化 openkb 的 metadata 和文件命名规则。日常使用 openkb lint 检查知识库并修正问题,还可通过 openkb skill new 从 wiki 中提炼可复用技能。有条件时可将采集入库设为定时任务,但需注意数据采集尽量在晚上跑,避免给生财服务器增加压力,且应追求小而精而非大而全。
Q&A
LLM-WIKI 是什么?它的核心理念是什么?
LLM-WIKI 是 Andrej Karpathy 在 2026 年 4 月提出的理念,核心是让大语言模型把阅读、理解、综合、交叉引用、矛盾发现和问答,持续沉淀为一个持久、结构化、互链、带引用的 Markdown 知识库。其原则是“Agent owns the wiki; human owns the judgment.”。
LLM-WIKI 能带来哪些具体价值?
LLM-WIKI 可以把离散信息沉淀成结构化知识库,把文档集合转化为概念图谱,把问答过程变成知识维护过程,把 LLM 的阅读从一次性消耗变成复利资产,并通过定期 lint 检查和维护防止知识库腐化。
OpenKB 是什么?它和 LLM-WIKI 有什么关系?
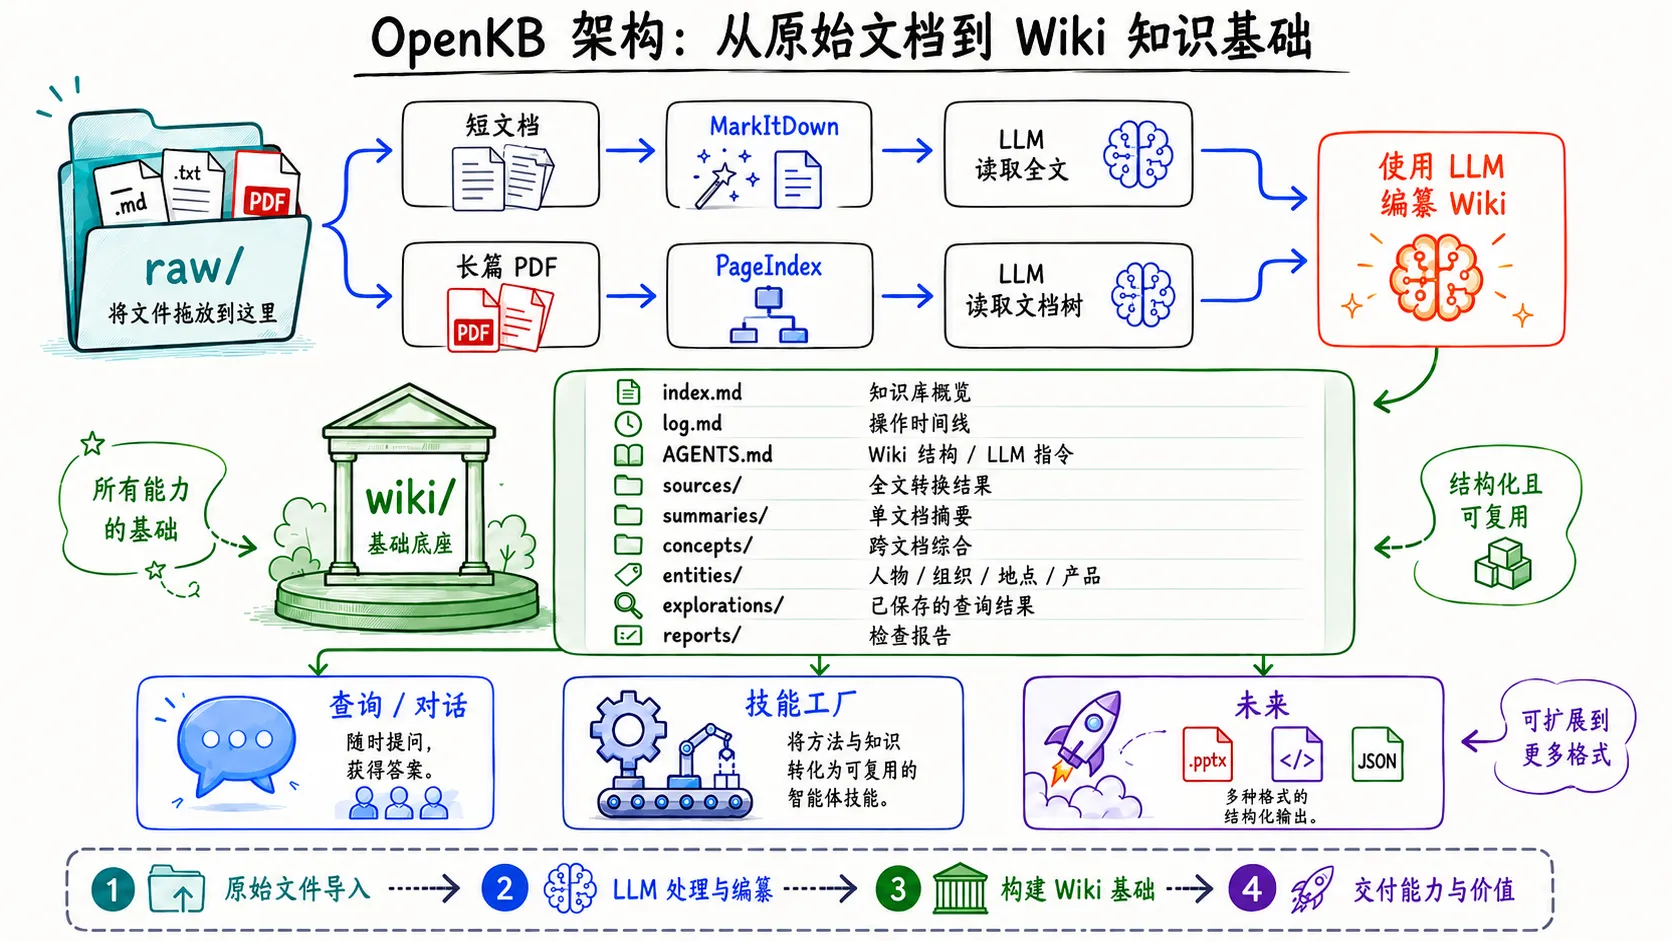
OpenKB 是 LLM-WIKI 理念的开源实现。借助 OpenKB,可以方便快捷地搭建知识库,而不需要从零开始搞基建。
如何使用生财有术 MCP 构建 LLM-WIKI?需要哪些工具?
需要 scys-mcp 获取数据、openkb 加工数据、LLM API 作为 openkb 大脑、AI Agent Client 作为执行助理。构建过程:创建一个 wiki 文件夹,用 AI Agent 打开,通过对话完成初始化 OpenKB、初始化项目上下文、执行数据采集与 WIKI 构建。
构建 LLM-WIKI 时有哪些优化项可以提升体验?
可以把数据采集过程持久化为 SKILL,优化/修正知识库内容(如 metadata、文件命名规则),进行日常的 wiki lint 检查和维护,从 WIKI 中提炼可复用的 Skills,有能力的话可以将数据采集和入库过程做成定时任务。
生财有术 LLM-WIKI 可以实现什么效果?
可以构建知识图谱(如 OpenKB 知识图谱、Obsidian 关系图谱),并实现问答,例如梳理汇总公众号垂直小号的所有资料,提供操作指引、工具、经验心得。
