


赋予家庭机器人一些常识
原文英文,约1800词,阅读约需7分钟。
📝
内容提要
麻省理工学院的工程师们利用大型语言模型,使机器人在执行家庭任务时能够自我纠正错误。通过将机器人运动数据与语言模型的常识知识相结合,机器人能够将复杂任务分解为子任务,并在遇到干扰时进行调整,从而提高任务成功率,减少对人工编程的依赖。
🔎
延伸解读
模仿学习的局限与突破
文章指出,模仿学习是家庭机器人训练的主流方法,但机器人若盲目模仿人类轨迹,微小误差会累积并导致任务失败。新方法通过大语言模型将任务分解为子任务,使机器人能在遇到干扰时自我纠正,而无需从头开始。这解决了模仿学习在面对环境变化时的脆弱性问题。
语言模型如何赋予机器人常识
研究团队利用大语言模型生成任务步骤的自然语言标签(如“伸手”“舀取”),并通过算法将这些标签与机器人的物理状态(坐标或图像)关联,即“接地”。这样,机器人能自动识别当前所处的子任务,并在受到推挤或干扰时重新规划,继续执行而非重启。
实验验证与潜在影响
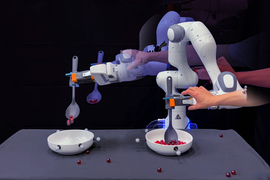
在舀弹珠实验中,机器人经过几次人类演示训练后,即使被实验者推挤或打翻勺子,也能自我纠正并完成每个子任务。该方法减少了对人工编程和额外演示的依赖,有望将遥操作收集的训练数据转化为更鲁棒的机器人行为,推动家庭机器人的实际应用。
❓
Q&A
麻省理工学院的工程师们如何使机器人能够自我纠正错误?
他们利用大型语言模型,将机器人运动数据与常识知识结合,使机器人在执行家庭任务时能够自我纠正错误。
这种新方法如何提高家庭机器人的任务成功率?
通过将复杂任务分解为子任务,机器人能够在遇到干扰时进行调整,而无需从头开始任务。
模仿学习在家庭机器人训练中存在哪些局限性?
模仿学习无法应对环境变化,导致机器人在遇到干扰时无法调整,只能从头开始任务。
研究团队是如何将语言模型与机器人的物理状态连接起来的?
他们开发了一种算法,自动将语言模型的自然语言标签与机器人的物理状态进行映射,称为“基础分类器”。
实验中机器人在被干扰时表现如何?
实验中,机器人能够自我纠正错误,成功完成每个子任务,而不需要重新开始。
这种新方法对家庭机器人未来的发展有什么影响?
该方法可以减少对人工编程的依赖,使机器人能够在复杂任务中表现得更加灵活和智能。
🏷️
