

读《通向AGI之路:大型语言模型(LLM)技术精要》笔记整理
内容提要
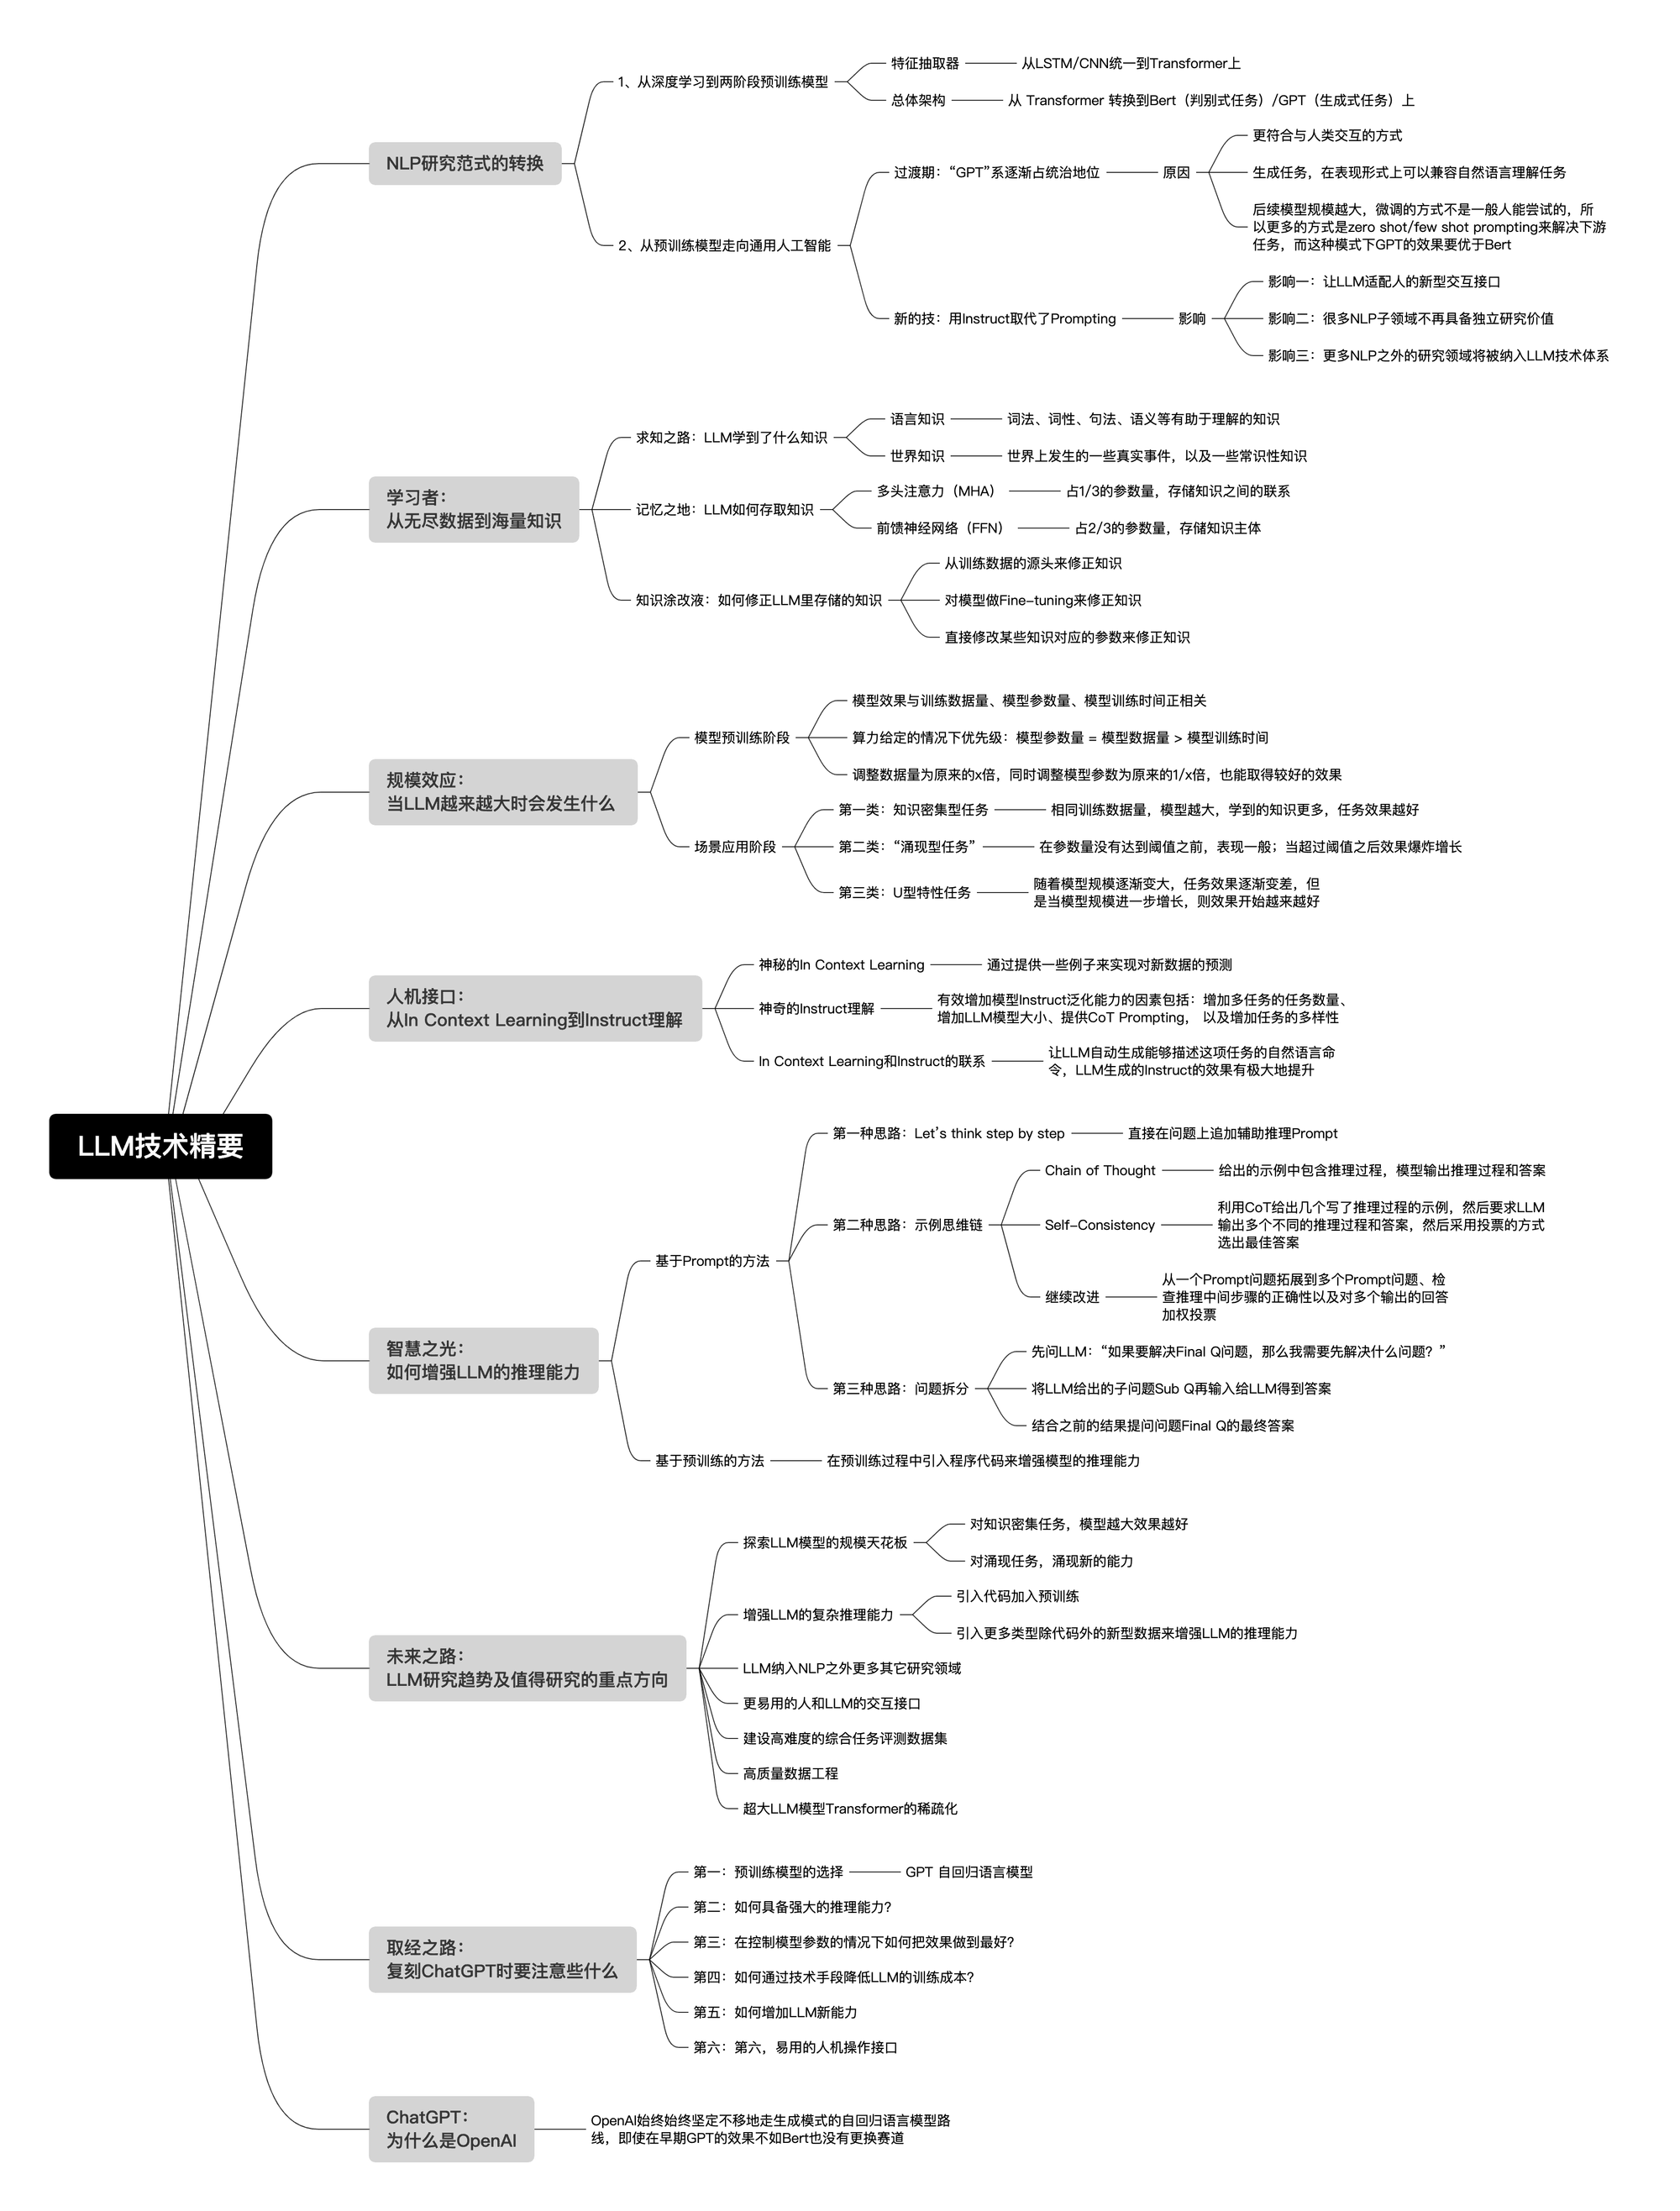
《通向AGI之路》梳理了大语言模型技术要点:NLP经历从深度学习到预训练模型、再到ChatGPT以指令微调取代提示工程的范式转换;LLM从数据中习得语言与世界知识,存储于Transformer的FFN参数中;规模增长带来涌现能力,但复杂推理仍较弱;未来方向包括扩大规模、增强推理、引入代码预训练和优化人机接口。
延伸解读
范式转换的实质:从人适配模型到模型适配人
文章指出,NLP领域经历了两次范式转换:第一次从深度学习到预训练模型,统一了技术栈;第二次从预训练模型走向通用人工智能,ChatGPT用Instruct取代Prompting。其核心是让LLM适配人的习惯命令,而非让人绞尽脑汁设计提示语。这降低了使用门槛,也意味着未来人机交互将更自然,但技术实现依赖人类偏好知识的注入。
知识存储与修正:FFN是关键,但修正成本高
LLM的知识主要存储在Transformer的FFN参数中,约占三分之二。语言知识分布在低中层,世界知识集中在中高层。修正错误知识有三类方法:从训练数据源头修正、Fine-tuning修正、直接修改参数。但各有局限:源头修正成本高,Fine-tuning可能灾难遗忘,直接修改参数技术尚在探索。这提示我们,LLM的知识管理仍面临挑战。
规模效应与涌现能力:并非简单正相关
模型规模增大能提升知识密集型任务效果,并可能解锁新能力(涌现现象)。但涌现可能源于评价指标不平滑或任务多步骤特性,并非真正的能力突变。此外,Scaling Laws研究显示参数量与数据量需平衡,Chinchilla模型以更小规模超越更大模型。因此,盲目扩大规模并非最优,需综合考虑数据、算力和任务特性。
推理能力增强:Prompt与代码预训练是当前路径
LLM的复杂推理仍薄弱,现有增强方法包括基于Prompt的思维链(CoT)、自洽性投票、问题分解,以及在预训练中引入代码数据。这些方法能提升推理表现,但本质仍是激发模型已有能力或引入外部结构。作者认为,LLM推理可能类似于图上推理或程序执行,未来需更本质的突破,如引入新型数据或改进模型架构。
Q&A
ChatGPT的出现给NLP领域带来了怎样的范式转换?
ChatGPT用Instruct取代了Prompting,实现了让LLM适配人的交互接口,通过注入人类偏好知识使模型能理解人类命令,同时导致很多NLP子领域不再具备独立研究价值,并将更多NLP之外的研究领域纳入LLM技术体系。
LLM从数据中学到了哪些知识?这些知识存储在Transformer的什么位置?
LLM学到了语言类知识(词法、词性、句法、语义等)和世界知识(事实型知识、常识性知识)。语言知识中浅层知识存储在Transformer的低层和中层,抽象语义知识分布在中层和高层;世界知识主要分布在中层和高层,尤其聚集在中层。知识主体存储在FFN参数中,FFN占总参数三分之二,MHA占三分之一。
随着LLM规模增大,模型效果会如何变化?有哪些关键研究发现?
模型效果与数据量、参数量、训练时间正相关。OpenAI研究认为参数量优先级最高,算力增10倍应增5.5倍参数量、1.8倍数据量;DeepMind研究认为参数量与数据量同等重要,应各增3.3倍。此外,规模增大会解锁涌现能力,但复杂推理仍较弱。
In Context Learning和Instruct有什么区别和联系?
In Context Learning通过提供少量示例让LLM预测,但不修正模型参数;Instruct则是让LLM理解人类命令。两者联系在于:给LLM一些示例,让LLM自动生成描述任务的自然语言命令,可极大提升Instruct效果,说明具象示例与自然语言描述之间存在内在联系。
如何增强LLM的推理能力?有哪些主要方法?
基于Prompt的方法:追加辅助推理Prompt(如“Let’s think step by step”)、基于示例的思维链(CoT)Prompting、Self-Consistency投票、问题分解。基于预训练的方法:在预训练中引入程序代码。此外,引入更多类型的新型数据也可能本质提升推理能力。
复刻ChatGPT时需要注意哪些关键点?
第一,预训练模型选择GPT自回归语言模型;第二,引入大量代码和文本一起训练以具备强大推理能力;第三,控制参数下走Chinchilla路子(参数量更小、数据量更大)或检索增强路子;第四,通过Sparse化降低训练成本;第五,增加预训练数据多样性以支持更多任务;第六,建设易用的人机操作接口。
