


Kafka 流式数据写入 Qdrant
内容提要
本文介绍如何利用Kafka与Confluent将实时数据流入Qdrant。架构以MongoDB和Azure Blob Storage为源,通过CDC将变更经Kafka传输,再由Qdrant Sink Connector写入Qdrant向量库。文中给出Confluent、Qdrant、MongoDB及连接器的安装配置步骤,并附示例应用,实现数据自动嵌入与实时相似搜索。
延伸解读
架构核心:CDC 与 Sink 连接器
本文架构以 MongoDB 和 Azure Blob Storage 为源,通过 CDC 将变更实时流入 Kafka,再由 Qdrant Sink Connector 写入 Qdrant。这种设计将数据存储、流处理与向量搜索解耦,使 Qdrant 能持续获得最新向量数据,无需手动干预。对于需要实时相似搜索或 RAG 的应用,该管道能保证索引的时效性,但需注意源端需支持 CDC(如 MongoDB 副本集)。
配置要点:转换器与死信队列
连接器配置中,key.converter 和 value.converter 至关重要,它们决定消息如何序列化并安全传递到 Qdrant。示例使用 StringConverter 和 JsonConverter,并启用死信队列(dead_queue)处理错误消息。若转换器不匹配,可能导致数据写入失败。此外,Qdrant 连接器通过 gRPC 端口 6334 通信,需确保网络可达。这些细节直接影响数据管道的可靠性。
本地环境搭建:MongoDB 副本集与 Qdrant
MongoDB 必须以副本集模式运行,因为源连接器通过 oplog 读取变更流。文中使用 Atlas CLI 快速创建单节点副本集,并给出连接字符串。Qdrant 则通过 Docker 运行,暴露 6333 和 6334 端口。本地测试时无需 API 密钥,但生产环境需配置。这种本地搭建方式便于快速验证,但需注意资源占用和版本兼容性。
示例应用:自动嵌入与实时同步
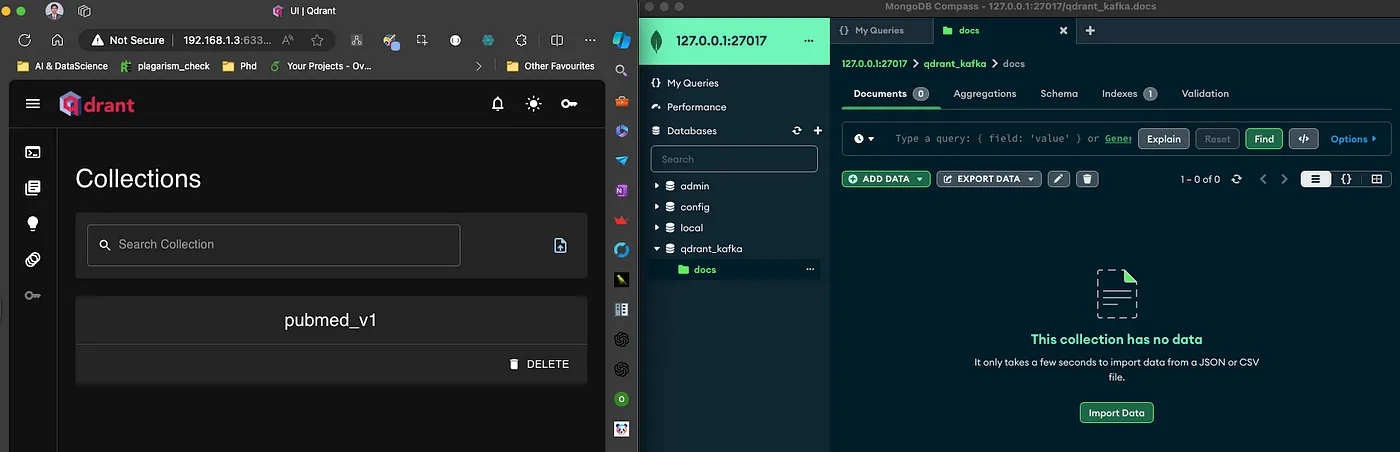
示例应用向 MongoDB 插入包含向量和负载的文档,CDC 触发后数据自动同步到 Qdrant。向量由 fastembed 生成,维度为 384,集合使用余弦距离。这展示了从数据插入到向量搜索的完整链路。实际应用中,可扩展至百万级操作,但需考虑嵌入模型性能、网络延迟及 Qdrant 集群的扩展性。
Q&A
Kafka 流式数据写入 Qdrant 的整体架构是怎样的?
架构以 MongoDB 和 Azure Blob Storage 为源系统,通过源连接器捕获实时变更(CDC)并流入 Kafka,再由 Qdrant Sink Connector 将数据写入 Qdrant 向量库,实现自动嵌入与实时相似搜索。
如何安装和配置 Qdrant Kafka Sink Connector?
使用 Confluent Hub 命令安装:confluent-hub install qdrant/qdrant-kafka:1.4.1。安装后需配置连接器,关键配置包括 connector.class 为 io.qdrant.kafka.QdrantSinkConnector,指定 topics、qdrant.grpc.url(如 http://localhost:6334)和 qdrant.api.key,并注意 key.converter 和 value.converter 的设置。
为什么 MongoDB 作为 Kafka 源需要以副本集模式运行?
因为 MongoDB 源连接器需要通过变更流(change streams)从 oplog 读取变更,而变更流要求 MongoDB 实例必须运行在副本集模式下。
如何本地安装和运行 Qdrant?
可以使用 Docker 安装运行:先执行 docker pull qdrant/qdrant 拉取镜像,再运行 docker run -p 6333:6333 -p 6334:6334 qdrant/qdrant,之后可通过 http://localhost:6333 访问 Qdrant 实例。
示例应用是如何将数据从 MongoDB 同步到 Qdrant 的?
示例应用使用 pymongo 连接 MongoDB,向 qdrant_kafka 数据库的 docs 集合插入包含向量和负载的文档。插入后触发 CDC,MongoDB 源连接器将变更发送到 Kafka,再由 Qdrant Sink Connector 自动写入 Qdrant,实现数据同步。
这个集成方案的主要优势是什么?
该方案实现了实时数据流处理,无需手动干预即可将 Kafka 中的数据持续写入 Qdrant,确保高维向量数据被持续索引并可用于相似搜索,从而增强数据管道的性能和实时语义搜索、RAG 应用的能力。
