微调是深度学习中的迁移学习方法,利用预训练模型适应新任务。根据任务差异,微调可分为全参数和部分参数微调;在资源有限时,部分参数微调能提高性能。微调还可分为监督与无监督微调,以及指令与对齐微调。参数高效微调方法如Adapter Tuning和LoRA,通过减少更新参数量降低计算成本。
本研究提出了一种新的参数高效微调架构ABBA,旨在解决大语言模型在新领域适应的挑战。该方法通过低秩矩阵的哈达玛积更新,增强了模型的表达能力,并在算术和常识推理测试中超越了现有方法。
本研究提出了一种多阶段的参数高效微调方法,旨在将波斯语融入Llama模型,提高其在波斯语分类任务中的准确性,同时对英语任务无负面影响,甚至有所改善。
本研究提出了一种新的参数高效微调方法KaSA,旨在解决大语言模型在特定任务中的计算和内存使用问题。该方法通过知识感知的特征值分解,显著提升模型在自然语言理解和生成任务中的表现。
我们提出了一种单模型推测流方法,通过将草稿融入目标模型,并将微调目标改为未来n-gram预测,加速大模型推理。此方法在摘要和结构化查询任务中加速1.8-3.1倍,无质量损失,参数高效,比Medusa架构快且参数少10000倍,适合资源有限的设备。
本研究提出了一种新的参数高效微调方法,解决了Mamba模型在下游任务中的适应性问题,优化后的PEFT方法显著提升了模型性能。
本研究提出了一种新颖的参数高效微调方法,解决了预训练视觉变换器在下游任务中的适应性不足问题。该方法通过奇异值分解和Householder变换构造正交矩阵,显著提升了微调效果,实验结果表明其在视觉任务中表现优异。
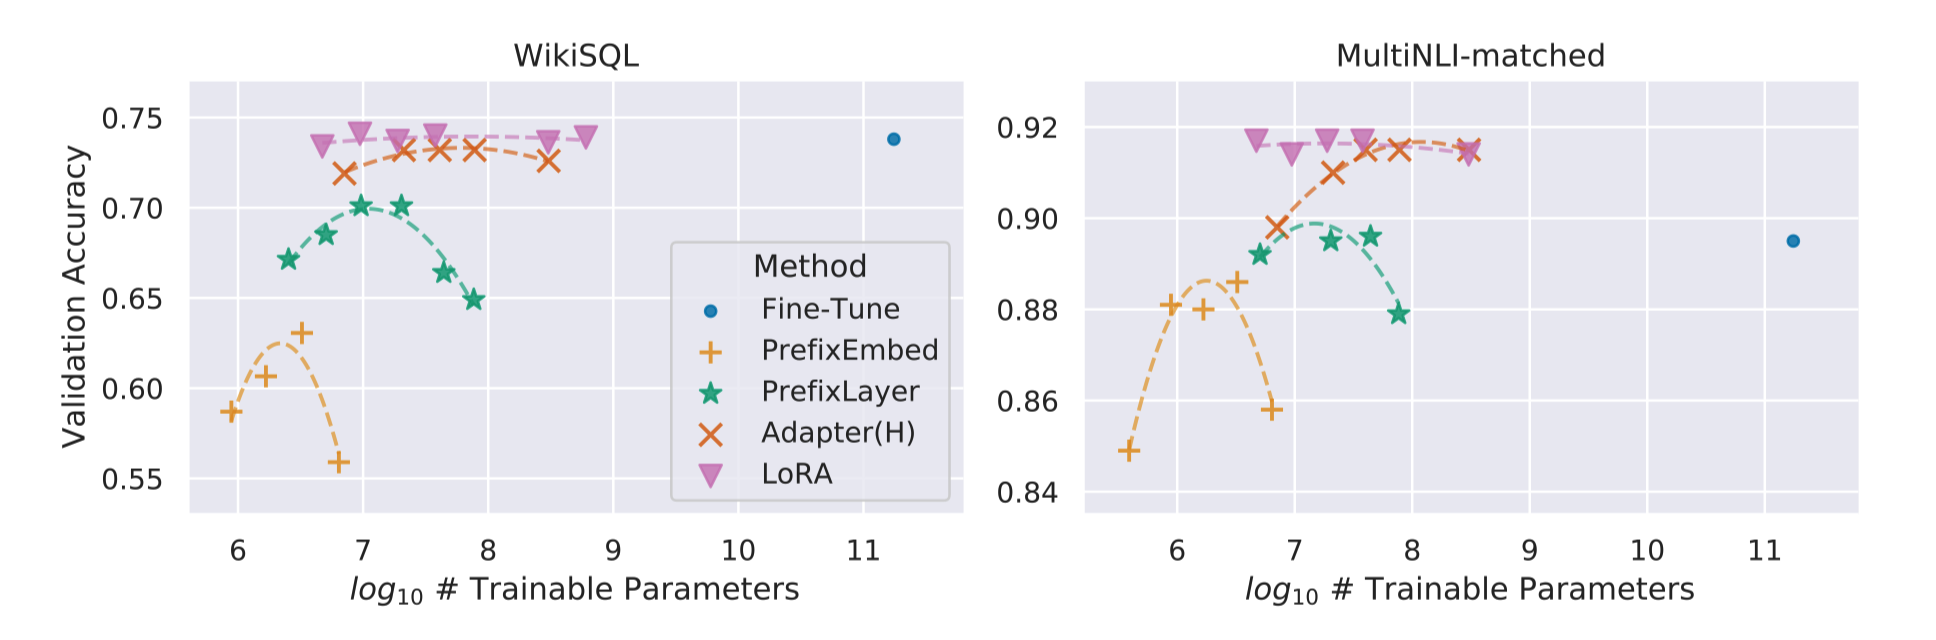
LoRA是一种基于权重变化具有低内在秩这一发现的大模型微调方法。它通过训练小矩阵A和B并加到原权重W上,大幅减少可训练参数。其优点是微调成本低、无推理延迟、可高效切换任务,且与其他方法正交。建议适配更多权重矩阵,秩取2或4即可。
本研究探讨了微调对大型语言模型的影响,特别是在指令识别、知识存储对齐和单词关系学习方面。提出的自然语言反馈微调方法显著提高了问答任务的准确性。研究还指出低秩逼近微调可能保留偏差和有毒行为,而局部微调方法提高了攻击成功率,适配器微调则改善了机器翻译性能。参数高效微调方法展示了更好的效率与性能平衡。
本文综述语言适配器在多语言模型中的作用。研究表明,目标语言适配器的效果因任务、语言和模型而异,保留源语言适配器往往更优,移除影响不大。相关方法包括超适配器、语言家族适配器、轻量适配器及多域适配器,可减少参数、促进跨语言迁移并提升性能。
LoRA通过低秩矩阵注入减少微调参数量,性能媲美全参数微调且无额外推理延迟。后续研究不断优化:FLoRA支持多任务批处理,LoRA-FA降低内存,rsLoRA改进缩放因子,LoTR用张量分解提升参数效率,Delta-LoRA将学习传播至预训练权重,SoRA动态调整内在秩,MultiLoRA增强多任务适应性。
LoRA通过低秩分解减少微调参数,性能媲美全量微调且无推理延迟。后续研究拓展了其应用:PrivateLoRA用于边缘隐私计算与通信优化,DP-LoRA用于联邦学习,SoRA动态调整内在秩,FLoRA支持多任务批处理,LCM-LoRA加速图像生成,LoRA+提升训练速度。
本文综述提示微调(Prompt Tuning)的参数高效方法。SPT通过可学习概率门选择提示层,并用SPT-DARTS双层优化提升性能;软提示的可迁移性取决于神经元激活重叠率;Fast Prompt Tuning节省30%训练算力;SPoT用源任务提示初始化目标任务,减少2.7万倍参数;PPT在预训练阶段加入软提示以改善初始化;LPT将提示插入中间层,训练更快;SPTAR强化密集检索;MPT学习可迁移的共享提示,仅调0.035%参数。
本文综述低秩适应(LoRA)微调技术进展。LoRA通过向Transformer层注入可训练低秩矩阵,减少下游任务参数,性能媲美全量微调且无额外推理延迟。后续研究提出FLoRA、SoRA、LoRA-FA、RunLoRA、LoTR等改进,分别实现多任务批处理、动态秩调整、低内存更新、训练加速与张量分解压缩,提升参数效率与训练速度。
该文综述了多项提升Transformer语言模型训练效率的研究,包括渐进式层丢弃(节省24%时间、提速2.5倍)、CLP-Transfer跨语言渐进迁移、线性变换初始化(降低50%计算成本)、动态低秩重参数化、精心数据预训练、阶段训练与生长算子(节省22%算力)、AutoProg自适应进阶学习(加速达85.1%)、LEMON用预训练权重初始化缩放模型,并探讨主动学习中的数据效率问题。
本文综述混合专家(MoE)模型研究进展:MoE在相同预算下比密集模型更高效,但泛化表现不同;专家原型法将规模扩至万亿参数;参数高效架构缓解参数膨胀;SE-MoE提升分布式训练吞吐量;DeepSpeed-MoE优化压缩与推理;三维混合并行提高训练效率;稀疏模型可缩减为密集模型;ST-MoE-32B在多任务上领先。
DialCLIP是一种参数高效的多模态对话检索方法,通过微调总参数的0.04%,在两个基准数据集上实现了最新性能,展示了其效果和效率,具有推动该领域发展的潜力。
该研究提出了一种基于提示的时间域泛化方法,适用于分类、回归和时间序列预测等任务,具有参数和时间高效的特点,并在时间域泛化方面取得了新的最先进基准水平。代码将公开共享。
本文提出了一种新的参数高效的跨语言转移学习框架,利用基于翻译的对齐方法来缓解多语言差异,并探索参数高效的微调方法。经过实验表明,该框架显著减少了语言之间的差异,并在跨语言转移方面取得了改进,尤其在低资源场景中,同时只保留和微调极少量的参数。
本文提出了一种新的参数高效的跨语言转移学习框架,利用基于翻译的对齐方法来缓解多语言差异,并探索参数高效的微调方法。实验表明,该框架显著减少了语言之间的差异,在跨语言转移方面取得了改进,尤其在低资源场景中,同时只保留和微调极少量的参数。
完成下面两步后,将自动完成登录并继续当前操作。