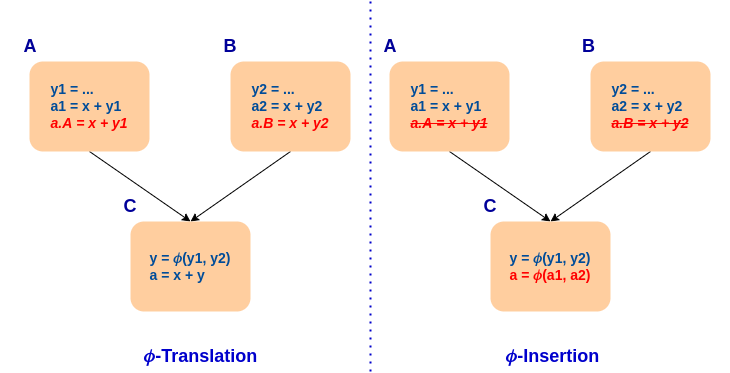
今年夏天,我参加了LLVM编译器基础设施的GSoC项目,目标是改进NewGVN pass,使其能够取代GVN成为LLVM中的主要值编号pass。NewGVN相对于GVN的优势在于完整处理循环,而GVN只能处理非循环代码。我们的主要贡献是为NewGVN开发了一个PRE阶段,通过泛化Phi-of-Ops来实现。我们的实现相比GVN平均性能提高了0.4%,但仍存在一些回归问题。未来的工作包括实现缺失的关键边拆分和加载强制转换功能,并优化PRE的启发式算法。
Unigine SDK 2.19发布,带来多线程渲染器、加快启动速度、减少内存使用等改进。性能提高148%,物理性能提高103%。支持OpenXR标准、.NET 8,改进DLSS和FSR放大器,支持Quadro Sync和WebRTC试验性视频流,支持USD Export。
2023年12月下旬,CPython核心开发人员Brandt Bucher向Python 3.13分支提交了一个添加JIT编译器的请求。JIT是一种按需编译的设计,可以在代码第一次运行时进行编译。初步基准测试显示性能提高了5-9%。
本研究提出了神经网络设计选择,对白内障手术进行了研究,并在三个语义分割任务中取得了强大的性能表现。通过处理类别不平衡问题,实现了在最稀有的工具类上的显着性能提高。代码和训练好的模型可在链接中找到。
本研究评估了使用基础模型的预训练知识作为FL模型初始化的教师对FL模型性能的影响。结果显示,在胸部X光肺分割任务中,FL模型初始化指导下的FL能更快收敛,并在复杂数据情境中提高性能。为FL中的模型初始化提供了新的视角。
该论文提出了一种新的方法,将数据集提炼的过程从传统的像素空间转移到潜变空间,以提高性能并降低时间和空间开销。通过使用预训练的通用自动编码器对潜变空间中的潜变编码进行编码,解决了高时间复杂度、高空间复杂度和低信息紧凑性的问题。
大型语言模型可以通过预测生成理由来解决复杂的推理任务。较小的模型在推理方面主要因为难以启动过程而失败,引导它们朝正确的方向发展可以使性能提高100%以上。
本文介绍了一种基于掩码图像建模的MAE-lite pre-training方法,用于轻量级ViTs的pre-training。通过与其他方法进行对比,分析了该方法的影响,并揭示了pre-trained模型在数据充足的下游任务中的重要作用。同时,开发了一种distillation策略来提高pre-trained representations,从而实现更好的性能。
本文评估了多种机器人任务中的学习和手工工程化表示方法,并从维度、可观测性和分离度三个方面进行评估。结果表明,这些方法可以显著提高性能,并挑战了控制机器人“好”表示的见解。
该论文提出了一种新的上下文多模态对齐(CAD)网络,通过引入无参数随机上下文块来确保空间级别上的稳健音频和视觉对齐,提出了一种用于动态音频和视觉对齐的预训练技术,以及引入了交叉注意机制来平衡语义级别上的音频和视觉信息。该 CAD 网络相对于现有方法平均性能提高了 9.4%,并且将该建议添加到现有方法中可以提高其性能,而不需要额外的复杂性要求。
该研究探讨了主题度量在态度分类中的有效性,发现主题度量优于情绪度量,可以提高高达18.95%的性能。情绪和主题度量的组合可以实现最佳性能,并且可以进一步解决仅依赖情绪以及主题度量低一致性得分的局限性。
该文介绍了一种名为RAILD的预测方法,能够学习未见实体和关系的表征,实验表明RAILD在知识图谱任务上性能显著提高。
本文提出了一种适配器方法,可在多个不同领域中提高性能,同时提供了推理时间算法来推出新领域的泛化性能,成本较低。
本文介绍了一种新的FSDB采样技术,用于水文时间序列预测中的分解模型,避免引入未来信息。在三个站点中,使用该技术的VMD-based混合模型的预测效果比目前最先进的采样技术提高了6.4%至28.8%不等。
该研究提出了一种利用少量演示数据协助深度强化学习代理的方法,并将其应用于机器人操作任务。实验结果表明,该方法相比仅使用强化学习或模仿学习训练代理的方法,取得了显著的性能提高,并且在模拟到现实世界的零样本情况下也能获得初步的成功。
该文介绍了一种名为LIGHT的多任务学习神经网络,能够同时输出建筑物的高度地图、边界框和分割掩码图,并通过门控交叉任务交互模块提高了特征交互的效率。实验结果表明,该网络在DFC2023数据集上表现出优越的性能,使多任务学习的性能显著提高了2.8% AP50和6.5% delta1。
该研究提出了一种神经和符号端到端强化学习架构,能够克服深度学习技术的局限性。该架构在视频游戏中表现出色,通过获得一组符号规则,性能比传统完全神经强化学习系统更好。
原型设计模式通过克隆现有对象来创建新的对象,避免了重复的对象创建过程,提高了性能。适用于创建过程复杂、成本较大、需要独立于产品创建、构成和表示、需要避免与产品类层次结构耦合的情况。示例代码展示了如何使用原型模式。
该论文介绍了一种新方法,通过多个语言模型实例的反复辩论和推理过程,改善语言响应的表现,特别是在数学和策略推理方面。该方法有望提高大型语言模型的性能和开拓语言生成和理解领域。
Docugami使用Redis Enterprise作为数据层,支持其生成AI系统的大型语言模型。使用Redis Enterprise后,Docugami看到了性能和可靠性的稳步提高。
完成下面两步后,将自动完成登录并继续当前操作。