小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
BEV 杀入具身智能:跨维把机器人数据带上 Scaling 快车道

Dexterity-BEV通过将多来源机器人数据统一到三维空间,解决了具身智能面临的数据混乱问题。这一方法对齐了视觉和动作,整合了时间差异,提升了模型的泛化能力,标志着具身智能从数据堆积阶段进入数据秩序阶段,为行业规模化奠定基础。

BEV 杀入具身智能:跨维把机器人数据带上 Scaling 快车道

量子位 量子位 · 2026-06-12T04:11:02Z
2700GB高质量数据,训出空间智能SOTA,背后秘诀全栈开源

蚂蚁灵波开源了2700GB的LingBot-Depth-Dataset数据集,包含300万对RGB-D数据,旨在解决机器人感知空间的挑战。该数据集涵盖多种真实场景,增强模型的泛化能力,推动具身智能的发展,减少对昂贵硬件的依赖。

2700GB高质量数据,训出空间智能SOTA,背后秘诀全栈开源

量子位 量子位 · 2026-03-31T05:53:04Z
你的模型在“作弊”吗?深度解析机器学习中“数据泄露”的隐蔽陷阱

本文讨论了机器学习中的数据泄露问题,包括目标泄露和训练-测试污染。数据泄露会导致模型在训练和测试集上表现良好,但在实际应用中失败,从而影响模型的泛化能力。研究表明,数据泄露在多个学科中普遍存在,因此需要严格审查数据处理过程以确保模型的可靠性。

你的模型在“作弊”吗?深度解析机器学习中“数据泄露”的隐蔽陷阱

Seraphineの小窝 Seraphineの小窝 · 2025-10-24T02:31:25Z
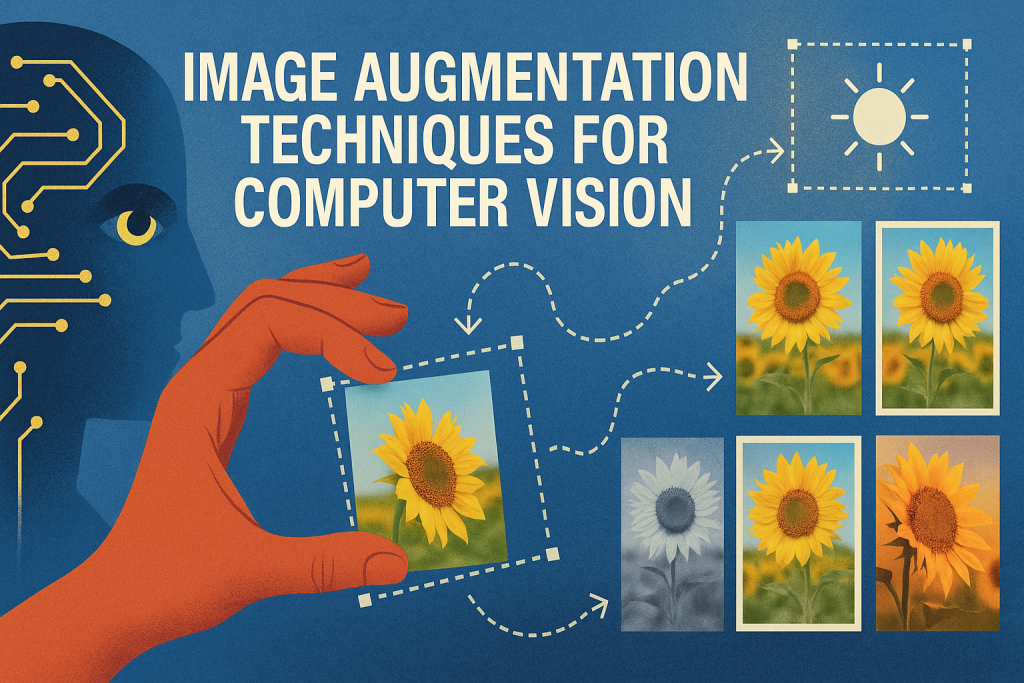
提升计算机视觉模型性能的图像增强技术

本文介绍了图像增强技术在计算机视觉中的应用,旨在提高模型的泛化能力和多样性。讨论了四种常见的增强策略:水平翻转、旋转、缩放和亮度调整,并提供了使用Keras API在Python中实现这些技术的示例。

提升计算机视觉模型性能的图像增强技术

MachineLearningMastery.com MachineLearningMastery.com · 2025-07-25T14:23:13Z

本研究提出了一种基于距离的加权机制,以解决半监督深度学习中有限标记数据的问题。该方法通过关注与测试数据接近的关键训练样本,提升模型的泛化能力和鲁棒性,实验结果表明在多个数据集上显著提高了分类性能。

Enhancing Semi-Supervised Deep Learning Classification with Distance-Based Sample Weights

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-20T00:00:00Z

本研究提出了一种新型神经网络架构——归一化组卷积模型(PoNG),旨在提升抽象视觉推理中的模型泛化能力。实验结果表明,该模型在多个基准测试中表现优异,超越了现有方法。

Enhancing Generalization in Various Abstract Visual Reasoning Tasks

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-19T00:00:00Z

本研究提出了一种新的频率适应与分散框架(FAD),有效解决跨域少样本学习中的显著分布转变问题。FAD通过频域建模提升模型的泛化能力,实验结果表明其在Meta-Dataset基准测试中优于现有方法。

FAD: Frequency Adaptation and Dispersion for Cross-Domain Few-Shot Learning

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-13T00:00:00Z

本研究提出了FedIFL框架,旨在解决电动系统故障诊断中的数据稀缺和标签不一致问题。通过原型对比学习和特征解耦机制,提升了模型的泛化能力,实现了准确的故障诊断。

FedIFL: A Federated Cross-Domain Diagnostic Framework for Motor-Driven Systems with Inconsistent Fault Modes

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-12T00:00:00Z

本研究提出了MergeGuard方法,旨在应对机器学习中的特洛伊攻击。通过线性化和合并全连接层,提升模型的泛化能力和性能。评估结果表明,该方法在降低攻击成功率的同时,保持了模型的准确性,优于常见的防御策略。

MergeGuard: An Efficient Defense Against Trojan Attacks in Machine Learning Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-06T00:00:00Z

本研究提出了一种过拟合-欠拟合指标(OUI),用于监测深度神经网络的训练过程,并识别最佳的正则化超参数。实验结果表明,OUI能够有效指导权重衰减超参数的选择,从而提升模型的泛化能力。

我们需要谈谈权重衰减:过拟合检测的新视角

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-24T00:00:00Z

本研究提出了一种名为AMAD的新方法,旨在解决无监督多变量时间序列异常检测中的模型泛化能力不足问题。该方法结合了自动掩蔽机制和注意力混合模块,取得了优异的表现。

AMAD:用于无监督多变量时间序列异常检测的自动掩蔽注意力机制

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-09T00:00:00Z

本研究提出EffOWT方法,旨在提升开放世界跟踪的模型泛化能力。该方法结合了Transformer和CNN结构,显著提高了跟踪性能,内存节省36.4%,跟踪精度提升5.5%。

EffOWT: Efficiently and Effectively Transferring Visual Language Models to Open-World Tracking

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-07T00:00:00Z

本研究探讨了改善假新闻检测模型泛化能力的特征,特别是应对粗略标记数据的偏差。通过分析风格特征和社会货币化特征,提出了一种新方法,增强模型在现实世界中的鲁棒性。研究表明,这些新特征能提供更具泛化性的预测,推动假新闻检测的进步。

Exploring Features to Improve the Generalization Ability of Fake News Detection Models

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-27T00:00:00Z

本研究提出了一种子任务导向强化微调(SoRFT)方法,以解决主流问题解决框架中的高成本和隐私问题。通过结构化子任务和强化学习,SoRFT显著提高了问题解决性能和模型的泛化能力。

Subtask-Oriented Reinforcement Fine-Tuning: A New Approach to Problem Solving

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-27T00:00:00Z

本文提出了一种基于代数的机器学习新基础,通过将任务目标和数据编码为代数公理,实现模型的泛化。实验结果表明,该方法在标准数据集上的性能与优化后的多层感知机相当,并可扩展至形式问题的求解。

Algebraic Machine Learning: Viewing Learning as the Algebraic Decomposition of a Task

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-27T00:00:00Z

本研究探讨了强化学习中稀疏与密集奖励的平衡问题,提出了一种基于幼儿启发的奖励转变方法,显著提高了学习性能和样本效率,增强了模型的泛化能力。

From Sparse to Dense: Reward Transition Inspired by Toddlers in Goal-Oriented Reinforcement Learning

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-29T00:00:00Z

本研究探讨了监督微调(SFT)与强化学习(RL)对模型泛化能力的影响,结果显示RL在未见变体上表现更佳,而SFT则容易记忆训练数据。尽管RL提升了泛化能力,SFT仍对有效的RL训练至关重要。

监督微调记忆,强化学习泛化:基础模型后训练的比较研究

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-28T00:00:00Z

本文提出了一种结合强化学习与对抗性学习的文本分类方法READ,旨在解决标注数据稀缺的问题。该方法通过生成多样化的合成文本,提升模型的泛化能力。实验结果表明,READ在多个数据集上表现优于现有方法。

Reinforcement Learning-Based Adversarial Learning for Text Classification with Limited Labeled Data

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-14T00:00:00Z

本研究提出了一种新框架“部分观测下重新启用 PDE 损失”(RPLPO),旨在在数据稀缺时有效利用偏微分方程损失。实验结果表明,RPLPO在观测数据稀疏的情况下显著提升了模型的泛化能力。

在部分观测下如何重新启用 PDE 损失以建模物理系统

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-12T00:00:00Z

本研究解决了时间序列分类中预训练数据集收集的问题,提出了一种新的对比精度指标来评估模型表示空间的质量。实验结果表明,该指标与下游任务的准确性正相关,有助于提升模型的泛化能力。

无标签测量时间序列基础模型的预训练数据质量

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-09T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码