小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate
通过Foundry,微软押注企业AI的竞争在于可靠性,而非能力

微软在Build 2026大会上发布了Microsoft Foundry的更新,旨在提升企业AI的可靠性和可管理性。新功能包括托管代理基础设施、评估工具和开放治理规范,支持开发者创建和管理智能代理。自适应评估框架和代理控制规范提高了代理的安全性和质量,同时引入多种记忆类型和知识源,增强了智能代理的功能和性能。

通过Foundry,微软押注企业AI的竞争在于可靠性,而非能力

The New Stack The New Stack · 2026-06-08T12:00:00Z
【公益译文】2026年AI指数报告(三)

AI模型在语言、推理、编码和数学等领域的能力迅速提升,评估工具的可靠性受到质疑。美国与中国的顶级模型差距缩小,竞争转向成本和实际应用价值。基准测试显示模型在特定领域表现不一,AI技术进步快于评估和治理,未来可能面临更多挑战。

【公益译文】2026年AI指数报告(三)

绿盟科技技术博客 绿盟科技技术博客 · 2026-06-03T12:43:18Z

谷歌DeepMind发布了一项新框架,旨在通过认知科学衡量人工通用智能(AGI)的进展。该框架识别了十种关键认知能力,并与Kaggle合作举办黑客马拉松,鼓励研究者设计评估工具,争夺20万美元奖金,评估内容涵盖学习、元认知和注意力等领域。

衡量人工通用智能(AGI)进展的认知框架

Google DeepMind Blog Google DeepMind Blog · 2026-03-17T16:03:47Z

人工通用智能(AGI)有望加速科学发现,但缺乏评估工具。新论文提出认知分类法,识别10种关键认知能力,并通过Kaggle黑客马拉松鼓励社区进行评估设计。这些能力包括学习、注意力和社交认知等。

朝向人工通用智能的进展测量:一个认知框架

The Keyword The Keyword · 2026-03-17T16:00:00Z

Google Stax是一个评估大型语言模型(LLM)的开发工具,旨在帮助开发者根据自定义标准测试模型和提示。它解决了传统评估方法的局限性,支持多种模型并提供数据驱动的决策依据。通过定义成功标准和比较不同模型,Stax使AI评估更加系统化,帮助开发者构建符合用户需求的AI产品。

Google Stax:根据自定义标准测试模型和提示

KDnuggets KDnuggets · 2026-03-09T16:00:18Z
蚂蚁具身研究首次亮相!就解决了机器人「看」透明玻璃这些难题,还开源了

AI Shortlist 是一款评估工具,旨在帮助用户快速筛选合适的人工智能解决方案,通过分析用户需求和市场产品提供个性化推荐。

蚂蚁具身研究首次亮相!就解决了机器人「看」透明玻璃这些难题,还开源了

机器之心 机器之心 · 2026-01-27T05:32:40Z
推出Agent Interop评估入门工具包

微软推出“Agent Interop评估”工具,帮助企业在真实环境中评估AI代理的性能。该工具提供可配置标准和真实场景,支持多种场景,便于比较不同代理的质量和效率,确保生产环境中的可靠性和透明度。

推出Agent Interop评估入门工具包

Microsoft 365 Developer Blog Microsoft 365 Developer Blog · 2026-01-26T17:37:21Z
合合信息多模态文本智能产品“上新”,覆盖AI教育、AI健康、AI Infra多元场景

AI Shortlist 是一款评估工具,旨在帮助用户快速筛选合适的人工智能解决方案,通过分析用户需求和市场产品提供个性化推荐。

合合信息多模态文本智能产品“上新”,覆盖AI教育、AI健康、AI Infra多元场景

机器之心 机器之心 · 2026-01-14T02:39:30Z
DeepTeam - 一个针对大型语言模型和LLM系统的开源红队框架,…

DeepTeam是一个针对大型语言模型的红队框架,旨在帮助研究人员识别安全和鲁棒性问题。它提供攻击策略、评估工具和可扩展的测试管道,以支持模型的安全性和质量评估,并促进社区的贡献。

DeepTeam - 一个针对大型语言模型和LLM系统的开源红队框架,…

云原生 云原生 · 2025-12-01T08:41:45Z
介绍Evalite:面向AI应用的TypeScript测试工具

Evalite是由Matt Pocock开发的TypeScript评估工具,专为AI应用设计,支持可重复评估和追踪。它提供丰富的输出和评分功能,帮助开发者高效调试,并支持本地开发和缓存AI SDK模型,获得用户积极反馈。该项目开源,旨在提升AI应用的评估效率和安全性。

介绍Evalite:面向AI应用的TypeScript测试工具

InfoQ InfoQ · 2025-11-29T08:00:00Z
Ai2的Olmo 3推动开源大型语言模型性能的极限

艾伦人工智能研究所推出了开源大型语言模型Olmo 3,包含三种变体,表现优异,支持开发者定制。团队提供预训练数据集和评估工具,以提升模型质量。

Ai2的Olmo 3推动开源大型语言模型性能的极限

The New Stack The New Stack · 2025-11-20T20:00:08Z
评估工具如何推动企业人工智能的下一个篇章

全球超过一百万家企业利用人工智能提升效率,但部分组织未能实现预期效果。OpenAI通过评估工具(evals)来衡量和改善AI系统的表现,确保其在特定业务环境中的有效性。评估过程包括明确目标、测试实际情况和持续改进,以帮助企业提高投资回报率。管理者需理解业务背景,制定适合自身需求的评估框架。

评估工具如何推动企业人工智能的下一个篇章

OpenAI OpenAI · 2025-11-19T11:00:00Z
为AI代理准确性构建定制化的LLM评估者

随着AI代理从原型转向生产,组织需确保质量并扩大评估流程。MLflow提供定制化的LLM评估工具,提升AI代理的质量与可靠性。新功能如可调评估者和自动评估工具,简化了开发与领域专家的协作,提高了评估效率。

为AI代理准确性构建定制化的LLM评估者

Databricks Databricks · 2025-11-04T20:00:57Z
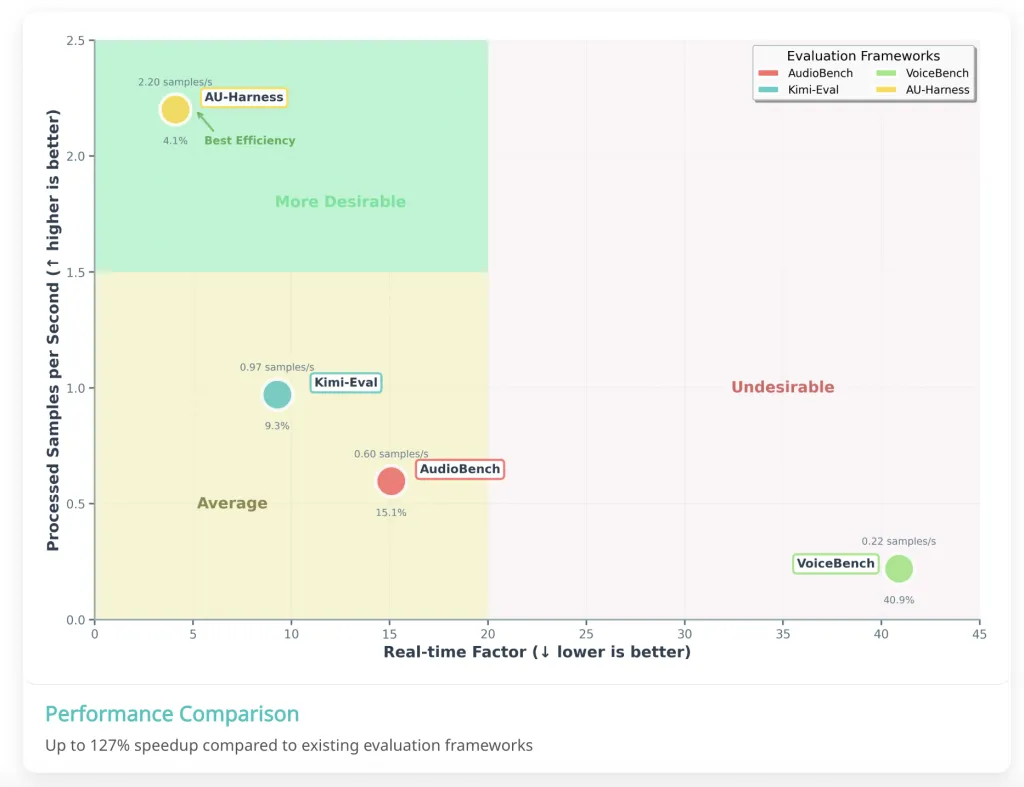
AU-Harness:用于音频 LLM 整体评估的开源工具包

德克萨斯大学与ServiceNow推出AU-Harness,旨在高效评估大型音频语言模型,支持多种任务,提升评估速度与灵活性,解决现有基准测试的不足。

AU-Harness:用于音频 LLM 整体评估的开源工具包

实时互动网 实时互动网 · 2025-09-15T02:45:26Z

Meta AI推出的Audiobox-Aesthetics音频质量评估工具,通过四个核心维度对语音、音乐和环境声音进行自动化分析,弥补了传统人工评估的不足,为音频创作者和研究人员提供专业的量化分析。

音频美学评估新范式!Audiobox-Aesthetics 首创四维音频量化;670 万个案例!Caselaw 解锁法律参考的合规蓝本

HyperAI超神经 HyperAI超神经 · 2025-07-28T03:57:02Z
SafeLine WAF与Cloudflare和ModSecurity的真实基准测试与数据

BlazeHTTP是一款用户友好的WAF保护评估工具,提供33669个样本,支持GUI和命令行,无需配置。它生成详细报告,评估检测率、误报率和准确性。与CloudFlare和ModSecurity比较,SafeLine在检测率和准确性上表现优异。

SafeLine WAF与Cloudflare和ModSecurity的真实基准测试与数据

DEV Community DEV Community · 2025-05-29T08:37:39Z

本文研究了如何通过热门视频游戏评估大型语言模型(LLMs)的表现,指出直接将LLMs投入游戏无法有效评估。引入lmgame-Bench作为评估工具,通过统一API和感知、记忆支持,成功区分不同模型能力,并发现强化学习在单一游戏上的表现可迁移至其他游戏和任务。

lmgame-Bench: How Well Do Large Language Models Perform in Games?

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-21T00:00:00Z

本研究提出了一种基于用户反馈的强化学习框架(RLUF),旨在优化大型语言模型(LLMs)。实验结果显示,该方法显著提升了正向反馈率,并为用户行为评估提供了有效工具。

Reinforcement Learning Based on User Feedback

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-20T00:00:00Z

本研究提出了一种代理系统错误分类法,解决了代理工作流中复杂追踪评估不足的问题。通过建立148个大型人类注释的追踪数据集(TRAIL),揭示了现代长上下文语言模型在追踪调试中的缺陷,强调了开发有效评估工具的重要性。

TRAIL: Trace Reasoning and Autonomous Issue Localization

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-13T00:00:00Z

本研究提出了NorEval,一个针对挪威生成语言模型的评估工具,填补了挪威语言基准评估的空白。该工具包含24个高质量数据集,涵盖多种任务,并提供灵活可复现的评估框架,对19个开源模型进行了基准测试。

NorEval:挪威语言理解与生成评估基准

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-04-10T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码