


通过检索增强双重指令微调(RA-DIT)提升检索增强生成(RAG)的有效性
内容提要
Meta的AI研究团队提出了一种名为RA-DIT的方法,通过双重微调提升大型语言模型的检索能力。该方法优化了预训练模型和检索器,使其在知识密集型和常识推理任务中表现优异,显著提高了模型的准确性和上下文意识。
延伸解读
RA-DIT 的双重微调机制
RA-DIT 的核心在于分别对语言模型和检索器进行微调。语言模型微调旨在最大化给定检索增强指令下正确答案的概率,而检索器微调则通过 LM-Supervised Retrieval (LSR) 方法,利用语言模型的反馈来优化检索结果,确保检索到的信息与查询更相关。这种双重优化使模型能更有效地利用外部知识。
评估结果与性能优势
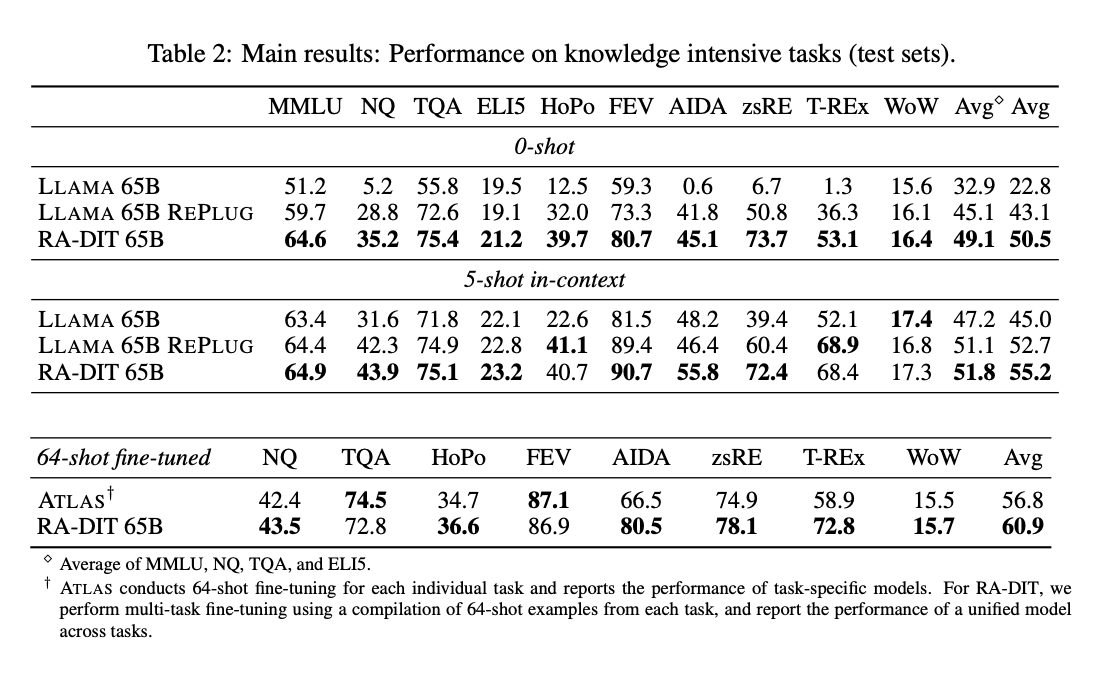
在知识密集型任务中,RA-DIT 65B 在 0-shot、5-shot 和 64-shot 设置下均表现优异,平均 EM 得分分别为 50.5、55.2 和 60.9,超越 LLAMA 65B REPLUG 和 ATLAS 等模型。在常识推理任务中,RA-DIT 在 8 个数据集中的 7 个上优于基础 LLAMA 65B,表明其参数化知识和推理能力得以保留。
实际应用与实现参考
文章提供了基于 LlamaIndex 的实现示例,包括生成微调数据集、微调语言模型和检索器的步骤。开发者可参考该实现来构建自己的检索增强生成系统。RA-DIT 方法为提升 LLM 在知识密集型任务中的表现提供了一种结构化途径,且无需对模型进行昂贵的预训练修改。
Q&A
RA-DIT方法的主要目标是什么?
RA-DIT方法的主要目标是通过双重微调提升大型语言模型的检索能力,从而提高模型在知识密集型和常识推理任务中的表现。
RA-DIT方法是如何进行微调的?
RA-DIT方法包括两个微调步骤:更新预训练语言模型以更好地利用检索信息,以及更新检索器以返回更相关的结果。
RA-DIT在知识密集型任务中的表现如何?
在知识密集型任务中,RA-DIT 65B模型在多个评估中表现优异,超越了其他模型,显示出其强大的能力。
RA-DIT方法如何提高模型的上下文意识?
RA-DIT方法通过生成微调数据集,增强语言模型利用知识的能力,从而提高其在生成预测时的上下文意识。
RA-DIT方法与其他模型相比有什么优势?
RA-DIT方法通过双重微调和高效的数据检索过程,显著提高了模型的准确性和上下文意识,超越了未调优的模型如REPLUG。
RA-DIT方法的评估是基于哪些数据集的?
RA-DIT方法的评估基于知识密集型任务和常识推理任务的数据集,包括MMLU、Natural Questions、BoolQ等。
