


混合搜索与重排序
内容提要
本教程介绍在 Qdrant 中构建混合搜索并结合重排序:使用稠密嵌入进行语义搜索、稀疏 BM25 进行关键词搜索,再用 ColBERT 后期交互模型对候选结果重排序。数据以三种嵌入存入集合,检索时并行预取稠密与稀疏结果,最后用多向量模型精排,可显著提升相关性,但需权衡成本与延迟。
延伸解读
重排序如何提升混合搜索精度
文章指出,混合搜索通过稠密与稀疏检索扩大召回,但RRF融合默认平等对待两路信号,可能让关键词匹配强但语义无关的结果排名靠前,例如“Station Eleven”因包含“traveling”而进入前列。引入ColBERT后期交互模型对候选集重排序后,能捕捉词级交互,使真正相关的书籍排名上升。对比显示,重排序后前五名均与时间旅行高度相关,而RRF结果中混入了仅关键词匹配的条目。
三向量存储与检索流程解析
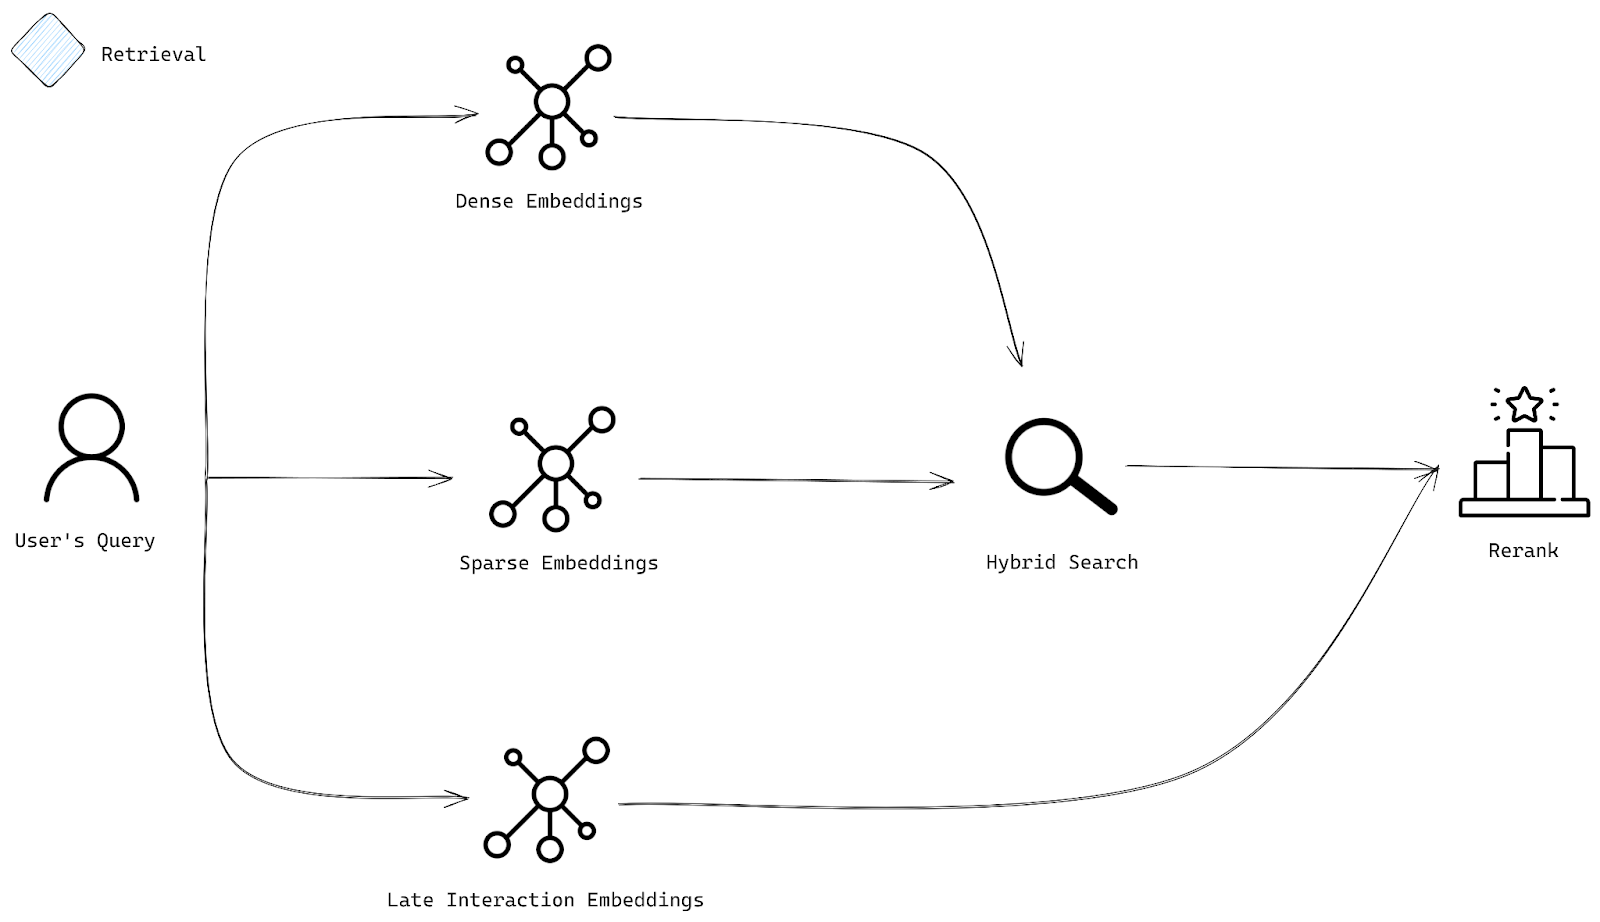
教程在Qdrant集合中为每个文档存储三种向量:384维稠密向量用于语义搜索,稀疏BM25向量用于关键词匹配,96维多向量ColBERT用于重排序。检索时并行预取稠密和稀疏结果各20条,再分别用RRF融合或ColBERT重排序。注意多向量配置中设置m=0以禁用HNSW索引,因为该向量仅用于重排序而非ANN检索,这有助于节省索引开销。
成本与延迟的权衡建议
文章提醒,后期交互模型计算成本较高且需要显著存储空间。最佳实践包括持续测试和监控以避免过拟合,并在相关性与成本间取得平衡。对于许多场景,简单的RRF融合已足够有效;仅当查询对精度要求极高时,才值得启用ColBERT重排序。由于重排序只作用于预筛选的小候选集,因此能在保持速度的同时提升相关性。
Q&A
混合搜索和重排序分别解决什么问题?
混合搜索通过稠密和稀疏嵌入同时进行语义和关键词检索,扩大召回范围;重排序则对初步检索到的候选结果用更精细的模型(如ColBERT后期交互)重新排序,提升精度。两者结合能在保持低延迟的同时提高相关性。
在Qdrant中实现混合搜索需要哪些嵌入模型?
需要三种嵌入模型:稠密嵌入(如sentence-transformers/all-MiniLM-L6-v2)用于语义搜索,稀疏嵌入(如qdrant/bm25)用于关键词搜索,后期交互嵌入(如answerdotai/answerai-colbert-small-v1)用于重排序。
混合搜索的检索流程是怎样的?
用户查询被转换为稠密、稀疏和后期交互三种嵌入。然后并行执行稠密和稀疏检索,各取前20个候选,再用RRF融合或直接用后期交互模型重排序,最终返回前10个结果。
重排序相比RRF融合有什么优势?
RRF融合平等对待稠密和稀疏信号,可能无法捕捉查询与文档词项的细微交互。而后期交互模型(如ColBERT)能进行更细粒度的词级匹配,从而更精准地排序,提升相关性。
使用重排序时需要注意哪些成本或延迟问题?
重排序计算成本较高,后期交互嵌入需要大量存储。建议在相关性和成本之间平衡:简单融合方法如RRF适用于许多场景,而后期交互模型可保留给对精度要求高的查询。
在Qdrant中如何配置集合以支持混合搜索和重排序?
创建集合时需定义三个向量:稠密向量(如384维,余弦距离)、多向量(如96维,余弦距离,使用最大相似度比较器,并设置m=0禁用HNSW索引)、稀疏向量(使用IDF修饰符)。
