小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
机器人视觉迎来新突破!蚂蚁灵波空间感知模型LingBot-Depth 2.0正式发布

蚂蚁集团旗下的灵波科技发布了空间感知模型LingBot-Depth 2.0,该模型基于1.5亿数据训练,显著提升了深度估计和物体识别能力,尤其在透明和反光物体的识别上表现优异。同时,灵波推出了视觉基座模型LingBot-Vision,增强了机器人视觉能力。这两者的结合将推动机器人技术的商业化应用,助力行业发展。

机器人视觉迎来新突破!蚂蚁灵波空间感知模型LingBot-Depth 2.0正式发布

量子位 量子位 · 2026-07-07T03:35:02Z
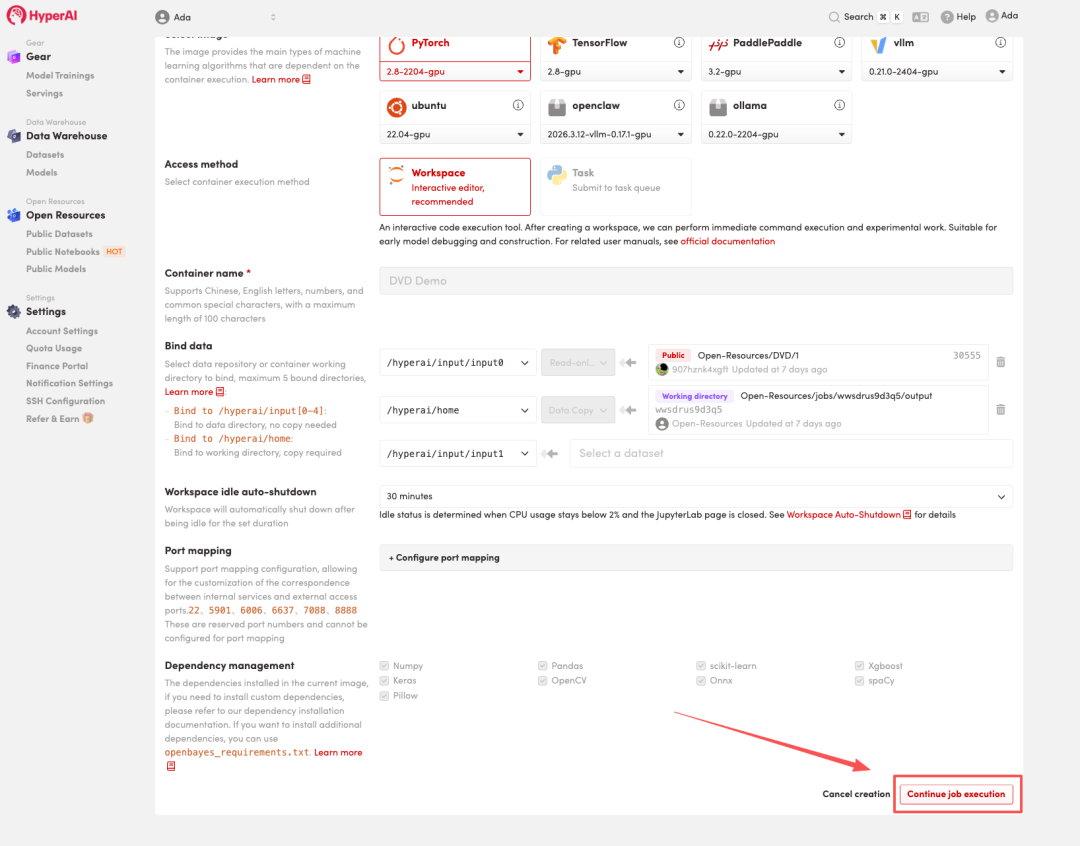
在线教程丨香港科技大学团队开源首个确定性视频深度框架DVD,零样本刷新 SOTA

香港科技大学(广州)团队提出的DVD模型通过一次前向传播实现视频深度估计,提升了推理效率,解决了几何幻觉问题。该模型在多个基准测试中表现优异,仅需36.7万帧训练数据,显著降低了成本,为视频三维感知提供了新技术路线。

在线教程丨香港科技大学团队开源首个确定性视频深度框架DVD,零样本刷新 SOTA

HyperAI超神经 HyperAI超神经 · 2026-06-18T06:45:41Z
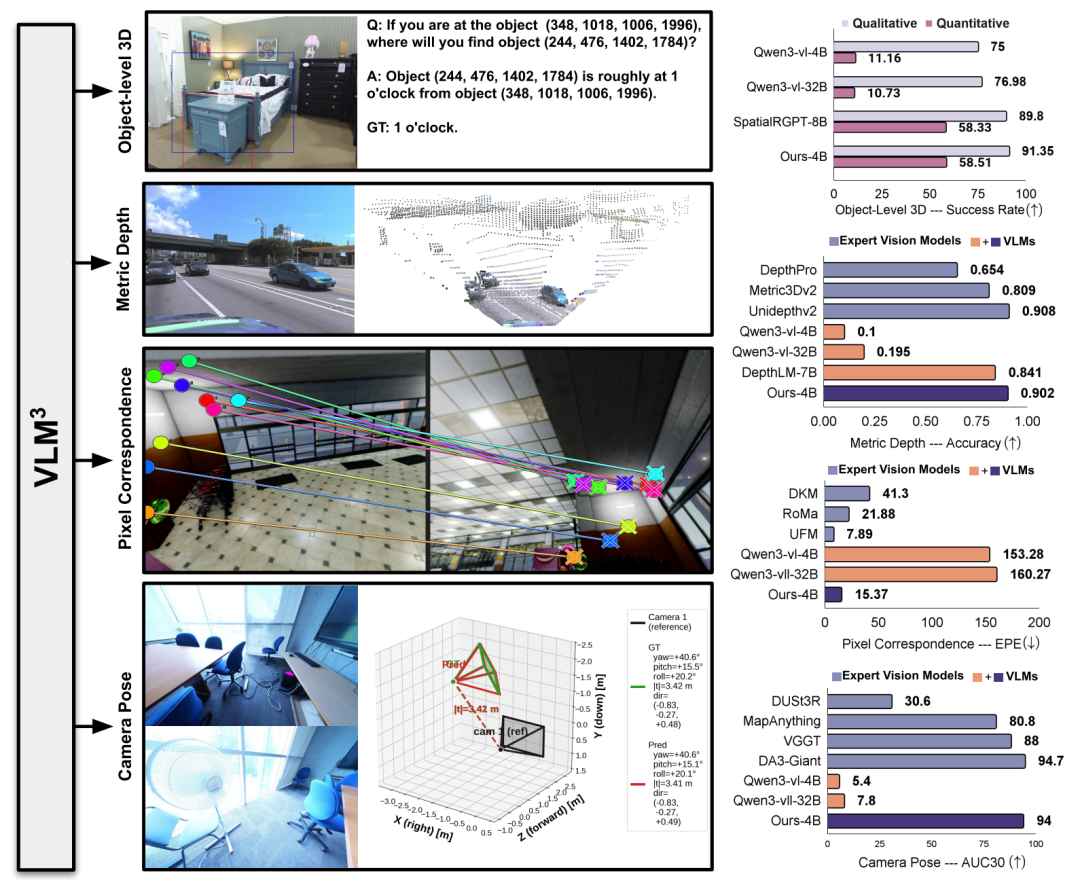
深度估计准确率冲上0.9,Meta提出VLM³,论证视觉模型天生会学3D,以Qwen3-VL-4B为基础实现多任务的统一建模

三维空间感知是自动驾驶和机器人领域的核心能力,旨在从二维图像恢复真实世界的空间结构。Meta与普林斯顿大学提出的VLM³框架,基于标准视觉语言模型,统一了物体级三维理解和公制深度估计等任务,显著提升了模型在细粒度三维感知中的表现。研究表明,通用视觉语言模型在三维表征能力上超出预期,为三维视觉领域的统一基础模型提供了新依据。

深度估计准确率冲上0.9,Meta提出VLM³,论证视觉模型天生会学3D,以Qwen3-VL-4B为基础实现多任务的统一建模

HyperAI超神经 HyperAI超神经 · 2026-06-08T08:06:39Z
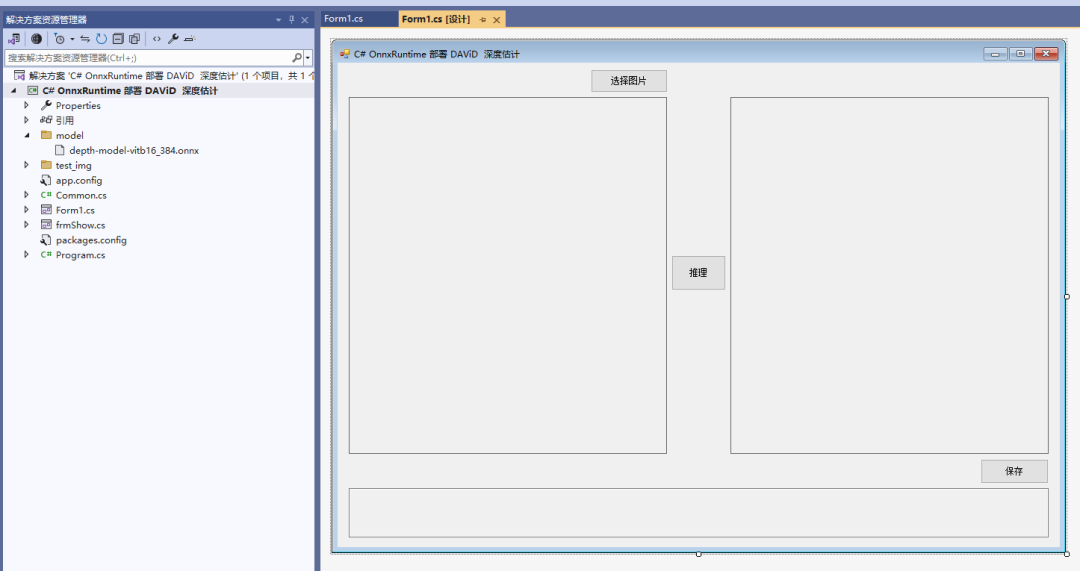
C# OnnxRuntime 部署 DAViD 深度估计

本文介绍了一个深度估计模型的实现,使用Microsoft.ML.OnnxRuntime和OpenCvSharp库。用户可以选择图片进行深度推理,程序处理图像并生成深度彩色图,支持保存结果。详细说明了模型路径和输入输出张量的设置。

C# OnnxRuntime 部署 DAViD 深度估计

dotNET跨平台 dotNET跨平台 · 2026-04-20T23:57:27Z
三维视觉新突破:字节Seed推出DA3,实现任意视角重建视觉空间;7w+真实工业环境数据!CHIP 填补 6D姿态估计工业数据空白

字节跳动的Depth Anything 3(DA3)模型通过单一Transformer实现深度和姿态估计,简化了三维视觉任务的处理,并刷新了多项基准测试记录。

三维视觉新突破:字节Seed推出DA3,实现任意视角重建视觉空间;7w+真实工业环境数据!CHIP 填补 6D姿态估计工业数据空白

HyperAI超神经 HyperAI超神经 · 2025-12-23T06:09:54Z
三维视觉新突破:字节Seed推出DA3,实现任意视角重建视觉空间;7w+真实工业环境数据!CHIP填补6D姿态估计工业数据空白

Depth Anything 3(DA3)是字节跳动Seed团队推出的视觉几何模型,采用单一Transformer架构,简化多任务学习,能够从任意视角预测空间几何结构。实验表明,DA3在相机姿态和深度估计任务中表现优异,刷新多项性能记录。

三维视觉新突破:字节Seed推出DA3,实现任意视角重建视觉空间;7w+真实工业环境数据!CHIP填补6D姿态估计工业数据空白

HyperAI超神经 HyperAI超神经 · 2025-12-22T12:54:37Z

本研究提出了JointDiT模型,通过扩散变换器增强RGB和深度的联合建模。采用自适应调度权重和不平衡时间步采样策略,JointDiT显著提升了图像生成和深度估计的性能,展现了在多种生成任务中的应用潜力。

JointDiT: Enhancing RGB-Depth Joint Modeling with Diffusion Transformers

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-05-01T00:00:00Z

该研究提出DFI-OmniStereo,一种新型全向立体匹配方法,利用预训练模型提升深度估计准确性。在不同环境和光照条件下表现优异,在Helvipad数据集上均方根误差降低约16%。

Boosting Omnidirectional Stereo Matching with a Pre-trained Depth Foundation Model

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-30T00:00:00Z
实时无人机视觉系统以111 FPS处理空中图像,同时识别物体和距离

Co-SemDepth是一种实时系统,能够同时进行语义分割和深度估计,处理速度达到111 FPS。该系统在NVIDIA Jetson Orin AGX上运行,采用共享编码器和特定任务解码器,显著提升了计算效率,超越了单任务模型。

实时无人机视觉系统以111 FPS处理空中图像,同时识别物体和距离

DEV Community DEV Community · 2025-03-27T10:16:40Z
UniVG:一种用于统一图像生成与编辑的通用扩散模型

UniVG是一种通用图像生成扩散模型,支持多种任务如图像生成、修复和编辑。它将多模态输入视为统一条件,研究表明T2I生成与其他任务共存且无性能损失,辅助任务如深度估计可提升编辑效果。该模型在某些基准测试中超越特定任务模型,标志着统一图像生成的重要进展。

UniVG:一种用于统一图像生成与编辑的通用扩散模型

Apple Machine Learning Research Apple Machine Learning Research · 2025-03-24T00:00:00Z

本研究提出了Endo3DAC框架,旨在提高内窥镜三维场景重建中的自监督学习效率。通过冻结基础模型并训练新设计的GDV-LoRA,显著提升了深度和姿态估计的准确性,同时保持训练效率。

Learning to Efficiently Adapt Foundation Models for Self-Supervised Endoscopic 3D Scene Reconstruction

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-20T00:00:00Z

本研究提出了一种新型卷积神经网络USAM-Net,通过结合立体图像和语义分割图,提升自动驾驶和增强现实中的深度估计精度。实验结果表明,USAM-Net在多个指标上优于传统模型,显示出其在高精度深度数据需求中的潜力。

USAM-Net: A U-Net Based Network for Improving Stereo Matching and Scene Depth Estimation through Pre-trained Image Segmentation Networks

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-03-19T00:00:00Z

地瓜机器人与中科院合作提出MODEST框架,通过单张RGB图像实现透明物体的深度估计和语义分割,显著提升抓取精度并降低成本。该技术已入选ICRA 2025,适用于智能工厂等场景。

透明物体也能被机器人抓起来了,单目的那种 | ICRA 2025

量子位 量子位 · 2025-03-05T07:23:32Z

本研究提出了一种新框架,利用深度卷积神经网络的潜在空间特征,解决单目深度估计中的边界定义问题。新损失函数在NYU Depth V2数据集上设立了新基准,特别适用于复杂室内场景,推动了人机交互和3D重建应用的发展。

Accurate Depth Estimation Based on Latent Space Features of Deep Neural Networks

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-02-17T00:00:00Z
人工智能系统采用双分支架构为内窥镜图像添加深度感知

该研究提出了一种新颖的双分支架构MetaFE-DE,用于内窥镜图像的深度估计。该方法结合全局和局部特征提取,在深度估计基准测试中表现优异,帮助外科医生更好地理解手术中的三维结构。

人工智能系统采用双分支架构为内窥镜图像添加深度感知

DEV Community DEV Community · 2025-02-08T06:56:30Z

本文综述了深度估计领域,重点讨论深度学习方法如何解决传统技术的泛化能力不足。研究整合了多种深度学习模型和数据集,结果表明深度学习在深度估计中展现出巨大潜力。

基于深度学习的深度估计系统文献综述

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-09T00:00:00Z

本研究探讨了单眼深度估计模型在相对姿态估计中的应用不足,提出三种求解器,结合经典方法显著提升了深度估计效果。实验结果表明,该方法在不同条件下优于传统解决方案。

Relative Pose Estimation through Affine Corrections of Monocular Depth Priors

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-09T00:00:00Z

本研究提出了一种深度适应任何相机(DAC)框架,旨在解决鱼眼和360度相机的深度估计问题。DAC通过统一图像表示,提高了多种视场相机的准确性,实现了零样本度量的深度估计。

Depth Adaptation for Any Camera: Zero-Shot Metric Depth Estimation Based on Any Camera

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2025-01-05T00:00:00Z

该研究提出了一种名为V$^2$-SfMLearner的新方法,结合振动信号与视觉信号,以提高胶囊内窥镜视频中的深度和运动估计准确性,有效消除振动干扰,提升消化系统检查的实时性和可靠性。

V$^2$-SfMLearner: Learning Monocular Depth and Ego-motion for Multimodal Wireless Capsule Endoscopy

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-23T00:00:00Z

本研究探讨跨视角补全学习,填补自监督对应学习的分析空白。研究发现,跨注意力图能更有效地捕捉对应关系,并在零-shot 匹配和多帧深度估计中表现优异,显示出良好的应用潜力。

Cross-Perspective Completion Models as Zero-Shot Correspondence Estimators

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-12-12T00:00:00Z
  • <<
  • <
  • 1 (current)
  • 2
  • 3
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码