
Microsoft AI 推出 SCBench:用于评估大型语言模型中长上下文方法的综合基准
内容提要
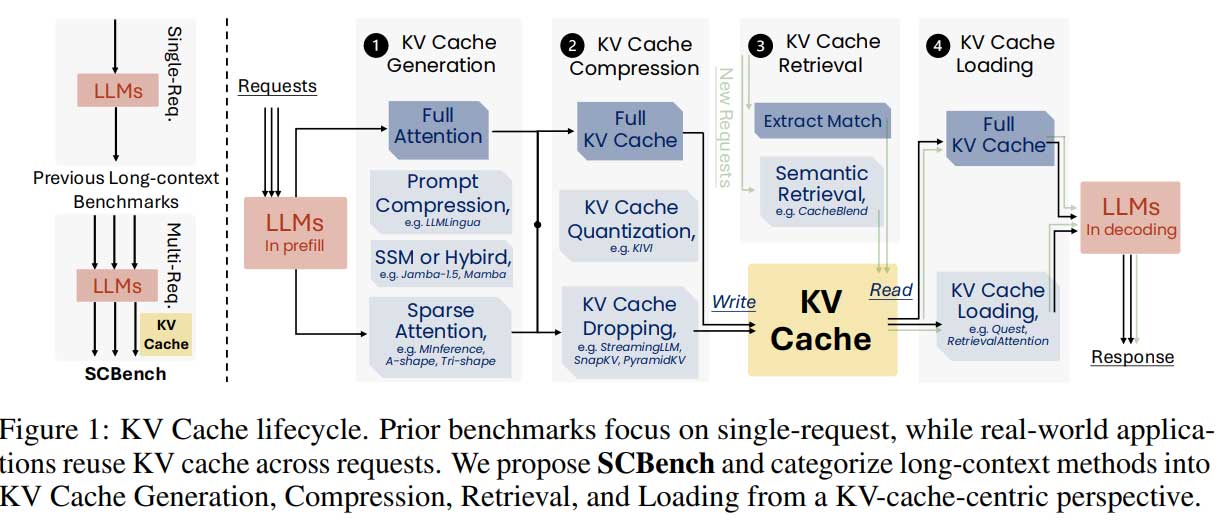
长上下文 LLM 在推理时面临计算和内存挑战。研究者推出 SCBench 基准测试,评估 KV 缓存的生成、压缩、检索和加载四个阶段,分析多轮交互中的性能。结果表明,O(n) 方法在多轮场景中表现优异,而 sub-O(n) 方法效果不佳,强调了评估长上下文方法的关键差距。
延伸解读
长上下文 LLM 的应用前景
长上下文 LLM 的扩展能力使其在复杂应用中具有广泛前景,如长文档问答和代码分析。然而,推理过程中的计算和内存挑战仍需解决,特别是在多轮交互场景中。SCBench 基准测试的推出,正是为了填补这一评估空白,帮助研究者更好地理解和优化这些模型的性能。
KV 缓存优化的重要性
KV 缓存的优化在长上下文 LLM 中至关重要,尤其是在多轮交互中。SCBench 通过分析 KV 缓存的生成、压缩、检索和加载四个阶段,揭示了不同方法在性能上的差异。研究表明,O(n) 方法在多轮场景中表现优异,而 sub-O(n) 方法则存在明显不足,提示开发者在选择技术时需谨慎。
评估方法的局限性
传统的评估方法往往侧重于单轮交互,忽视了多轮共享上下文的实际应用场景。SCBench 的引入为研究者提供了新的视角,强调了在多轮任务中评估长上下文 LLM 的必要性。这一变化可能会推动更符合实际需求的技术发展,提升模型在真实世界中的应用效果。
Q&A
SCBench 基准测试的主要目的是什么?
SCBench 基准测试旨在评估大型语言模型中长上下文方法的性能,特别是 KV 缓存的生成、压缩、检索和加载四个阶段。
长上下文 LLM 在推理过程中面临哪些挑战?
长上下文 LLM 在推理过程中面临计算效率和内存使用的挑战,尤其是在多轮交互中。
O(n) 和 sub-O(n) 方法在多轮场景中的表现如何?
研究结果显示,O(n) 方法在多轮场景中表现优异,而 sub-O(n) 方法效果不佳。
SCBench 基准测试评估了哪些任务?
SCBench 基准测试评估了 12 个任务,包括字符串和语义检索、多任务处理和全局处理。
哪些技术被用于优化长上下文 LLM 的推理?
用于优化长上下文 LLM 推理的技术包括稀疏注意、线性注意和快速压缩等预填充优化。
SCBench 如何分析 KV 缓存的生命周期?
SCBench 从生成、压缩、检索和加载四个阶段分析 KV 缓存的生命周期,以评估长上下文方法。
