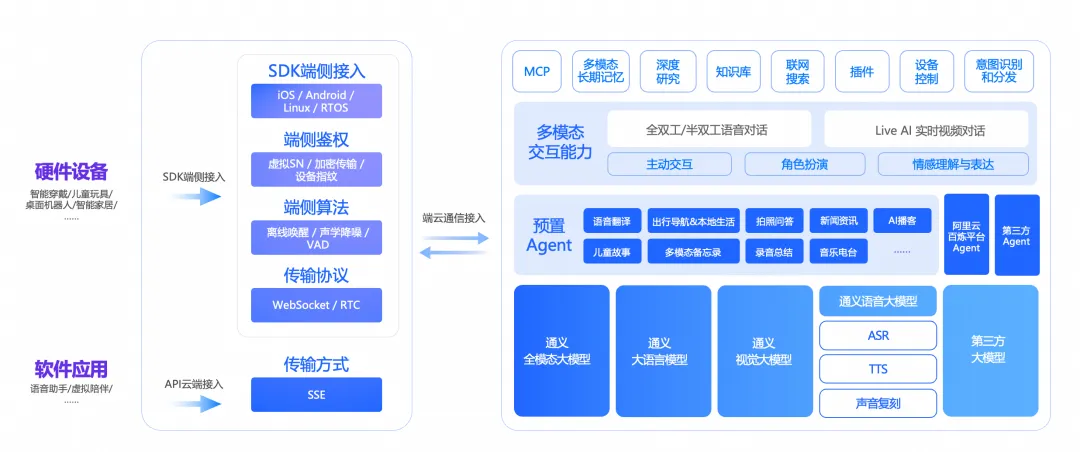
阿里云百炼多模态实时交互套件升级至Qwen-Audio-3.1,面向AI眼镜、学习机、汽车、机器人等硬件提供级联式语音交互方案。ASR支持30种语言、16种中文方言及热词识别,首字响应约160毫秒;TTS支持跨语言同音色与情绪语速调节,Elo评分全球第一。套件端到端延迟最低1秒,一套SDK适配30多个硬件平台,TTS降价约70%、ASR降价95%,并提供设备管理与运营能力。
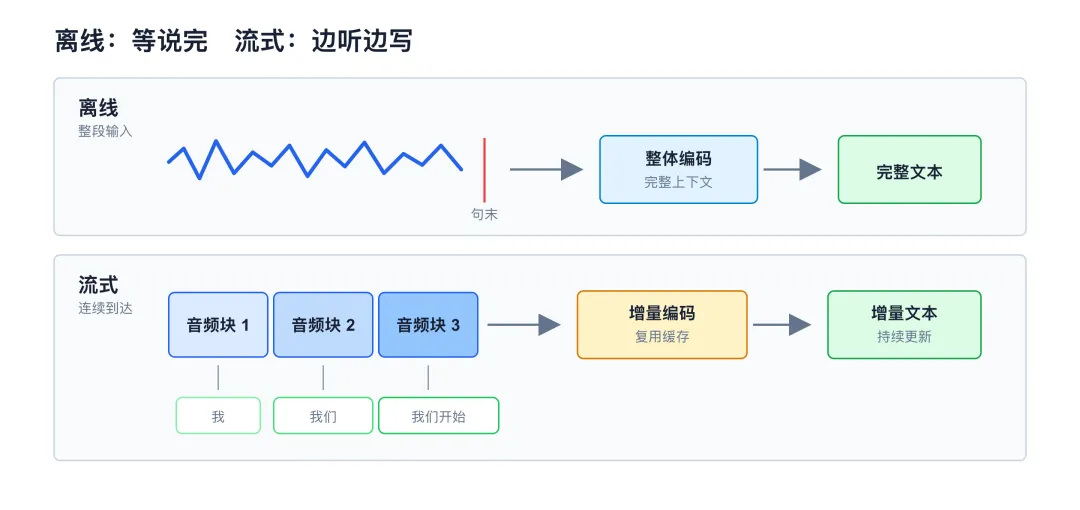
流式ASR需在音频未完整时持续输出,核心矛盾是准确率与延迟的权衡。文章梳理其定义与三类实现,说明交互、长音频、端侧和流水线并行等需求;回顾Hybrid逐帧解码、CTC、RNN-T、单调注意力等路线,以及大模型时代的分块化、交错生成、读写策略和延迟建模。评价应同时看准确率、发射稳定、效率与回改,并按场景选择路线。
阿布扎比TII发布Falcon-ASR,1.6B参数阿拉伯语语音识别模型,聚焦阿联酋方言,兼支持英语、法语、西语、葡语,共用一套权重并输出词级时间戳。TII自测6个阿拉伯语测试集平均WER 20.92%,领先Audar-ASR-V1-Turbo 2.25个百分点;阿联酋方言WER 22.73%,优于Qwen3-Omni等。英语平均WER 5.74%。但未开放权重、许可证和API,仅提供Demo体验,分数均为自报。
半监督联邦ASR因伪标签误差累积易发散。关键在教师与锚点耦合设计:每客户端在线教师稳定后可媲美或超越全局教师,种子增强后过渡教师更优;服务器需在轮次间持续用标注数据训练以稳定在线教师。该方案在11组中9组超越先前最佳,域内平均提升20.8%,跨域10.0%。
阿里发布Qwen-Audio-3.1系列五款语音模型,覆盖识别、合成、实时交互与音频创作,全线降价:TTS降约70%、Realtime降约85%、ASR降95%。ASR支持30种语言和16种中文方言,新增润色与分角色转写;ASR-Next可理解情绪与环境声;TTS支持跨语言音色合成;TTS-Next统一生成人声、音效与环境声;Realtime实现全双工交互并可调用工具。
2026年9月17日,ZEGO云端实时语音识别发布v2.4.0,新增支持Qwen-Audio-3.0-ASR-Flash-Streaming模型,可配置热词,支持中文、英语、日语等语种,通过ASR参数设置厂商、语种和模型;同时下架qwen3-asr-flash-realtime模型,原用户后续将被替换为新模型。
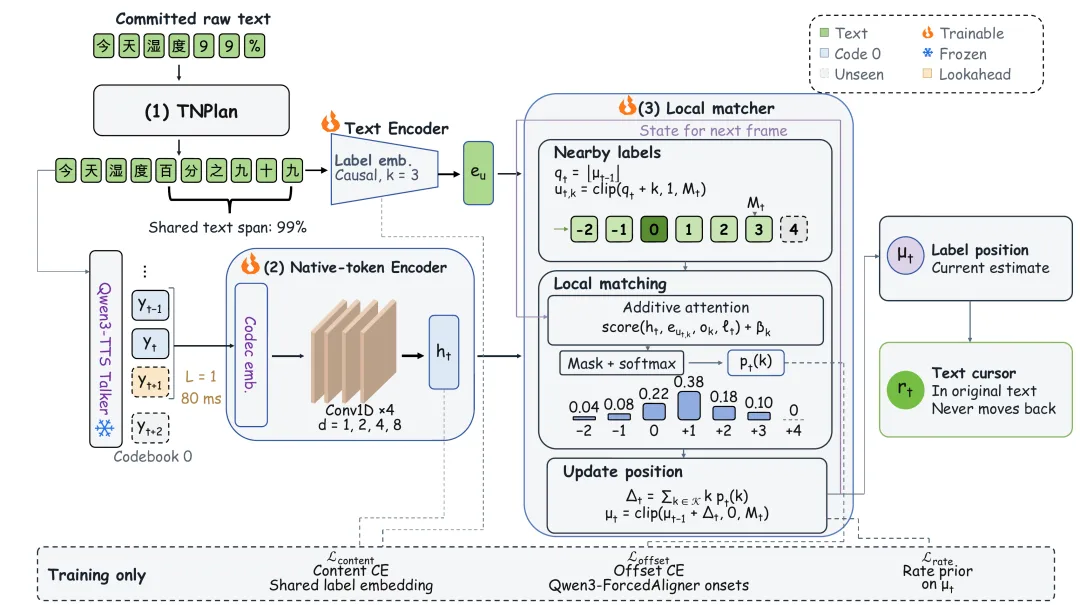
自变量机器人提出X2-NativeCursor,用约2M参数进度模型直接从TTS原生语音token估计原文位置,无需ASR或波形对齐。结合播放时钟确定播报进度,支持打断后续读、字幕高亮等。中文位置误差低于在线基线,RTF从0.36降至0.018,并可适配CosyVoice2等不同TTS。
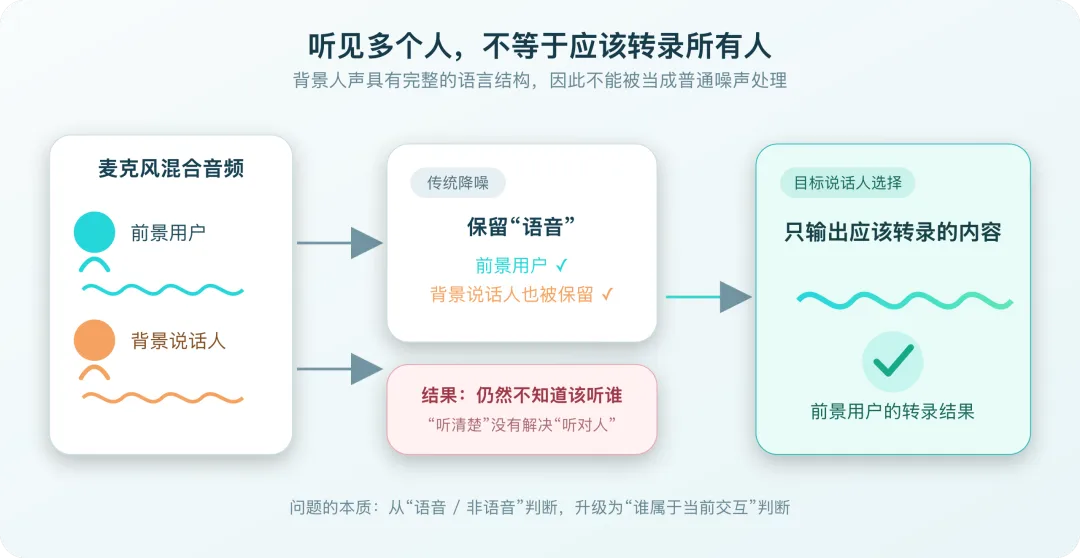
本文探讨语音识别在多人环境中“听对人”的挑战,即区分用户与背景人声。对比两种技术路线:基于身份注册的Target-Speaker ASR和基于场景线索的前景说话人转录,强调数据构造需明确时间、能量、空间关系,模型应学会选择交互主体而非单纯降噪,推动ASR从内容识别走向场景理解。
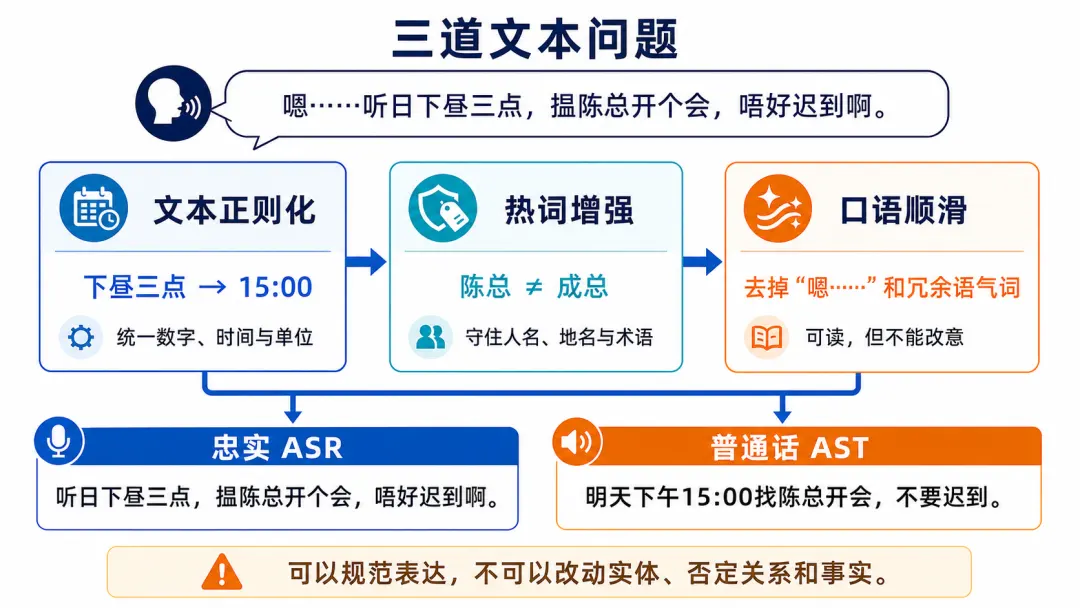
方言语音识别不仅需听清发音,还需决定如何书写。难点分三层:声音、词汇语法和书写。大模型能提升能力,但需区分忠实转写与方言转普通话两种任务,并处理文本正则化、热词增强和口语顺滑。系统应分层建模,分别评价,以尊重方言原貌并满足不同场景需求。
ZEGO实时互动AI Agent 2.14.0版本发布,新增Microsoft ASR供应商、获取AI语音播报文本内容PlayedText、对讲机模式与聆听模式支持取消聆听,以及基于Server Secret加密APIKey等功能。
Superwhisper发布S1系列,其中S1-mini为开源0.6B文本规范化模型,基于Qwen3微调,将ASR转录转为整洁文本,支持风格、结构、上下文三轴控制。Q4量化仅462MB,可本地部署。需关闭思考模式并贪心解码,测试token准确率94.8%。云端S1-Voice和S1-Language提供转录与格式化服务。
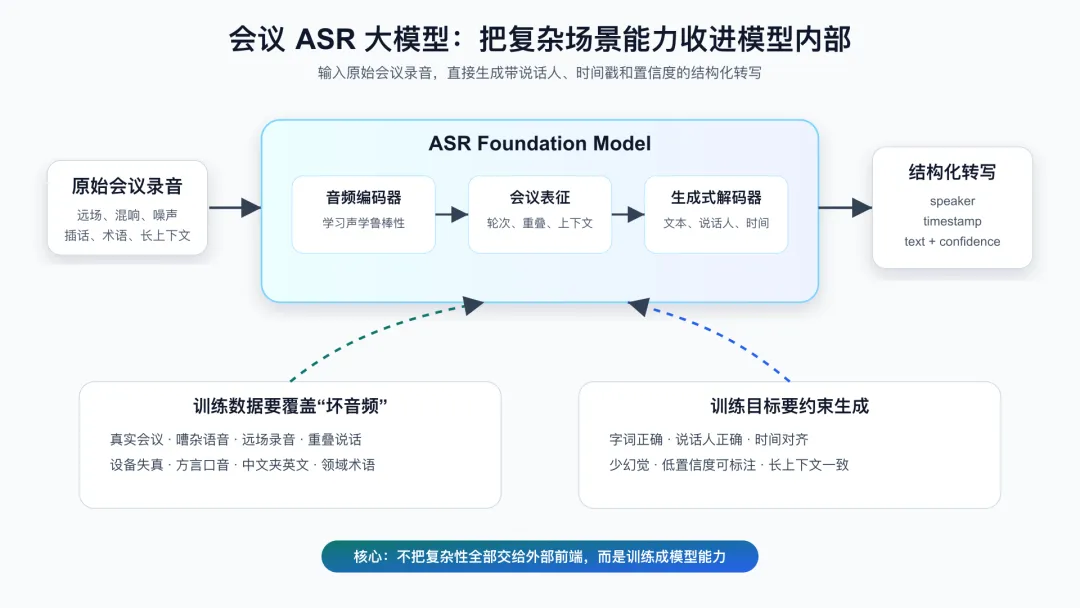
会议ASR大模型需直接处理真实会议中的远场、混响、噪声、重叠说话及术语等复杂情况,而非依赖外部前端。模型应内生声学鲁棒性、多说话人结构、长上下文理解和克制生成能力,输出含说话人、时间戳的结构化记录,以支撑摘要、问答等上层应用,减少误差传播。
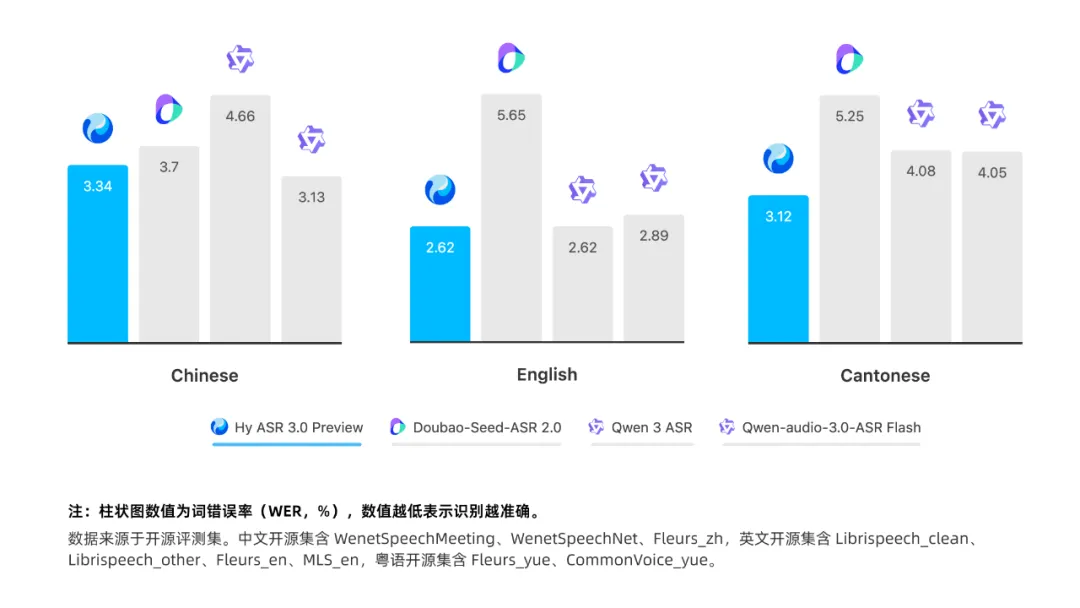
腾讯发布新一代语音识别模型Hy ASR 3.0 preview,基于大语言模型Hy3,融合高精度识别与语义理解,在通用识别、方言、上下文感知等维度提升。在开源和自建评测中WER领先,中文普通话3.34%、英语2.62%、粤语3.12%。已上线腾讯云API,元宝App免费体验。
腾讯混元发布新一代语音识别模型Hy ASR 3.0 preview,基于Hy3大模型提升通用识别、方言覆盖、上下文理解及复杂环境鲁棒性,在开源和自建评测中WER表现领先。支持热词注入,适配专业场景,已上线腾讯云API,并集成于元宝App,免费提供语音输入服务。
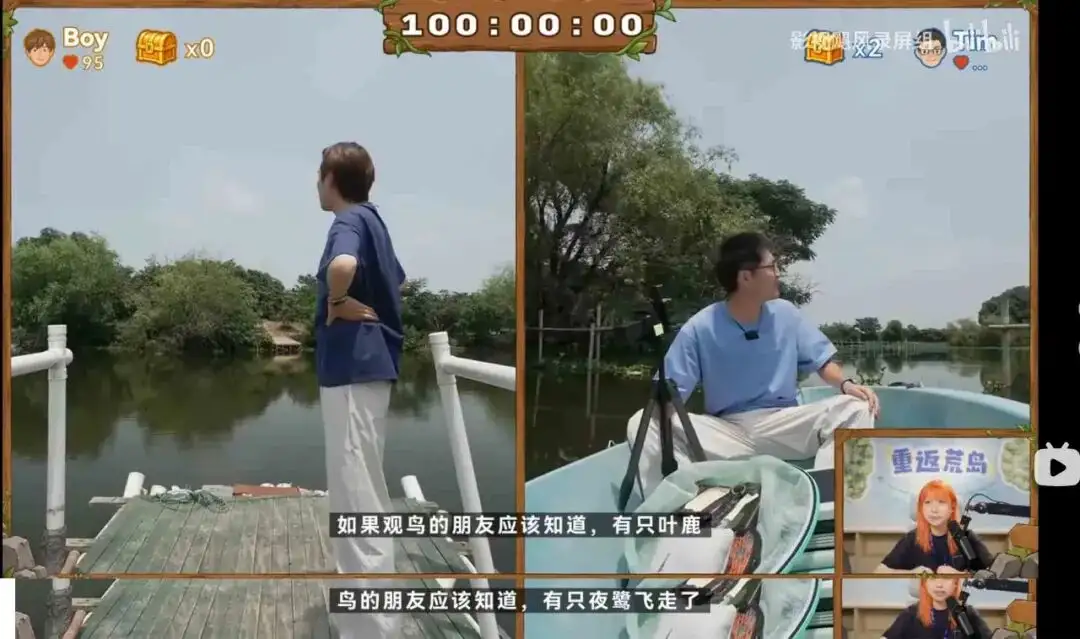
阿里通义推出了实时语音识别模型Fun-ASR-Realtime,具备百毫秒首字延迟和高准确率,支持16种方言和30种语言。在“重返荒岛”直播中,该模型提供实时字幕,识别准确率接近离线模型,适用于国际会议和客服等复杂场景。
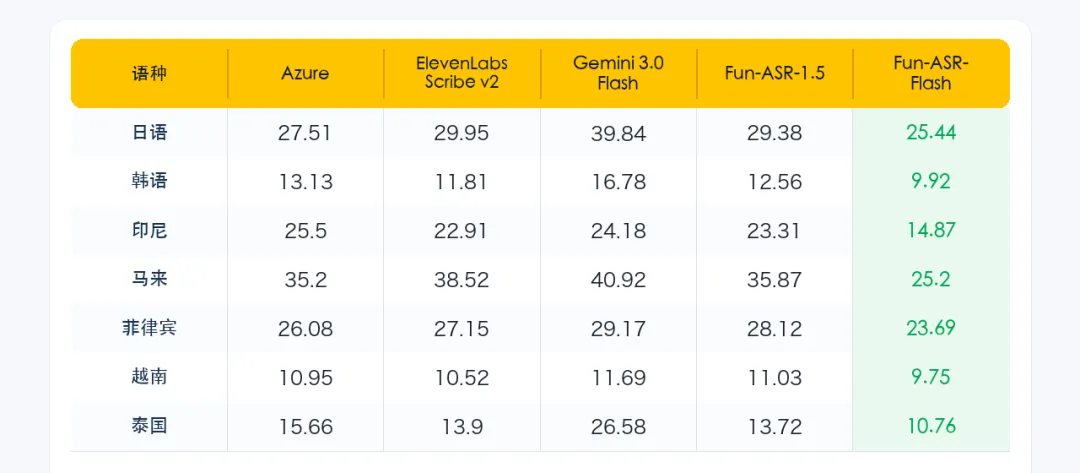
阿里推出的Fun-ASR-Flash语音识别模型支持三十种语言和十六种方言,准确率达到87.8%。该模型通过上下文和热词减少语义歧义,提升了对方言和小语种的识别能力,适用于复杂业务场景。
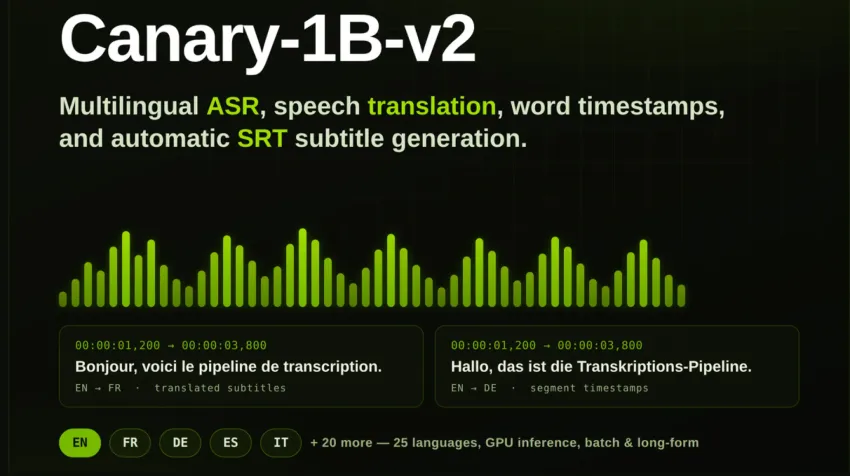
本文介绍了如何使用NVIDIA Canary-1B-v2构建多语言自动语音识别(ASR)和翻译工作流程,包括安装依赖项、加载模型、处理音频、执行英语转录和多语言翻译、生成时间戳及导出SRT字幕,最后测试长文本转录和批量处理以评估模型性能。
AI语音聊天机器人的实现依赖多个模块的协同,关键在于整体架构、流式串联、并行与预测、传输与端侧优化。通过优化各环节,端到端延迟可降低至700~900毫秒,接近真人对话速度。团队应明确延迟目标,利用成熟技术平台降低工程门槛,专注于对话逻辑创新。未来,随着技术进步,延迟有望进一步降低。
训练AI语音模型的关键在于优化而非从头训练。训练分为三层:ASR领域适配、LLM场景优化和TTS音色优化。ASR通过热词定制和选择合适模型提升准确率;LLM可通过提示工程、RAG和微调进行优化;TTS需选择合适音色和情感配置。建议先进行轻量优化,再考虑重型训练,以提高效率和效果。
选择AI语音平台时需考虑四层成本:ASR识别费、LLM推理费、TTS合成费和RTC传输费。不同场景下最佳组合不同。通过选择合适模型、利用免费额度、优化TTS合成和精简上下文等方式可降低费用。综合考虑各项成本,才能找到真正的低收费方案。
完成下面两步后,将自动完成登录并继续当前操作。